 AI-Papers
- MetaがMuseファミリー最小のモデル「Muse Ember」を発表し、発表と同日からAPIで提供を開始
- Intelligence Index v5はスコア36でMuse Spark 1.3の37に接近し、1タスク当たりのコストは2.39ドルから0.14ドルへ
- 入力は100万トークンまで対応し、テキストに加えて画像・音声・動画・PDFを受け付ける
最小モデルMuse Emberの概要
Metaは2026年11月9日(現地時間)、Museファミリーで最小かつ最も効率が高いモデルとして「Muse Ember」を発表しました。AIエージェントが同じ処理を何度も繰り返す場面を想定した設計で、発表と同日から利用できます。
想定用途として挙げられているのは、ツール呼び出し、プログラミング補助、情報抽出、長文ドキュメントの解析といった大量処理です。入力はテキストのほかに画像、音声、動画、PDFを受け付け、コンテキストウィンドウは最大100万トークン、最大出力は51万2000トークンとされています。
学習面では、10月に発表された同社最大のモデル「Muse Wonder Full」を使って学習させた初のモデルにあたります。大型モデルの能力を小型モデルへ引き継ぐ構成を採った点が、今回の位置づけを示しています。
コストは約17分の1
評価機関Artificial Analysisの計測では、総合的な知能を測るArtificial Analysis Intelligence Index v5でスコア36を記録しました。コーディングやエージェント処理を担う既存モデルMuse Spark 1.3の37に対して1ポイント下がるだけで、1タスク当たりのコストは大きく離れています。
指標 | Muse Ember | Muse Spark 1.3 |
|---|---|---|
Intelligence Index v5 | 36 | 37 |
1タスク当たりのコスト | 0.14ドル | 2.39ドル |
コスト差は約17分の1です。エージェントが同じ手順を数百回、数千回と反復するワークフローでは1タスクのコストがそのまま運用費に積み上がるため、スコアを1ポイント犠牲にしてコストを1桁下げる選択は現実的な設計判断になります。
エージェント性能の評価
業務自動化を測るAutomationBench-AAでは37.8%を記録しました。同じ小型クラスで比べると、Claude Haiku 5.5の13.9%に対しては2倍以上、GPT-6 Lunaの20.2%に対しては約1.9倍の差をつけています。
コーディング系では、ターミナル操作を評価するTerminal-Bench 4.0で40.9%でした。一方、複雑なソフトウェア開発を扱うFrontierCode 2.0-AAではClaude Haiku 5.5を下回っており、得意な領域と苦手な領域がはっきり分かれる結果になっています。長時間の設計判断を伴う開発タスクを丸ごと任せる用途には向かないとみられます。
Muse Wonderとの役割分担
Metaが示す使い方は、Muse Wonderが全体の計画を立て、Muse Emberが個々のプログラム修正や情報収集を実行する分担です。図1のように、計画側で1回だけ大型モデルを使い、反復が必要な実行部分を小型モデルに並列で担わせる形になります。
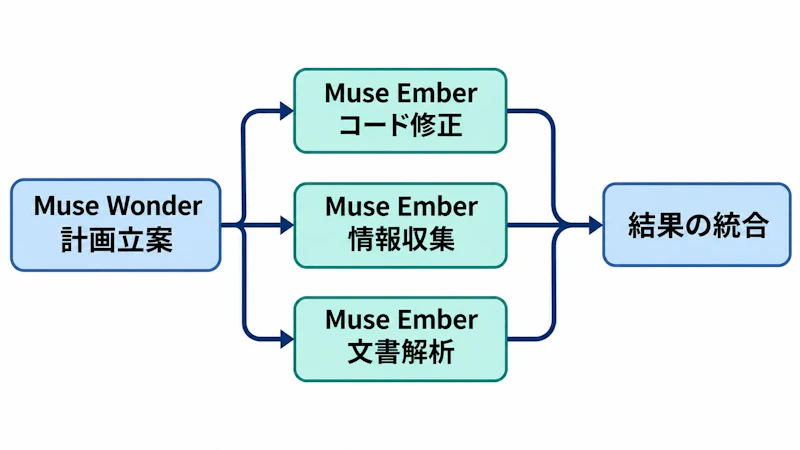
この構成では、精度が必要な判断と回数がかさむ作業を別のモデルに振り分けられます。実行側のコストが下がるほど、試行回数を増やす余地も広がります。
提供方法と価格
利用経路は複数用意されています。
- 開発者向けのMeta Model APIで
muse-ember-1.0として提供 - コーディングエージェントMuse Codeで利用可能(従量課金と全サブスクリプションプラン)
- Google CloudとOracle Cloud経由でも提供(Muse Spark、Muse Wonderと同様)
API料金は100万トークン当たり入力0.10ドル、出力0.50ドルです。キャッシュ済み入力は0.004ドルまで下がり、20万トークンを超える入力には別の料金体系が適用されます。一般消費者向けAIエージェント「Muse」への搭載時期は明らかにされていません。
小型モデル競争の現状
低価格帯のモデルは各社が相次いで投入しています。OpenAIは3月にGPT-5.4 nanoを、Googleは7月にGemini 3.5 Flash-Liteを、Anthropicは10月にClaude Haiku 5.5を発表しており、Muse Emberはこの層に加わる形になります。
スコアの絶対値だけでなく、タスク単位のコストと得意分野を照らし合わせる見方が必要になってきました。性能と費用のバランスからモデルを選ぶ考え方は、日本語LLM比較2026、LLM-jp・PLaMo・Swallowの性能と選び方でも整理しています。用途を絞った小型モデルの使い分けが、エージェント運用のコスト設計を左右する段階に入っています。


