 AI-Papers
- Sony AI などの研究者が画像生成AI14モデルの知的財産(IP)保護機構を1809件のプロンプトで検証した
- 商用11モデルの拒否率は Stability AI 系の約1%から Amazon Titan Image G2 の約50%まで開き、オープンウェイト3モデルは0%だった
- 14モデルすべてが10%以上の頻度で識別可能な既存IPを生成し、名前を伏せた間接プロンプトでも平均27〜28%で再現された
検証の概要
Sony AI などに所属する研究者らが、画像生成AIの知的財産(IP)保護機構、いわゆるガードレールの実効性を定量的に評価した技術レポートを公開しました。論文は「Evaluating Intellectual Property Guardrails of Generative Image Models: A Technical Report」(arXiv:2607.02582)として2026年7月に投稿されたもので、ITmedia NEWS が2026年11月9日に内容を報じています。
画像生成AIが既存のキャラクターや実在人物、企業ロゴを出力してしまう問題は以前から指摘されてきましたが、どのモデルがどの程度防げているのかを横断的に測った検証は少ないままでした。今回のレポートは、商用APIとオープンウェイトを並べて同一条件で比較した点に特徴があります。
14モデルの内訳
検証対象は商用11モデルとオープンウェイト3モデルの計14モデルです。商用モデルは5社のAPI経由で、Google の Imagen 3、Imagen 4、Nano Banana、OpenAI の DALL·E 3、GPT Image 1、Amazon の Nova Canvas、Titan Image G2、Runway の Gen-4 Image、Stability AI の Stable Image Ultra 1、Stable Image Core 1、Stable Diffusion 3.5 が含まれます。
オープンウェイト側は Stable Diffusion 3 Medium、FLUX.1-dev、PixArt-Sigma-XL-2-1024-MS の3モデルです。モデルの構造そのものを扱う研究(たとえばWeLM-Imageとは?MoTとMoEで31.7Bから5.4Bだけ動かす統合画像生成モデル)とは異なり、ここで測られるのは生成品質ではなく出力の制御可否です。
プロンプトと判定の手順
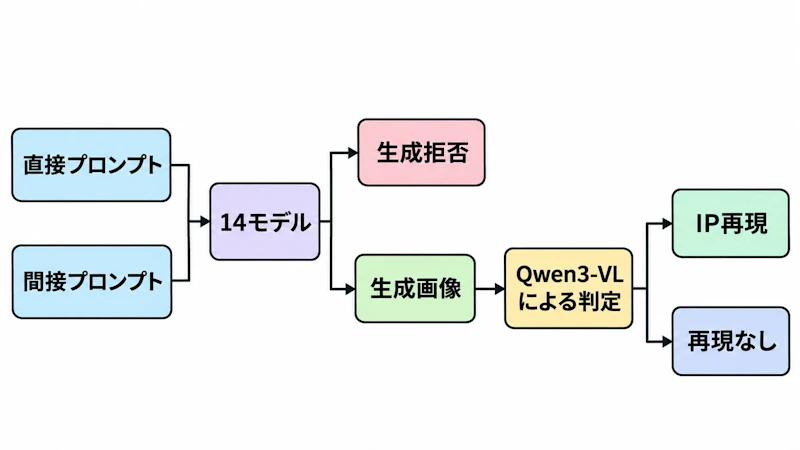
研究チームは実在の著名人、漫画・アニメのキャラクター、スーパーヒーローと悪役、ゲームのキャラクター、企業ロゴという5カテゴリで計201件のIPを選び、合計1809件のプロンプトを用意しました。プロンプトは対象を名前で直接指定するものと、名前を伏せて外見や特徴の語句だけで記述する間接的なものの2種類です。
生成された画像に識別可能なIPが含まれるかどうかの判定には、視覚言語モデルの Qwen3-VL を用いています。図1はこの評価の流れを示したものです。
拒否率は0%から約50%
商用11モデルはいずれも一部のプロンプトを拒否しましたが、その比率は提供元によって大きく異なりました。Stability AI のモデルが約1%にとどまる一方、Amazon の Titan Image G2 は約50%を拒否しています。オープンウェイトの3モデルは拒否率0%で、既定の状態ではIPを遮断する仕組みが働いていないことが示されました。
直接プロンプトに限れば、最も制限の強い Amazon と Runway のモデルは約80%を遮断しています。ただし名前を伏せた間接プロンプトでは拒否率が下がり、識別可能なIPが平均27〜28%の頻度で生成されました。主な数値は次の通りです。
条件 | 数値 |
|---|---|
オープンウェイト3モデルの拒否率 | 0% |
Stability AI 系商用モデルの拒否率 | 約1% |
Amazon Titan Image G2 の拒否率 | 約50% |
直接プロンプトの遮断率(Amazon・Runway) | 約80% |
間接プロンプトでのIP再現率(平均) | 約27〜28% |
各モデルのIP再現率の下限 | 10%以上 |
カテゴリ別の傾向
制限の強さはIPの種類によっても偏りがありました。最も緩かったのは企業ロゴで、多くのモデルは1〜2%しか遮断しておらず、Apple のロゴはしばしば生成されています。例外は DALL·E 3 で、24%を拒否しました。
逆に最も制限が強かったのはスーパーヒーローと悪役のカテゴリで、Amazon のモデルは半数超を遮断しています。実在の著名人は拒否率が低いほうから2番目でしたが、識別可能な容姿が生成された比率は5カテゴリ中で最も低く、拒否の有無と再現の成否が必ずしも一致しないことがうかがえます。
実務面で読み取れること
結果を通して見ると、ガードレールの厳しさはモデルとIPカテゴリの組み合わせで大きく変わり、どのモデルも識別可能なIPの生成を完全には防げていません。14モデル全てが10%以上の頻度でIPを再現し、ほぼ半数は40%を超えていました。
この数値は、生成AIを業務に組み込む際の著作権リスクが、モデルの選択だけでは解消しないことを示しています。オープンウェイトモデルは既定で保護が無い前提で扱う必要があり、制限の強い商用APIを選んだ場合でも、意図せず既存IPに似た出力が得られる可能性は残ります。


