AI-Papers
- Nejumi LeaderboardやOpen Japanese LLM Leaderboard(llm-jp-eval)など公開評価基盤の読み方を整理
- LLM-jp-4.1、PLaMo 2.0、Swallowなど学習アプローチが異なる国産LLMの特徴を比較
- 研究用途、オンプレ省メモリ、商用API運用など目的別にモデルを選ぶ基準を解説
国産LLMを評価する基盤
日本語に強い大規模言語モデル(Large Language Model: LLM)を検討するとき、まず頼りになるのが公開されている評価基盤です。代表的なものが、Weights & Biasesが運営するNejumi Leaderboardと、国立情報学研究所(NII)の大規模言語モデル研究開発センターが主導するllm-jp-eval(Open Japanese LLM Leaderboard)です。
どちらも日本語タスクでのモデル性能を数値化して公開していますが、評価の設計思想は異なります。Nejumi Leaderboardは実運用に近い対話品質まで含めて評価しようとする一方、llm-jp-evalは質問応答や要約、数学などの客観タスクを中心に、再現可能な形でスコアを積み上げる方向性です。どちらを見るかによって「性能が良い」の意味が変わる点は、比較記事を読むうえで押さえておきたいポイントです。
評価指標の読み方
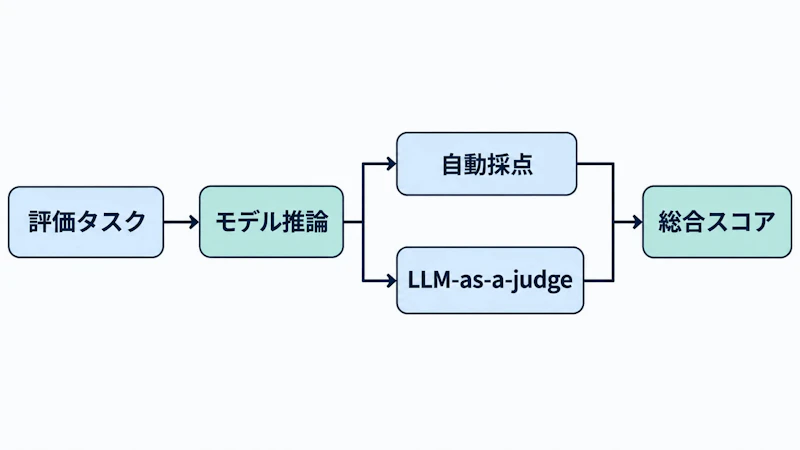
Nejumi系のリーダーボードは、おおむね2つの軸でモデルを採点します。1つは正解が一意に決まるタスクを自動採点する客観評価、もう1つは文章の自然さや指示への適合度を別のLLMに判定させるLLM-as-a-judge方式の主観評価です。前者は再現性が高い一方、知識や計算力に偏りやすく、後者は対話の質感を捉えやすい一方で判定役のモデルの好みが結果に影響するという弱点があります。
そのため、単一のスコアで「日本語最強」と断定するのは危険です。候補を絞り込む際は、自分のユースケースに近いタスク(要約、コード生成、対話など)の個別スコアまで見て、総合点だけに頼らないようにするのが実務的な読み方になります。
LLM-jp、ゼロから学習する国産勢
LLM-jpは、NIIを中心とした研究コミュニティが主体となって、モデルも学習データも一から公開する点が特徴のプロジェクトです。2026年9月に公開されたLLM-jp-4.1シリーズは、8.6B(Dense)、33B(Dense)、32B-A3B(Mixture of Experts: 専門家が分担して処理するMoE構成)という3サイズを用意し、いずれもApache License 2.0で提供されています。
前身のLLM-jp-4からは、STEM分野の学習データ拡充、外部ツールと連携するエージェント用途への対応、そして冗長だった回答を要点重視に改善した事後学習が加わりました。学習に使ったSFTデータやモデルごとのDPOデータまで公開しており、研究目的でモデルの挙動を検証したい場合やファインチューニングの出発点として使いたい場合に向いています。
PLaMo、効率重視の新構造
Preferred NetworksのPLaMo 2シリーズは、通常のTransformerではなく、状態空間モデル(Mamba2)とスライディングウィンドウ注意機構を組み合わせたSamba型のハイブリッド構造を採用しています。公開されている1Bモデルは合計4兆トークンで学習されており、学習後半のフェーズでは日本語データの比率を40%まで高めている点が特徴です。
この構造の利点は、長い文脈を扱うときの計算コストを抑えやすいことです。ライセンスはApache License 2.0で、公開されている1Bモデルはベースモデル(指示チューニング前の状態)として提供されているため、そのまま対話用途に使うには追加のチューニングが必要になります。省メモリ環境でのオンプレ運用や、長文を扱う独自アプリケーションへの組み込みを検討する際の選択肢になります。
Swallow、継続事前学習の強み
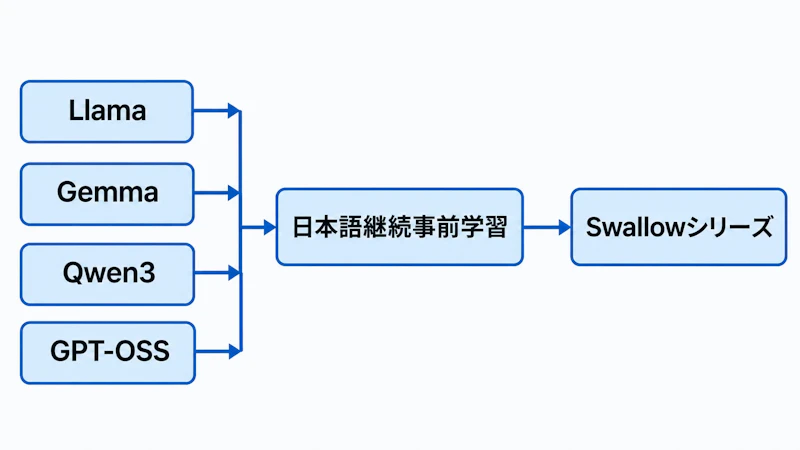
東京科学大学(旧東京工業大学)と産業技術総合研究所が中心となって進めるSwallowプロジェクトは、ゼロから学習するのではなく、既に高性能な海外の基盤モデルに日本語データで継続事前学習を施すアプローチです。Llama 3.3、Gemma 2、Qwen3、GPT-OSSといった複数のベースモデル系列それぞれに日本語強化版を用意しており、パラメータ規模も2BクラスからGPT-OSS Swallowの120Bまで幅広くそろっています。
2026年11月時点で公開モデル数は138、累計ダウンロード数は323万件に達しており、商用利用を前提にライセンス上の制約が少ないベースモデルを選んで日本語版を作る方針が取られています。ベースモデルの推論力や知識量をある程度引き継ぎつつ日本語応答の質を上げられるため、汎用的な性能を素早く確保したい場合に適した選択肢です。
軽量な商用モデルの動き
研究コミュニティ主導のモデル以外にも、企業が商用提供を前提に開発する国産LLMがあります。NVIDIAの軽量モデル系列をベースにした日本語対応版や、NTTが企業向けに提供するcotomiなどは、高速な応答と運用コストの低さを重視した設計になっており、コールセンターや社内業務の自動化といった実務システムへの組み込みを想定しています。
一方で、この領域では名前が挙がるものの、ベンチマーク結果や学習データの詳細が十分に公開されていないモデルも存在します。たとえばNamazuのように話題になる国産LLMの中には、公開評価基盤でのスコアが確認できず、比較表に落とし込めないケースがあります。導入を検討する際は、ベンダーの説明だけでなく、客観的な評価結果が公開されているかどうかを確認する姿勢が重要です。
主要モデル比較表
モデル | 開発主体 | 規模 | 学習アプローチ | ライセンス | 向いている用途 |
|---|---|---|---|---|---|
LLM-jp-4.1 | NII(LLM-jp) | 8.6B〜33B(Dense)/ 32B-A3B(MoE) | スクラッチ事前学習+公開SFT/DPO | Apache License 2.0 | 研究・検証、ファインチューニングの土台 |
PLaMo 2.0 | Preferred Networks | 1Bクラス(ハイブリッド構造) | スクラッチ事前学習(4Tトークン) | Apache License 2.0 | 省メモリ運用、長文処理の組み込み |
Swallow | 東京科学大学・産総研 | 2B〜120B(ベースモデル依存) | 既存基盤モデルへの日本語継続事前学習 | ベースモデル準拠(商用利用可能な系列を選定) | 汎用性能を素早く確保したい用途 |
Nemotron Nano JP系 | NVIDIA系 | 9Bクラス | 軽量化・継続学習 | 提供元ライセンスに準拠 | 低レイテンシ・エッジ推論 |
cotomi | NTT | 非公開 | 商用クローズド開発 | 商用API提供 | 企業向け業務システムへの組み込み |
用途別の選び方
研究目的やモデル内部の挙動を細かく調整したい場合は、学習データまで公開されているLLM-jp-4.1が出発点として扱いやすい選択です。省メモリ環境や長文処理を重視するオンプレミス用途ではPLaMo 2.0のハイブリッド構造が有利に働きます。
反対に、短期間で実用レベルの汎用性能を確保したいプロダクト開発では、ベースモデルの強みを引き継げるSwallow系列が現実的な選択肢になりやすいでしょう。社内の業務システムに組み込む用途で運用コストやサポート体制を重視するなら、cotomiのような商用クローズドモデルも検討対象になります。
なお、社内文書を検索しながら回答を生成するRAG(Retrieval-Augmented Generation: 検索拡張生成)用途で国産LLMを使う場合、生成側のモデル選定だけでなく検索精度を左右する埋め込みモデルの選定も同じくらい重要です。この点は埋め込みモデル比較2026、日本語RAGでの選び方をJMTEBスコアとAPI運用から解説で詳しく整理しています。
いずれのモデルを選ぶ場合も、公開ベンチマークのスコアだけで判断せず、実際の業務データに近いサンプルで試してから導入を決めることが、国産LLM選定の失敗を避ける近道になります。