 AI-Papers
- Ai2が2026年11月6日、ロボットアームとブロックを題材にしたオープンなシミュレーション基盤ToyBlocksを公開した
- テレオペ不要の生成器で85,336件の長期デモ(約1,600時間・1.44億フレーム)を作成し、単一GPUで最大24倍速の収集が可能
- 低レベル方策のManiFlowはシミュレーション80.0%に対し実機Franka FR3で81.1%、ワールドモデルのロールアウト追加で未知領域が19%から78%へ改善
ToyBlocksとは
Allen Institute for AI(Ai2)は2026年11月6日、ロボット学習向けのオープン基盤ToyBlocksをHugging Face上で公開しました。卓上に置かれたブロックとロボットアームという、要素を絞った環境に対象を限定しているのが特徴です。
Ai2はこれを「FoundationWorld」の第1弾と位置づけています。狙いは、データ量・タスク構成・評価条件を研究者側が統制できる場を用意し、ロボット学習の個別の問いを切り分けて検証できるようにすることにあります。実機だけで同じ検証をしようとすると、ハードウェアの差異や環境のばらつきが結果に混ざり、どの要因が性能を左右したのか判別しにくくなります。
公開物は環境アセット、手続き的なタスク生成器とデモ生成器、学習コード、検証セット、評価コード、そして学習済みモデル2種です。高レベルの視覚言語プランナーが allenai/Molmo2-4B-tb、低レベルの行動方策が allenai/maniflow-tb として提供されています。
テレオペ不要のデータ生成
ToyBlocksのデータは人間の遠隔操作(テレオペ)に頼らず、強化学習とモーションプランニングを組み合わせた生成器が自動で作ります。収録されている基本スキルはpick-and-place、push、flip、rotateで、把持を伴わない非把持操作も含みます。
長期タスクは積み上げ、取り崩し、ブロックで3文字の単語を並べる課題などで構成され、1件のデモがおよそ6から12のスキル実行にまたがります。こうして集まったのが85,336件、約1,600時間、1.44億フレームという規模です。単一GPUで数百の計画を並列実行し、実時間の最大24倍の速度でデータを生成できるとしています。追加のより大規模な公開も数週間後に予定されています。
評価側も作り込まれています。作業領域を空間的にずらしたケース、学習時に出てこない4ブロックの積み上げ、未知の文字・色・ブロック数といった汎化テストに加え、そもそも達成不可能な配置を与えて「このタスクは実行できない」と宣言させる課題も用意されています。
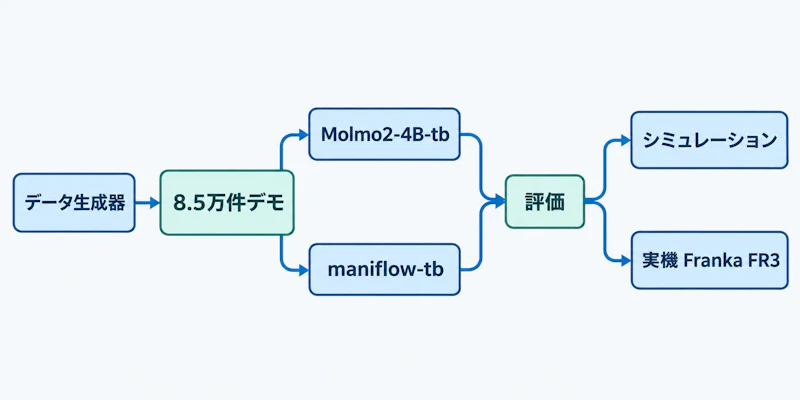
図1のように、生成されたデモは高レベルのプランナーと低レベルの方策の双方の学習に使われ、同一の評価系でシミュレーションと実機の双方に回されます。
実機への転移の結果
sim-to-real(シミュレーションで学んだ方策を実機に移すこと)の検証には、Robotiq製グリッパーを取り付けたFranka FR3が使われました。単体スキルを担うManiFlowは、シミュレーションと実機でほぼ同じ水準に収まっています。
評価対象 | シミュレーション | 実機 Franka FR3 |
|---|---|---|
ManiFlow(単体スキル) | 80.0% | 81.1% |
Molmo 2 + ManiFlow(階層) | 55.5%(111/200) | 50.0%(15/30) |
単体スキルでシミュレーションと実機の差がほとんど出ていない点は、この環境での学習結果が実機の挙動をある程度予測できることを示します。一方で、プランナーと方策を組み合わせた階層構成では成功率が5割前後に下がり、長期タスクの難しさが残ります。実機側の試行は30回と少なく、統計的な確からしさを得るにはさらに試行が必要だと著者らも断っています。
ワールドモデルの活用
ToyBlocksは動画生成系のワールドモデル(環境の次の状態を予測するモデル)の比較にも使われました。5BパラメータのWan 2.2がブロックの動きとタスク結果を最も正確に予測し、Astraはグリッパーの追跡は得意ながら接触の表現に弱く、LeWMは短い区間では速く正確でも軌道全体ではずれが蓄積したと報告されています。
実用面で目を引くのは、最良の動画モデルが生成したロールアウト100件を学習に足すだけで、未知の領域での方策の成功率が19%から78%へ上がった点です。動画モデルを実データの代替として使う試みはDreamXとは?動画拡散モデルを潜在アクション学習器に転用し人間の動作をロボットへ転移などでも進んでおり、ToyBlocksはその効果を統制された条件で測る土台になります。
タスク説明の書き方で差が出る
実行不可能な配置を含むsearch-and-spellでは、Claude Opus 5.5をエージェントとして動かし、タスク説明の与え方を比較しています。環境で実験させてエージェント自身に説明を書かせた場合が最も高い成功率になりました。
タスク説明の与え方 | 成功率 |
|---|---|
エージェントが実験して獲得した説明 | 63% |
専門家が記述した説明 | 36% |
既定の説明 | 24% |
人間の専門家が書いた説明より、エージェントが試行から得た説明のほうが27ポイント高い結果です。環境の挙動を言語化する作業自体を学習対象にする余地があることを示しています。
開発者が試せる範囲
コードはGitHub(allenai/ToyBlocks)、データセットとモデルはHugging Faceで配布され、ユーザーガイドも整備されています。ライセンス条件はブログ本文では明示されていないため、商用利用を検討する場合は各リポジトリの表記を確認する必要があります。
ロボット基盤モデルの研究では、データ量を増やすほど性能が伸びるのか、どの汎化軸が弱いのかといった問いに答えるための共通の実験場が不足していました。要素を絞ったToyBlocksは万能な実機代替ではありませんが、生成器から評価まで一式が揃っているため、手持ちの方策やワールドモデルを同じ条件で比較する用途にはすぐ使えます。


