AI-Papers
- 量子化はLLMのパラメータを低ビットに圧縮し、メモリ使用量を大幅に削減する技術
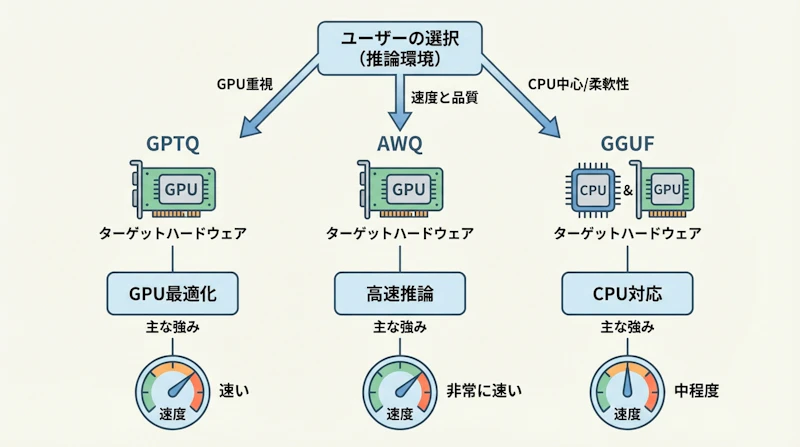
- GPTQ・AWQ・GGUFの3大手法はそれぞれGPU最適化・高速推論・CPU対応と得意分野が異なる
- 自分のハードウェア環境と用途に合わせて最適な量子化手法を選ぶことが実用化の鍵
LLMの量子化とは?なぜ今注目されているのか
LLM(大規模言語モデル)の進化は目覚ましいものがありますが、モデルサイズの巨大化という課題が常に付きまといます。たとえば、700億パラメータのモデルをFP16(半精度浮動小数点)で動かすには約140GBのVRAMが求められます。一般的なゲーミングGPUのVRAMは8〜24GB程度ですから、こうした大規模モデルを個人環境で動かすのは到底現実的ではありません。
そこで登場するのが量子化(Quantization)という技術です。量子化とは、モデルの重み(パラメータ)をFP16やFP32といった高精度の数値表現から、INT8やINT4のような低ビットの整数表現に変換する手法を指します。これにより、モデルのメモリ使用量を劇的に削減しつつ、推論品質をできるだけ維持することが可能になっています。
近年、GLM-5のような744Bパラメータを持つオープンソースモデルが続々と登場する中、量子化はローカルLLMを実用化するための必須技術として注目を集めています。本記事では、代表的な3つの量子化手法——GPTQ・AWQ・GGUF——の仕組みと違い、そして環境に応じた選び方を解説します。
量子化の基本的な仕組み — FP16からINT4へ
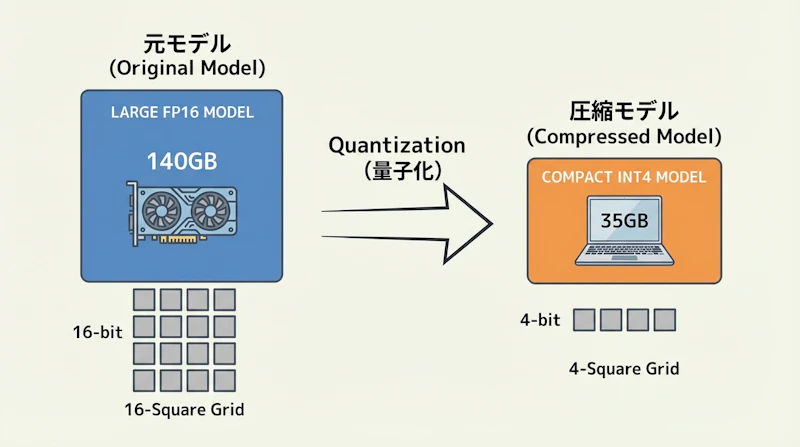
量子化の基本的な考え方はシンプルです。通常、LLMの重みはFP16(16ビット浮動小数点)で保存されています。1つの重みに16ビットを使うということは、700億個のパラメータがあれば合計で約140GBのメモリを消費する計算になります。
これを4ビット整数(INT4)に変換すると、理論上はメモリ使用量を約4分の1に圧縮できます。140GBのモデルが約35GBまで縮小されるため、24GBのVRAMを搭載したRTX 4090でも部分的にGPUにロードして実行できるようになるわけです。
もちろん、ビット数を減らせば情報の精度は低下します。しかし、最新の量子化手法では「どの重みが出力に大きく影響するか」を分析し、重要な重みの精度を優先的に保つ工夫がなされています。実際のベンチマークでは、4ビット量子化モデルのPerplexity(言語モデルの品質指標)はFP16ベースラインと比べて2〜3%程度の劣化にとどまることが確認されており、実用上はほとんど差を感じない水準が実現されています。
3大量子化手法の特徴と違い
GPTQ — GPU特化の王道手法
GPTQ(Post-Training Quantization for GPT)は、LLMの量子化技術として最初に広く普及した手法です。学習済みモデルの重みを1つずつ4ビットに圧縮し、各ステップで生じる誤差を後続の重みに反映させることで、全体の精度劣化を最小限に抑えるアプローチを取っています。
GPTQの最大の特徴は、GPU推論に最適化されている点にあります。Marlinカーネルと組み合わせた場合、FP16ベースラインを上回るスループットを記録するケースもあり、あるベンチマークではFP16の461トークン/秒に対してMarlin-GPTQが712トークン/秒を達成しました。HuggingFace上で最も多くの量子化モデルが公開されているフォーマットでもあり、導入のハードルが低い点も魅力と言えます。
AWQ — 活性値を考慮した次世代手法
AWQ(Activation-aware Weight Quantization)は、GPTQの後に登場した比較的新しい手法です。その最大の革新は、「すべての重みが等しく重要ではない」という前提に立つ点にあります。
AWQは推論時の活性値(Activation)のパターンを分析し、出力に大きく影響する重要な重みを特定して優先的に精度を保持します。結果として、GPTQと同等以上の精度を維持しながら、推論速度で上回る性能を発揮することが可能になっています。Marlin-AWQの構成では741トークン/秒というスループットを記録し、インタートークンレイテンシも12.6ミリ秒と、ベンチマーク全体で最速クラスの結果を残しています。
GGUF — CPU実行を可能にするファイルフォーマット
GGUF(GPT-Generated Unified Format)は、厳密には量子化アルゴリズムそのものではなく、量子化されたモデルを格納するためのファイルフォーマットです。llama.cppプロジェクトから生まれたGGML(GPT-Generated Model Language)ライブラリと連携し、CPUベースでのLLM実行を可能にした点が画期的でした。
GGUFの大きな強みは、Q4_K_M、Q5_K_S、IQ3_Sといった多様な量子化レベルを選択できる柔軟性にあります。さらに、gpu_layersパラメータを指定することで一部のレイヤーだけをGPUにオフロードするハイブリッド実行にも対応しており、VRAMが限られた環境でもGPUの恩恵を部分的に受けられる仕組みが整っています。Apple Siliconとの相性も良く、MacBookでLLMを動かしたいユーザーにとって第一選択肢となる形式が挙げられます。
GPTQ・AWQ・GGUFを徹底比較
比較項目 | GPTQ | AWQ | GGUF |
|---|---|---|---|
主なターゲット | GPU推論 | GPU高速推論 | CPU / Apple Silicon |
量子化方式 | 重み逐次圧縮 | 活性値考慮の重み圧縮 | ブロック単位量子化(複数方式) |
推論速度(GPU) | 高速(Marlin対応で最適化) | 最速クラス | vLLMでは低速(llama.cpp推奨) |
推論速度(CPU) | 非対応 | 非対応 | ネイティブ対応 |
精度維持 | 良好 | 良好〜優秀 | 方式により異なる |
柔軟性 | 4ビット固定が主流 | 4ビット固定が主流 | Q3〜Q8まで選択可能 |
エコシステム | HuggingFace上で最多 | vLLM・HuggingFaceで拡大中 | llama.cpp・Ollamaが中心 |
導入の容易さ | 容易 | 容易 | 非常に容易(Ollama利用時) |
ベンチマークデータを見ると、GPU環境ではAWQとGPTQがMarlinカーネルとの組み合わせで圧倒的な性能を示します。一方、Perplexityの比較ではGGUF(Q4_K_M)が6.74とFP16ベースライン(6.56)に近い値を記録しており、品質面での健闘が目立ちます。コード生成タスク(HumanEval)ではAWQとGGUFが51.8%と同等のPass@1を達成し、GPTQ単体は46%前後とやや劣る結果も報告されています。
用途別・環境別の選び方ガイド
ハイエンドGPU環境(RTX 4090、A100など)の場合
24GB以上のVRAMを搭載したハイエンドGPUをお持ちであれば、まずAWQモデルの採用を検討してみてください。Marlinカーネルと組み合わせることで、FP16を超えるスループットと低レイテンシを両立できます。本番環境でのサービング用途にも十分対応可能な性能が得られます。
ミドルレンジGPU環境(RTX 3060〜4070)の場合
8〜12GBのVRAMを搭載したミドルレンジGPUの場合、GPTQも有力な選択肢になります。HuggingFace上に豊富なモデルが公開されているため、試したいモデルのGPTQ版がすぐ見つかる利便性は大きなメリットです。VRAMに余裕がない場合は、GGUFフォーマットでGPUレイヤーの一部だけをオフロードするハイブリッド構成も検討に値します。
GPUなし・CPU環境の場合
専用GPUを持っていない環境やMacBookで手軽にLLMを試したい場合、GGUFフォーマット一択と考えて問題ありません。Ollamaを使えば、コマンド一つでモデルのダウンロードから実行まで完結します。Q4_K_Mが品質とサイズのバランスが良く、最初のフォーマットとして推奨されています。より高い圧縮率を求める場合はIQ3_Sなどの最新i-quant形式も試してみる価値があるでしょう。
どの手法を選ぶか迷った場合は、同じモデルの異なる量子化版をダウンロードして実際に試すのが最も確実なアプローチです。量子化フォーマットの変換・共有が活発に行われているHuggingFaceコミュニティを活用すれば、比較検証も容易に行えます。
まとめ — 量子化でローカルLLMを始めよう
LLMの量子化は、かつては研究者だけのものだった大規模言語モデルを、個人のPCやノートパソコンで動かせるようにした革新的な技術です。GPTQ・AWQ・GGUFという3つの主要手法はそれぞれ異なる強みを持っており、自分のハードウェア環境と目的に合わせて最適なものを選ぶことが重要になります。
GPU環境での最速推論ならAWQ、豊富なエコシステムと安定性ならGPTQ、CPU実行や柔軟な量子化レベル選択ならGGUF——この基本方針を押さえておけば、選択で大きく外すことはないはずです。ローカルLLMの民主化が進む今、量子化技術を理解して活用することは、AI活用の幅を大きく広げる第一歩と言えるのではないでしょうか。