 AI-Papers
- llama.cpp と ggml が 2026年11月13日に初のメジャーリリース v1.0.0 を公開し、libllama と libggml の公開 C API が安定版として扱われるようになりました
- 今後は公開 C API の破壊的変更をメジャー番号の更新で明示する運用に切り替わり、下流の開発者が互換性を判断しやすくなります
- 150 を超えるアーキテクチャ変種に対応し、バックエンドは動的ライブラリとして実行時に読み込める構成になっています
3年半を経た初の正式版
ローカルでの大規模言語モデル(Large Language Model、LLM)推論を支えてきた llama.cpp と、その基盤となるテンソル演算ライブラリ ggml が、バージョン 1.0.0 を公開しました。Hugging Face 上の発表記事は Daniel Bevenius 氏によるもので、公開日は 2026年11月13日です。
発表では、プロジェクト開始から 3年半が経過したことに触れつつ、今回のリリースの狙いを下流の開発者に向けた安定 API の提供だと説明しています。llama.cpp は幅広いハードウェアでマルチモーダルな LLM を動かせる点が特徴で、クロスプラットフォームかつプライバシーを重視した製品の土台として位置づけられています。
Ollama や LM Studio のように、llama.cpp や ggml を内部で利用するツールは広く使われています。基盤側のインターフェースが安定するかどうかは、こうした製品の更新コストに直接関わります。
バージョン番号の付け方
対象となるのは、llama.cpp 側の libllama(ヘッダは include/)と、ggml 側の libggml(ヘッダは ggml/include/)です。発表記事では、ggml-org のプロジェクト全体に適用されるセマンティックバージョニングの規則が示されました。
更新箇所 | 意味 |
|---|---|
MAJOR |
|
MINOR | 後方互換の機能追加、バックエンド更新、モデル対応、API 追加 |
PATCH | API 変更を伴わないバグ修正 |
これまでは日付ベースのビルド番号で更新が進んでおり、どの変更が自分のコードを壊すのかを利用者側が差分から読み取る必要がありました。今後は API と ABI の非互換がメジャー番号に現れるため、依存バージョンの固定や更新の判断がしやすくなります。発表記事は、採用が広がるにつれてこの境界をより厳格に扱う方針も示しています。
なお、規則が対象としているのは ./include 配下の公開 C API です。コマンドラインツールの名前や引数が同じ保証の対象かどうかについては、記事中で言及されていません。
対応モデルとバックエンド
モデル面では、150 を超えるアーキテクチャ変種に対応し、主要な投機的デコーディング(小さなモデルで先に候補を生成し、大きなモデルで検証して高速化する手法)をすべてサポートするとしています。
ハードウェア面では、ggml が専用バックエンドを通じてほぼあらゆる環境で動作すると説明されています。各バックエンドは動的ライブラリとしてコンパイルでき、実行時に任意で読み込める構成です。1 つのバイナリを配布しつつ、実行環境にある演算器に合わせて読み込むライブラリを切り替えられるため、配布の手間を抑えられます。
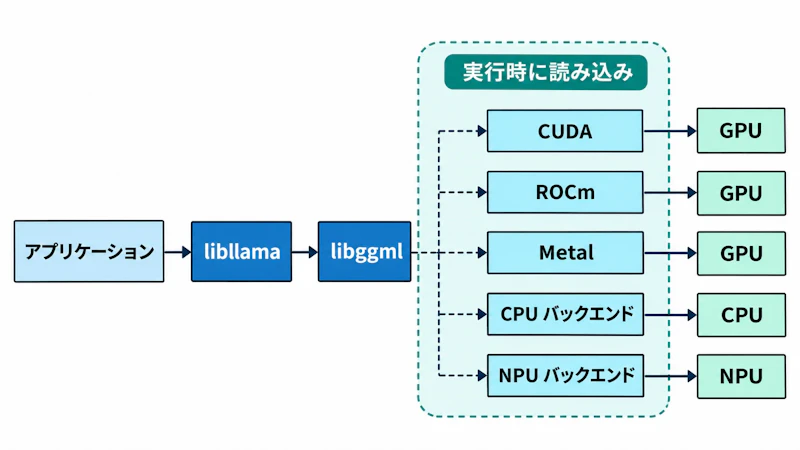
図1 のように、アプリケーションは libllama と libggml を介して、実行時に選ばれたバックエンド経由でハードウェアを利用します。バックエンドの整備には NVIDIA、AMD、Qualcomm、Arm、IBM、Intel 各社からのハードウェア提供が寄与しており、セルフホストの CI ランナー拡充にも使われているとのことです。
配布チャネルと開発体制
v1.0.0 の提供経路は、プラットフォームごとに整理されています。
- ビルド済み配布物: Linux、macOS、Windows、Android、iOS
- Docker、Debian パッケージ: Linux
- Homebrew: macOS、Linux
- conda-forge: Windows、macOS、Linux
- MacPorts、Winget: 各 macOS、Windows
- XCFramework: iOS、macOS
モバイル向けは Android と iOS のビルド済み配布物、および iOS と macOS 向け XCFramework が中心です。加えて、llama.cpp と Hugging Face のチームが macOS 版と Windows 版のデスクトップアプリを開発していることも紹介されています。
開発プロセスについては、LLM を開発サイクルに取り入れつつ、コードベースの品質、アーキテクチャの制御、実装の詳細の理解を優先すると述べています。CI は Hugging Face の Buckets と Jobs を使って拡張し、master ブランチに入るすべての変更を検証する体制です。
開発者への影響
サーバー側で高スループットを狙う用途では vLLM や SGLang などが選ばれる一方、llama.cpp は端末内やオンプレミスでの推論という別の領域を担ってきました。用途ごとの選び分けについてはLLM推論エンジン比較2026、vLLM・SGLang・TensorRT-LLMの違いと選び方も参考になります。
今回の 1.0.0 は、性能が大きく変わる類のリリースではありません。価値があるのは、組み込み機器やモバイルアプリに llama.cpp を埋め込む開発者が、API の変更時期を番号から判断できるようになった点です。発表記事は今後の方針として、配布手段の拡充、全モデルアーキテクチャの継続サポート、バージョン境界の厳格な維持を挙げています。


