 AI-Papers
- Googleがエージェント用途の常用機として Gemini 4 Hydrogen を公開し、既定設定で Gemini 3.8 Flash 比約2.5倍の速度を示した
- 新思考モード xhigh で Artificial Analysis Intelligence Index 54 を記録し、上位の Gemini 4 Argon(50)を上回った
- 入出力それぞれ100万トークンに対応し、料金は入力100万トークンあたり1.50ドル、出力7.50ドルの定額制
Gemini 4 Hydrogenとは
Google は Gemini 4 ファミリーの新モデル「Gemini 4 Hydrogen」を公開しました。同社は Gemini 4 Carbon と Gemini 4 Argon を長い手順を要する深い推論向けのフロンティアモデルと位置づけており、Hydrogen はその下で日常的なコーディングやエージェント処理を回す「常用機」にあたります。
ここでいうエージェントとは、モデルがツールを呼び出しながら複数の手順を自律的に進める使い方を指します。常用機という位置づけが意味するのは、1回あたりの賢さを極限まで追うのではなく、多数の呼び出しを安定した速度と費用でさばく設計です。
前世代の軽量モデルである Gemini 3.8 Flash との比較では、既定設定でタスク完了までの時間が約2.5倍短縮されたとしています。Google がパートナー企業と実施したグラフ処理、SQL、データ量の多い業務ワークフローの検証では、処理速度が2倍から2.8倍、トークン消費が12%から23%低下したと報告されています。
新思考モード「xhigh」
Hydrogen は思考量を low、medium、high、xhigh の4段階で指定できます。high が既定値で、xhigh は今回追加された最上位の設定です。思考量を上げるほど内部で検討に使う計算量が増え、応答までの時間と費用も増えます。
Artificial Analysis が公開する知能指数(Artificial Analysis Intelligence Index)では、high 設定で51、xhigh 設定で54を記録しました。上位モデルである Gemini 4 Argon の50を既定設定の時点で上回っており、軽量枠と上位枠の線引きが性能面では単純でなくなっています。
もっとも、この指数は複数ベンチマークの集約値であり、長い手順の計画立案や並列エージェントの統括といった用途では Carbon や Argon が優位とされています。指数の数字だけでモデルを選ぶのではなく、タスクの長さと分岐の多さで使い分ける前提は変わりません。
コーディングとエージェント性能
ターミナル操作を伴う実務的なタスクを測る Terminal-Bench 4.1 では57%を記録し、Gemini 3.8 Flash の18.2%から大きく伸びました。学術的な難問を集めた HLE-Diamond では58.8%、税務エージェントを評価する Vals Tax Agent Bench では52.3%で首位、Vals Legal Research Bench では55.8%で首位タイとしています。
評価項目 | Gemini 4 Hydrogen | 比較対象 |
|---|---|---|
知能指数(high/xhigh) | 51/54 | Argon 50 |
Terminal-Bench 4.1 | 57% | 3.8 Flash 18.2% |
HLE-Diamond | 58.8% | 同クラス首位 |
Vals Tax Agent Bench | 52.3% | 首位 |
Agents' Last Exam v1.1 | 71.6% | 同クラス上位 |
このほか Multimodal Knowledge Agent で53.4%、Agent Arena で5位という結果も示されました。Google は事実と異なる主張の発生が 3.8 Flash 比で5分の1以下に減ったとしており、エージェントの途中経過を人が検証しにくい用途での扱いやすさを強調しています。
Antigravityでの役割分担
開発環境 Antigravity では、複数モデルを組み合わせる使い方が示されました。Carbon が並列エージェントの統括役を担い、Hydrogen が実作業を行うワーカーと結果を点検するベリファイアとして動く構成です。
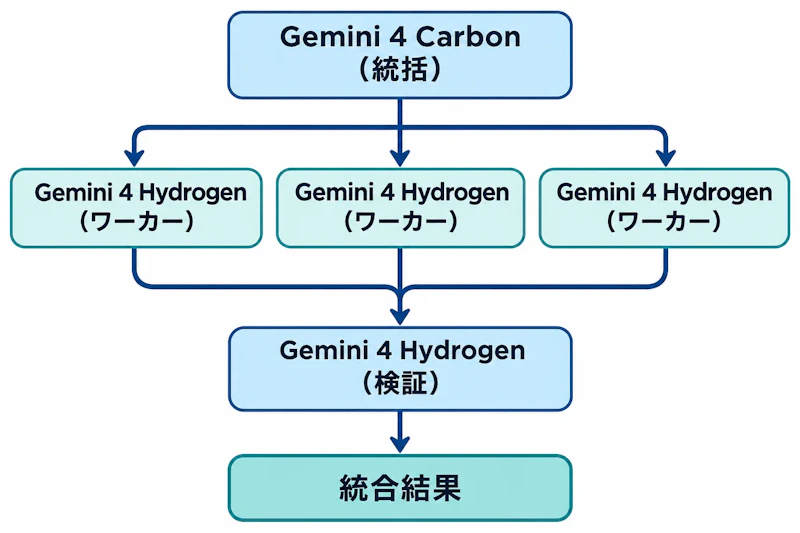
図1のように役割を分けた構成では、Terminal-Bench 4.0 のタスク成功率が Carbon 単独に近い水準に達しながら、消費クォータが24%少なく、完了までの時間が平均19%短くなったとしています。高価なモデルを統括だけに使い、量をこなす部分を安価なモデルに任せる設計が、実測値として効果を示した形です。
こうした階層構成は、判断の軽重に応じて処理を振り分ける発想としてGoogleがGemini Decisions APIを公開、判断処理を150msでコスト5分の1にと同じ方向にあります。
料金と提供範囲
コンテキスト長は入力100万トークン、出力も最大100万トークンに対応します。料金は入力100万トークンあたり1.50ドル、出力100万トークンあたり7.50ドルで、コンテキスト長に応じた段階的な値上げがない定額制です。長文を扱うと単価が上がる課金方式では費用見積もりが難しくなるため、エージェントのように入力量が読みにくい用途では扱いやすい設定といえます。
提供先は次のとおりです。
- Google AI Studio、Gemini API、Android Studio
- Antigravity(Google AI Pro および Ultra の有料契約者)
- Gemini for business(API とモデル選択の両方)
- Gemini アプリのモデル選択(無料利用者は自動選択経由)
- Google 検索(全世界の全利用者)
- Gemini in Google Sheets(AI Pro および Ultra から順次)
Google Sheets のキャンバス機能では、従来モデルより30%以上速く出力を生成するとしています。検索への全世界展開まで含むため、開発者向けの新モデルという枠を超えて利用規模は大きくなる見込みです。
安全性に関する主張
Google は社内評価の結果として、エージェントタスクにおける過剰な介入が最大81%減、必要な作業をしない取りこぼしが最大79%減としています。ツール利用とコーディングの評価では、意図から外れた操作や手順の省略が12分の1に減り、正直さの指標は96.7%だったと説明しています。
外部データに仕込まれた指示にモデルが従ってしまう間接プロンプトインジェクションについては、Gray Swan の IPI ベンチマークで2.3倍以上の耐性を示したとしています。医療分野の HealthBench Pro での誤った拒否は0.4%未満です。これらは Google 自身の測定値であり、第三者による再現結果が出るまでは参考値として扱う必要があります。
速度と費用を軸にした軽量モデルが上位モデルの知能指数を既定設定で上回るという今回の結果は、モデル選択の基準を「最も賢いものを1つ選ぶ」から「役割ごとに組み合わせる」へ移す動きを後押しします。実際の判断では、ベンチマークの数字に加えて、自社のワークフローでのトークン消費と失敗時のやり直し費用を測ることが要点になります。


