 AI-Papers
- GoogleがGeminiに社内開発データ1兆トークンを追加学習させた社内専用モデル「Gemini for Google(GfG)」の論文を公開しました
- 開発者2万9000人のブラインドA/Bテストで、やり取り回数23.1%減、コード生存率16.8%向上を記録しています
- 広告部門の32ビットから64ビットへの移行作業では所要時間が推定50%削減され、変更の80%をAIが作成しました
GfGとは何か
Googleなどの研究者18名が、社内のソフトウェア開発に特化させた大規模言語モデル(Large Language Model、LLM)の構築手法をまとめた論文「Customizing an LLM for Enterprise Software Engineering」を発表しました。2026年10月に開催された第41回IEEE/ACM国際自動ソフトウェア工学会議(ASE '26)で報告されたもので、対象となるモデルはGemini for Google(GfG)と呼ばれています。
背景にあるのは、公開データで学習した汎用モデルの限界です。Googleの社内リポジトリは数十億行規模にのぼり、独自のライブラリや設計パターン、社内でしか使われない言語が多数含まれます。汎用のGeminiではこうした固有の作法に追従しきれず、生成されたコードが修正や破棄の対象になりやすいという課題がありました。
同社ではすでにコードの75%以上がAIによって作成または下書きされているとされ、生成品質の差が開発全体の生産性に直結する状況にあります。
1兆トークンの学習データ
GfGの学習には、完成したコードだけでなく開発プロセスそのものから集めた1兆トークン規模のデータが使われました。内訳は次の通りです。
- コードレビューでの指摘と、それに対応した修正前後の差分
- 社内ドキュメントおよびQ&Aのやり取り
- ビルドエラーが解消されるまでの変更履歴
- 本番環境の改善履歴と操作ログ
- IDE上で自然言語により指示されたコード修正のログ
注目されるのは、失敗から成功に至る過程が学習対象に含まれている点です。エラーを修復する手順やレビューで指摘される典型的な問題を学ぶことで、完成品のコードだけを与えるより実務的な振る舞いに近づくと考えられます。
破滅的忘却を防ぐ手法
大量の社内データを後から学習させると、元の汎用的な推論能力が失われる破滅的忘却が起きやすくなります。研究チームはこれを避けるため、2つの工夫を組み合わせました。
1つは中間学習介入で、事前学習が完了する直前のタイミングで社内データを注入します。もう1つはデータリプレイで、社内データに元の汎用データを混ぜて再学習させる方法です。両者を併用することで、基礎的な推論力を保ちながら社内知識を定着させています。
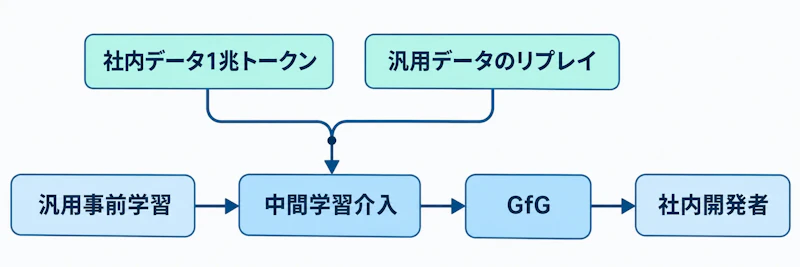
図1のように、社内データと汎用データを同じ段階で合流させる構成が、特化と汎用性の両立を支える要になっています。
2.9万人のブラインド比較
効果検証は、社内開発者2万9000人を対象としたブラインドA/Bテストで行われました。比較対象は汎用のGemini 2.5 Proです。
指標 | GfGの変化(Gemini 2.5 Pro比) |
|---|---|
タスク完了までのやり取り回数 | 23.1%減少 |
応答時間 | 8.9%短縮 |
コード生存率(14日後) | 16.8%向上 |
コード生存率は、AIが生成したコード行が14日後も修正されずに残っている割合を指します。受け入れ率のような一時的な指標ではなく、実際に使い続けられたかを測る指標で改善が確認された点に意味があります。やり取り回数の減少も、指示を出し直す手間が減ったことを示しています。
実務で測った効果
個別の事例でも成果が報告されています。広告部門で実施された32ビットIDから64ビット整数への移行では、手作業と比べて所要時間が推定50%削減され、提出された変更リストのコード変更の80%をAIが作成しました。社内固有の型やライブラリが絡む大規模な機械的改修は、特化モデルが力を発揮しやすい領域といえます。
関連する社内システムの成果も挙げられています。非効率なコードを自動検出して最適化するECOは四半期ごとにCPU約50万コア相当の計算資源を節約し、貼り付け先の文脈に合わせてコードを自動調整するSmart Pasteは社内で新たに書かれるコード全体の1%以上を占めるまでになりました。
自社特化への示唆
この報告が示すのは、独自の資産を抱える組織では汎用モデルをそのまま使うより、開発プロセスの履歴を学習データに変える方が効果が大きい場合があるという点です。レビューの差分やビルドエラーの修復履歴は多くの企業にも蓄積されており、データ源としての汎用性があります。
一方で、1兆トークン規模の学習や中間学習への介入は、基盤モデルの学習過程に手を入れられる立場でなければ再現が難しい部分も残ります。Gemini 4 Hydrogenのような最新の汎用モデルが能力を伸ばし続ける中で、どこまで自社特化に投資するかは、保有データの性質と改修対象の規模を踏まえた判断になるでしょう。


