AI-Papers
- vLLM は PagedAttention と動的バッチ化でスループットと応答性のバランスが良く、迷ったときの既定解になりやすい選択肢です
- SGLang は RadixAttention による接頭辞の再利用が強みで、共通プロンプトやエージェント用途で効きますが、初回応答までの時間は伸びやすい傾向があります
- TensorRT-LLM は事前コンパイルで生成中のレイテンシが安定する一方、ビルド設定を外すと初回応答が一気に悪化します
推論エンジンとは何か
オープンな大規模言語モデル(Large Language Model: LLM)を自社で動かすと決めた瞬間、必ずぶつかるのが「何で動かすか」という問題です。Hugging Face の transformers でそのまま動かすこともできますが、同時に何十人、何百人がアクセスする本番環境では、GPU がほとんど遊んでいるのに応答が遅いという状態に陥ります。
この隙間を埋めるのが推論エンジン(推論サーバー)です。やっていることは大きく2つあります。1つは KV キャッシュの管理で、生成済みトークンの Key/Value を無駄なく GPU メモリに置くこと。もう1つはバッチ処理のスケジューリングで、長さの違うリクエストを効率よく束ねて GPU を埋め続けることです。
KV キャッシュがどれほど厄介かというと、vLLM の開発チームは LLaMA-13B で1系列あたり最大 1.7GB に達すると報告しています。しかも生成が何トークンで終わるかは事前に分からないため、従来のシステムは最大長を見込んで確保してしまい、メモリの 60〜80% を断片化と過剰確保で捨てていたとされます。この無駄をどう削るかが、各エンジンの設計の分かれ目です。
4つのエンジンの設計思想
vLLM、仮想メモリの発想を持ち込む
vLLM の中核は PagedAttention です。OS の仮想メモリとページングをそのまま KV キャッシュに適用した仕組みで、各系列のキャッシュを固定サイズのブロックに切り分け、ブロックテーブルで論理ブロックと物理ブロックを対応づけます。
ブロックが GPU メモリ上で連続していなくてよいので、必要になった分だけ確保できます。無駄が出るのは最後のブロックだけで、公式ブログでは 4% 未満とされています。同じプロンプトから複数の出力を取る並列サンプリングでは物理ブロックを共有し、参照カウントとコピーオンライトで安全に扱うため、メモリ使用量を最大 55% 削減できると報告されています。
この空いたメモリで同時に処理できる系列数が増え、結果として Hugging Face Transformers 比で最大 24 倍、Text Generation Inference(TGI)比で最大 3.5 倍のスループットが出たとされています。導入の手軽さも3つのエンジンの中では最も良好です。
SGLang、プロンプトの先頭を使い回す
SGLang が狙うのは別の無駄です。実運用のプロンプトは、長い共通システムプロンプト、few-shot 例、会話履歴、RAG のテンプレートなど、先頭部分が丸ごと同じというケースが非常に多くあります。従来のエンジンはリクエストが終わると KV キャッシュを捨ててしまうため、次のリクエストで同じ先頭をもう一度計算し直していました。
RadixAttention は、生成後の KV キャッシュを破棄せず基数木(radix tree)に保持します。キーがトークン列、値が対応する KV テンソルで、木構造は CPU 側、テンソルは GPU 側のページレイアウトに置かれます。新しいリクエストが来ると最長一致する接頭辞を探して再利用し、GPU メモリが足りなくなれば葉ノードから LRU で追い出します。
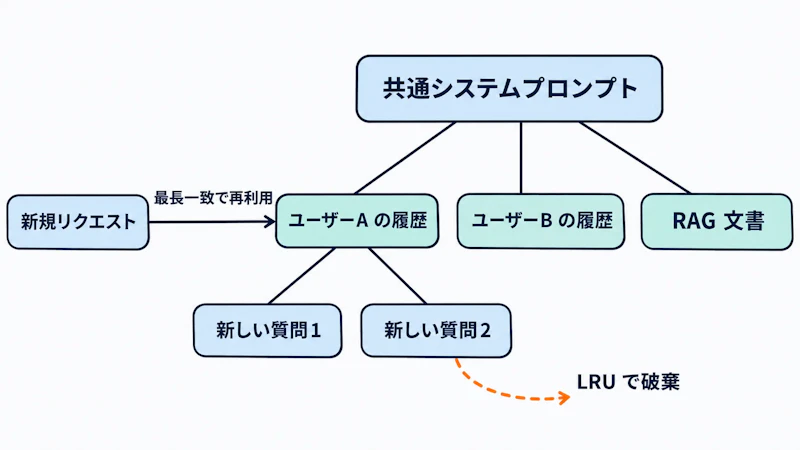
図1のように共通部分が1ノードに集約されるので、キャッシュが当たったときの初回応答は大幅に短縮されます。LMSYS の報告では、vLLM v0.2.5、Guidance、TGI といったベースラインに対して最大5倍のスループットを達成したとされ、キャッシュが当たらない場合のオーバーヘッドはほぼ無いため常時有効になっています。
TensorRT-LLM、先にコンパイルする
TensorRT-LLM は発想が根本的に違います。vLLM と SGLang が「サーバー先行」なのに対し、こちらは「エンジン先行」です。Hugging Face のモデルを変換して TensorRT エンジンにコンパイルし、最大バッチサイズ、最大入力長、最大トークン数といったパラメータをビルド時に固定します。
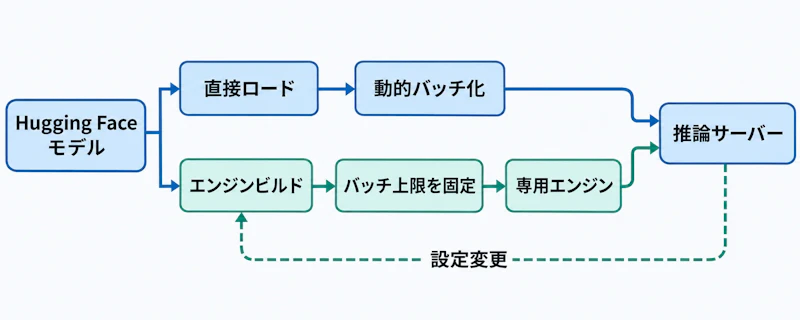
実行時には in-flight batching(インフライトバッチング)でコンテキスト処理と生成処理をまとめて動的にスケジュールします。量子化では H100 以降の FP8 で性能2倍・メモリ半減、B200 では FP4 のネイティブ対応と、NVIDIA ハードウェアに密着した最適化が使えます。
裏返すと、図2の破線が示すように、想定する同時接続数やプロンプト長が変わるとビルドをやり直す必要があります。チューニングの手間は3つの中で最も大きいと言えます。
Ollama、そもそも用途が違う
Ollama を同じ軸で比べるのは適切ではありません。これは llama.cpp をバックエンドに据え、手元のマシンでモデルを動かすための道具です。macOS、Windows、Linux で動き、REST API や Python/JavaScript ライブラリから呼べるので、個人開発や検証、プライバシー重視のローカル実行、コーディング支援ツールのバックエンドとして使われます。
量子化済みモデルを1コマンドで落として動かせる手軽さが価値で、何百並列を GPU クラスタでさばくための設計ではありません。「試す・作る」が Ollama、「配る・さばく」が vLLM / SGLang / TensorRT-LLM という住み分けで考えるのが現実的でしょう。
主要エンジンの比較表
項目 | vLLM | SGLang | TensorRT-LLM | Ollama |
|---|---|---|---|---|
設計 | サーバー先行 | サーバー先行 | エンジン先行 | ローカル実行 |
KV 管理の核 | PagedAttention | RadixAttention | paged attention + in-flight batching | llama.cpp |
強み | 総合バランス | 接頭辞の再利用 | 生成レイテンシの安定 | 導入の手軽さ |
セットアップ難度 | 低い | 中程度 | 高い | 最も低い |
事前ビルド | 不要 | 不要 | 必要 | 不要 |
主な想定環境 | GPU サーバー | GPU サーバー | NVIDIA GPU 専用 | ノート PC / 単体マシン |
向く規模 | 本番サービス | 本番サービス | 本番サービス | 個人・検証 |
H100での実測値を読む
Jarvislabs が2026年5月に公開した H100 80GB 上のベンチマークは、この3エンジンを同条件で並べた貴重なデータです。Qwen2.5-7B-Instruct を1GPU、Qwen3-30B-A3B(MoE)と Qwen3-32B を2GPU で動かし、一般的なチャット負荷の ShareGPT と、入力約 16K トークンの長文脈負荷である RULER 16K の2種類を、同時接続数 60 から 600 まで 60 刻み、さらに上限なしの条件で測定しています。
チャット負荷での結果
モデル | 観測された傾向 |
|---|---|
Qwen2.5-7B | vLLM が全域で最高スループット。同時 60 で約 6.9K tok/s、上限なしで約 23.5K tok/s |
Qwen2.5-7B | TensorRT-LLM は TPOT 約 9〜12ms と安定だが、同時 600 で TTFT 約 4.5 秒、上限なしで約 7.8 秒 |
Qwen3-30B-A3B | vLLM が同時 360 で約 9.36K tok/s のピーク。SGLang は同時 240 超で復号遅延が約 40〜50ms に悪化 |
Qwen3-32B | vLLM が同時 600 で 4.2K tok/s 超。TensorRT-LLM は同時 240 以降 約 3.2K tok/s で頭打ち |
Qwen3-32B | 同時 600 の TTFT は TensorRT-LLM 約 15 秒に対し、vLLM と SGLang は約 2.3〜2.4 秒 |
長文脈負荷での結果
RULER 16K では傾向が変わります。Qwen2.5-7B では vLLM がほとんどの同時接続数で最小の TTFT(同時 60 で約 1.9 秒)を記録した一方、SGLang は復号遅延が最小(TPOT / ITL 約 77〜81ms)ながら、同時 60 の TTFT が約 10.8 秒まで伸びました。スループット自体は約 553〜582 tok/s で3者ほぼ横並びです。
Qwen3-30B-A3B では vLLM がスループット(約 804〜807 tok/s)と TTFT の両方で優位、SGLang は TPOT 約 61〜63ms で最小、TensorRT-LLM はスループット約 701〜715 tok/s、TPOT 約 84〜87ms と振るいませんでした。Qwen3-32B では vLLM がスループット約 191 tok/s と TPOT 約 98ms で最良、TensorRT-LLM が約 188 tok/s で肉薄、SGLang は約 166〜168 tok/s にとどまっています。ただし TTFT はどのエンジンでも数十秒規模で、16K 入力を対話的に使うには別の工夫が必要だと分かります。
3つの指標の意味
数字を読むうえで、3つの指標の役割を切り分けておく必要があります。
- TTFT(Time To First Token): リクエストから最初の1文字が出るまで。体感の待ち時間に直結します
- TPOT / ITL(Time Per Output Token / Inter-Token Latency): 1トークンあたりの生成間隔。文章が流れる速さを決めます
- スループット: 単位時間に処理できたトークン総数。GPU 1枚あたりのコストに直結します
この3つは同時に最適化できません。バッチを大きく束ねればスループットは上がりますが、後から来たリクエストは前のプリフィル処理を待たされて TTFT が悪化します。実測で TensorRT-LLM の TPOT が安定しているのに TTFT が二桁秒まで伸びたのは、まさにこのトレードオフが表に出た結果です。
したがって「どのエンジンが速いか」という問いは成立しません。チャット UI なら TTFT、バッチ要約なら スループット、長文生成なら TPOT と、守る指標を先に決めてから選ぶ順序になります。
用途別の選び方
以上を踏まえると、判断は次のように整理できます。
- vLLM: 要件が固まっていない、あるいは混在負荷をさばく場合の既定解。実測でも両負荷で最もバランスが良好でした
- SGLang: 共通システムプロンプト、RAG テンプレート、エージェントの反復呼び出しなど接頭辞の再利用が効く場面、または復号遅延を最優先する場面
- TensorRT-LLM: モデルとプロンプト長と同時接続数が固定された NVIDIA 環境で、ビルド設定を詰める時間がある場合
- Ollama: 検証、プロトタイプ、個人利用、オフライン要件のある単体マシン
モデル側の選定については、日本語LLM比較2026、LLM-jp・PLaMo・Swallowの性能と選び方で日本語性能の観点を整理しています。エンジンはモデルサイズとアーキテクチャ(密モデルか MoE か)によって得意不得意が変わるため、モデルを決めてからエンジンを測るのが順序としては自然です。
ベンチマークの限界
重要な注意点として、Jarvislabs の著者自身が「フレームワークの普遍的な順位付けではない」と明記しています。実際、記事中ではフレームワークのバージョンが記録されておらず、別のリリースで同じ結果が再現するとは限りません。
さらに、一部の TensorRT-LLM エンジンは測定した同時接続数より小さい max_batch_size でビルドされており、高同時接続時の TTFT が設定依存であることを著者も認めています。測定値には非単調な動きも含まれ、単発の実行にはノイズが残っている可能性があります。
結論として、公開ベンチマークは候補を絞るための地図であって、意思決定の根拠そのものではありません。自社のプロンプト長分布、想定同時接続数、使う GPU で測り直す工程は省けません。
導入の手軽さの差
最後に、起動までの手数の違いを確認しておきます。vLLM と SGLang はモデルを指定すればそのままサーバーが立ちます。
# vLLM
pip install vllm
vllm serve Qwen/Qwen2.5-7B-Instruct --max-model-len 8192

# SGLang
python -m sglang.launch_server --model-path Qwen/Qwen2.5-7B-Instruct --port 30000

# Ollama
ollama run qwen3
一方 TensorRT-LLM は、PyTorch ベースの高水準 LLM API が整備されて以前より扱いやすくなったものの、最大性能を引き出す経路ではモデルごとのエンジンビルドとパラメータ調整が前提になります。この差は初期構築だけでなく、モデル更新のたびに発生する運用コストとして積み上がる点を見落とさないほうがよいでしょう。
検証の現実的な進め方としては、まず Ollama で動作とプロンプトを固め、次に vLLM で基準値を取り、接頭辞の共有率が高いと分かったら SGLang を、負荷条件が固定でき GPU コストを削りたいなら TensorRT-LLM を比較対象に加える、という順序が無駄が少ないはずです。