 AI-Papers
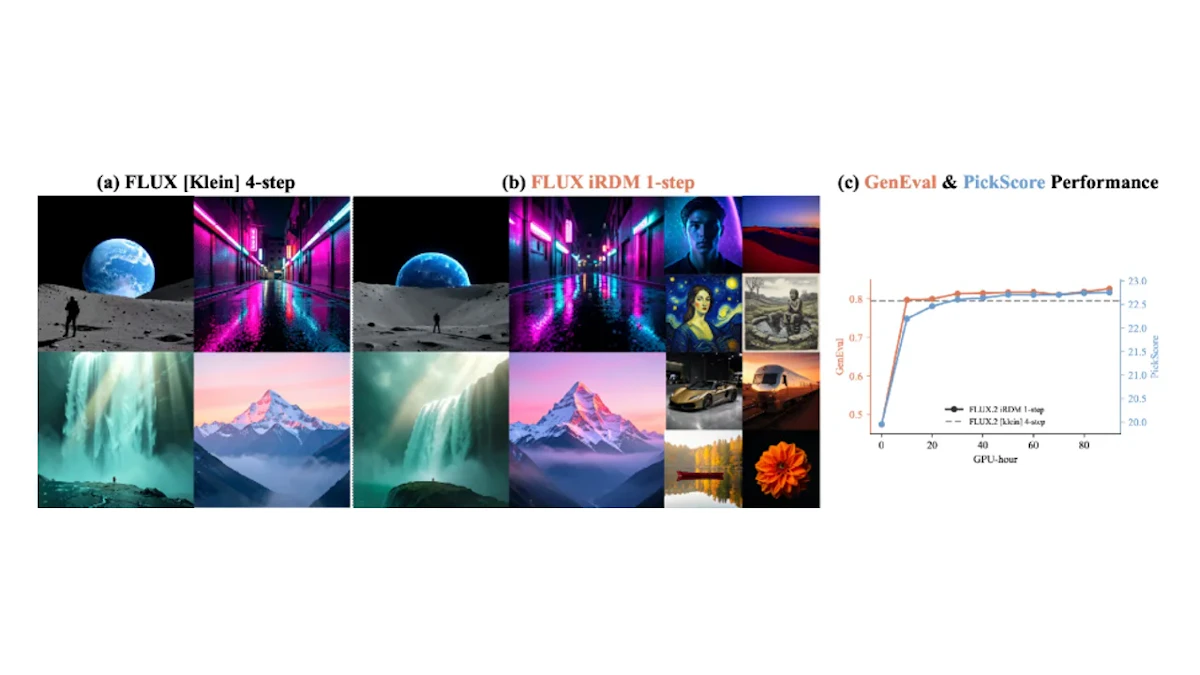
- 14種類の凍結エンコーダによるMMD分布マッチングで、ImageNet 1ステップ生成のSW_r14スコア1.30を達成し、既存の1ステップ手法を大きく上回った
- FLUX.2を4ステップから1ステップに変換しながらGenEval 0.826を実現。元の4ステップ版(0.794)を超え、訓練コストは90 H200 GPU時間にとどまる
- PickScoreで既存すべての生成モデルと実写真参照を上回る初の1ステップモデルとなり、SW_r14が人間の選好と整合することも確認された
研究の背景と課題
拡散モデル(Diffusion Model)は高品質な画像生成を可能にしましたが、通常は20〜50ステップの反復計算が必要です。このコストはリアルタイム応用の大きな障壁となっており、ステップ数を減らす研究が活発に行われています。
1ステップ化への主なアプローチには、教師モデルの知識を少ないステップで再現する「蒸留(Distillation)」や、確率的な軌跡を直接学習する「フロー整合(Flow Matching)」があります。これらは実績を上げていますが、オンライン教師モデルや敵対的学習(GAN)、連続的な軌跡サンプリングといった複雑な仕組みを必要とすることが多く、設計と調整の難しさが課題でした。
本研究が提案する iRDM(improved Representation Distribution Matching) は、こうした複雑な仕組みを一切使わず、「生成画像の特徴分布を実画像の特徴分布に一致させる」という考え方だけで1ステップ生成を実現します。
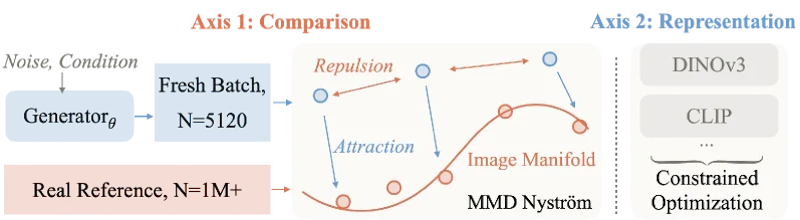
iRDMの3つの設計原則
iRDMは従来のRDMを3つの重要な改善によって大幅に強化しています。
第1の改善は MMD損失の正しい推定法 です。Maximum Mean Discrepancy(MMD)は2つの確率分布の距離を測る統計的指標で、以前の研究では「スケールしない」と見なされていました。iRDMはNyström近似(大規模行列を低ランクで近似する手法)を使って参照分布の平均を効率よく推定することで、MMDがスケーラブルで強力な目的関数として機能することを示しました。
第2の改善は 大バッチサイズの活用 です。分布マッチングでは、1ステップで更新するたびに十分なサンプルを使って分布の全体像を把握することが重要です。実験では生成バッチサイズが2048を超えると品質が安定して向上することが確認されており、これは蒸留系手法の一般的なバッチサイズを大きく上回る水準です。
第3の改善は 14エンコーダの組み合わせ です。DINOv2やCLIPなど優れた単一エンコーダを使っても、そのエンコーダに最適化された画像を生成することで損失だけが下がる「表現の崩壊」が起きます。14種類のエンコーダを組み合わせることでこの問題を回避し、多角的な視点から画像品質を担保します。
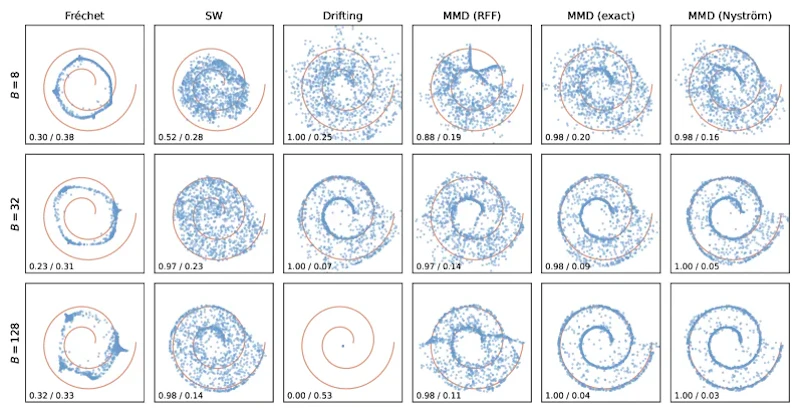
評価指標 SW_r14 の意義
iRDMは訓練損失とは独立した評価指標として SW_r14 を提案します。これは14種類のエンコーダ上での Sliced-Wasserstein 距離を平均したもので、「多角的な視点から見て実画像の分布にどれだけ近いか」を測ります。
単一エンコーダの距離が下がっても画像品質が向上しないケースがあることは実験でも確認されており、SW_r14 がより信頼性の高い品質指標として機能します。また、この指標が人間の選好を測る PickScore の順位と一致することも示されており、客観評価と人間の感覚が整合していることがわかります。
実験結果
ImageNet 256px での評価では、iRDM は SW_r14 スコア 1.30 を達成し、先行する pMF-H FD-SIM(2.05)を大きく引き離して1ステップ生成の最高水準を更新しました。PickScore の人間選好調査でも、iRDM は先行手法に対して71.2%の勝率を示しています。
FLUX.2 [klein] への適用実験では、4ステップ版をベースに iRDM でファインチューニングを行い、1ステップ版を構築しました。テキストと画像の整合性を測る GenEval スコアは 0.826 となり、元の4ステップ版(0.794)を上回ります。PickScore も 22.76 対 22.58 と改善しており、訓練コストは 90 H200 GPU時間 にとどまります。
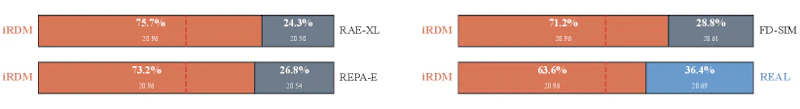
PickScore の比較では、iRDM が先行するすべての生成モデルより高い勝率を示しただけでなく、実際の写真(実写真参照)をも上回りました。これは1ステップ生成モデルとして初めての成果です。目視では pMF-H FD-SIM と僅差に見えるケースもありますが、SW_r14 スコアには明確な差があり(1.30 対 2.05)、この指標が人間の選好と整合していることを裏付けています。
まとめと今後の展望
iRDM は、教師モデルや敵対的学習を使わずに「特徴分布のマッチング」だけで1ステップ画像生成の品質を大幅に高める手法です。MMD損失の正しい推定、大バッチサイズ、14エンコーダの組み合わせという3つの原則で、FLUX.2を1ステップ化しながら元モデルの品質を超えることに成功しました。
FLUX の高速化というテーマでは、Multi-Resolution Flow Matchingで推論を25倍高速化するMrFlow も注目されていますが、iRDMは「4ステップから1ステップへの変換」という異なる切り口で実用的な改善を実現しています。
今後の課題としては、512×512を超える高解像度への対応、生成の多様性(モード崩壊)の回避、動画生成への応用が挙げられます。90 H200 GPU時間という訓練コストは多くの研究機関にとって再現可能な水準であり、iRDM が示した「分布レベルのマッチング」という設計指針が今後の高速画像生成研究に広く活用されることが期待されます。
論文情報: "Representation Distribution Matching for One-Step Visual Generation"(Lan Feng et al., 2026) arXiv:2607.02375, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。

