 AI-Papers
- VAE潜在空間を介さず、ピクセル空間で直接テキスト画像拡散モデルを学習する実用的な訓練レシピを体系化した研究です
- 潜在空間で事前学習した重みで初期化し、x-prediction、軽量なDiPデコーダ、γ=2のノイズスケジュールなど複数の設計選択を検証しています
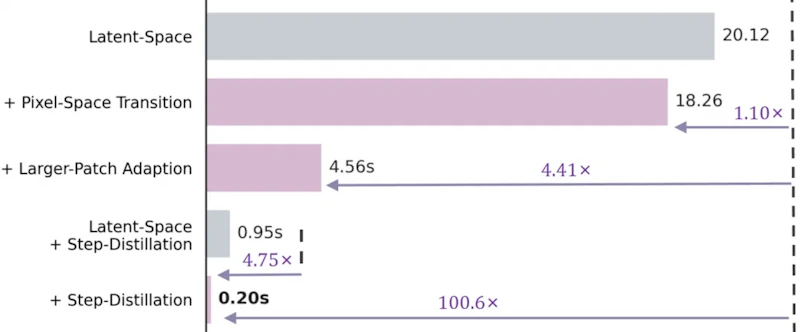
- GenEvalやDPGで潜在拡散と同等以上の品質を保ちながら、推論速度を3.18〜4.75倍まで高速化しました
研究の背景
近年のテキストから画像を生成する拡散モデルの多くは、VAE(Variational Autoencoder、変分自己符号化器)で画像を圧縮した「潜在空間」で学習を行います。画像をそのままの画素(ピクセル)で扱うと計算量が膨大になるため、VAEで情報量を8分の1程度に圧縮してから拡散モデルを動かすのが定石でした。この仕組みは学習を効率化する一方で、いくつかの弱点も抱えています。
まず、VAEは別途学習が必要な追加部品であり、圧縮と復元の過程で細部の情報が失われることがあります。さらに推論時にはVAEによる復元処理が必須となり、これが生成全体の速度を押し下げる要因になります。そこで、VAEを完全に取り除いてピクセル空間で直接学習できないか、という問いが改めて注目を集めています。
ただし、素朴にピクセル空間で大規模学習を始めると、潜在空間での学習に比べて収束が大幅に遅くなることが知られています。本研究はAlibaba Token Hub、HKUST、南京大学、UCSDによる共同研究で、この収束の遅さを克服する訓練レシピを実証的に明らかにしました。
提案手法
本研究の中心はlatent-to-pixelと呼ぶ2段階の戦略です。最初に効率の良い潜在空間で生成の基礎を事前学習し、その後の後半段階でピクセル空間へ移行します。ゼロから学習するのではなく、すでに獲得した知識を橋渡しする点が鍵になります。
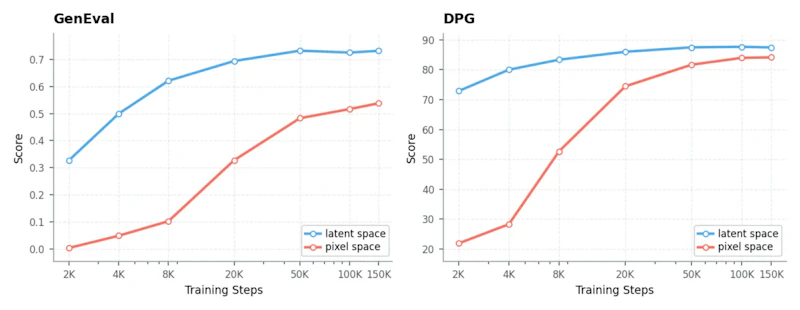
ピクセル空間への移行では、まず潜在空間で学習済みのモデルの重みで初期化します。図3が示すように、ゼロから学習する場合に比べて画像の構造を早い段階で獲得でき、収束が大きく速まります。デコーダには DiP(Diffusion in Patches)と呼ばれる軽量な畳み込み型のデコーダを採用しました。約1000万パラメータと小規模ながら、隣り合うパッチ(画像を分割した小片)同士の情報をやり取りさせることで、パッチ境界に生じる格子状の不自然な模様を抑えます。
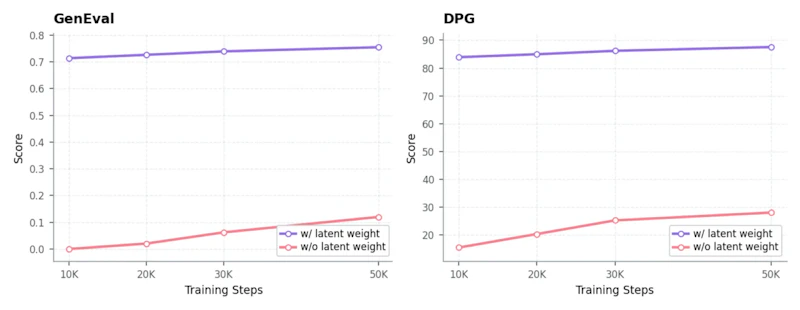
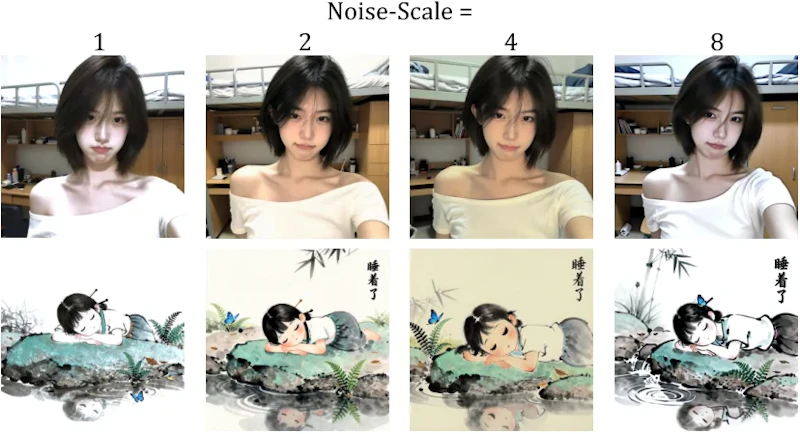
予測対象には x-prediction(ノイズではなく元画像そのものを予測する方式)を採用しています。潜在空間で使われる v-prediction から切り替えても初期化によって移行が安定し、最終的にはx-predictionの方が高いスコアを達成しました。ノイズスケジュールについては、理論上は8倍の圧縮率に対応するγ=8が妥当に見えますが、実験ではγ=2が最も色合いのバランスが良く、GenEvalとDPGの両方で最高値を示しました。
学習データの構成も重要な設計要素です。潜在空間モデルが生成した画像だけで学習すると収束は速いものの、元モデルの持つ癖や欠陥まで受け継いでしまいます。一方で実画像だけでは収束が遅くなります。両者を1対1で混ぜることで、速い適応と細部の品質を両立できました。また、パッチサイズを段階的に大きくする適応(ps16からps32へ)を行うと、扱うトークン数を4分の1に減らしながら品質を維持でき、これが後述の高速化にも寄与します。
実験結果
提案手法は複数の基盤モデルで検証されました。以下は潜在空間版とピクセル空間版(提案手法)を、画像生成の指示追従性を測るGenEvalと、詳細な記述への対応を測るDPGで比較した結果です。NFE(Number of Function Evaluations、生成に要する反復回数)が異なる複数の設定で評価しています。
モデル | 手法 | GenEval | DPG | 推論時間 | 高速化 |
|---|---|---|---|---|---|
Z-Image(100 NFE) | 潜在空間 | 0.7510 | 86.91 | 20.12秒 | 基準 |
Z-Image(100 NFE) | ピクセル空間 | 0.7644 | 87.60 | 4.56秒 | 4.41倍 |
Z-Image-Turbo(4 NFE) | 潜在空間 | 0.7625 | 85.31 | 0.95秒 | 基準 |
Z-Image-Turbo(4 NFE) | ピクセル空間 | 0.7698 | 86.85 | 0.20秒 | 4.75倍 |
FLUX2-klein(100 NFE) | 潜在空間 | 0.8027 | 84.89 | 20.25秒 | 基準 |
FLUX2-klein(100 NFE) | ピクセル空間 | 0.8096 | 86.88 | 6.38秒 | 3.18倍 |
いずれの構成でも、ピクセル空間版が品質指標で潜在空間版を上回りつつ推論を高速化しました。高速化の主因は、VAEによる復元処理が不要になった点と、パッチサイズを段階的に大きくして扱うトークン数を減らした点にあります。特にステップ数を極端に減らした蒸留モデルでは、VAEのボトルネックが消えることで速度向上がそのまま生成全体に反映され、3.18〜4.75倍の高速化を実現しています。
まとめと今後の展望
本研究は、VAEを前提としてきたテキスト画像拡散モデルの常識を問い直し、ピクセル空間で直接学習しても潜在拡散に匹敵する品質と大幅な高速化が両立できることを実証しました。重みの初期化、データ構成、予測対象、デコーダ設計、ノイズスケジュールという設計選択を一つずつ検証した点で、実務者が再現しやすいレシピになっています。
一方で課題も残ります。最適なノイズスケールγは理論値では決まらず、実験的な調整が必要でした。また本研究は大規模なテキスト条件付き生成に焦点を当てており、小規模設定やクラス条件付き生成での有効性は今後の検証課題です。極端なパッチサイズの拡大が細部の劣化を招く点も、適用範囲を見極める必要があります。
VAEの必要性を再考する流れは画像生成の効率化に直結するテーマであり、続報が待たれます。各モデルの実力を比較したい方は画像生成AI比較2026もあわせて参考になります。
論文情報: "An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models"(Dengyang Jiang et al., 2026) arXiv:2608.16887
本記事の図(図1、図3、図9、図12)は解説のため上記論文より引用しています。


