 AI-Papers
- 総パラメータ約26B、トークンあたりアクティブ3BのマルチモーダルMoEモデルで、1Mトークンの文脈に対応する
- 物理24層のうち中間12層を3回通すことで、1トークンが48層分の計算を受ける「層の再利用」構造を採用
- NVFP4とMXFP8の混在精度で配布され、llama.cppやMLX、SGLangで公開初日から動作する
Inkling 2 Miniの概要
2026年11月20日、Hugging Face は公式ブログで Thinking Machines Lab との協業を発表し、ローカル実行を想定した小型マルチモーダルモデル Inkling 2 Mini を公開しました。モデルIDは thinkingmachines/Inkling-2-Mini で、テキストと画像を入力してテキストを出力します。
規模は物理パラメータが約26B、1トークンあたりに実際に使われるアクティブパラメータが3Bです。各層では128個のSwiGLUエキスパートから8個をルーターが選ぶ構成になっており、より大きな Inkling 2 Small が384個のエキスパートから選ぶのに対し、Mini は候補数を絞って手元のマシンで動く規模に収めています。
対応文脈長は1Mトークンです。隠れ層の次元は2,304、クエリヘッドは24、KVヘッドは8で、6層ごとのブロックのうち5層が最大1,024トークンのスライディングウィンドウ注意、残り1層が全系列を見る全注意という配置になっています。
層を3回ループする構造
このモデルで最も特徴的なのが、デコーダ層の使い方です。物理的な層数は24ですが、すべてが1回ずつ使われるわけではありません。前方の0〜5層と後方の18〜23層は1回だけ通過し、中間の6〜17層はコアとして3回繰り返し通過します。
結果として1トークンが受ける計算は 6 + 3×12 + 6 で48層分に相当します。3回のパスは同じ重みを共有するため、保存すべき層の種類は増えません。一方でKVキャッシュと短い畳み込みの状態はパスごとに個別に保持されるので、各周回は同じ重みでも異なる内部状態を持つことになります。
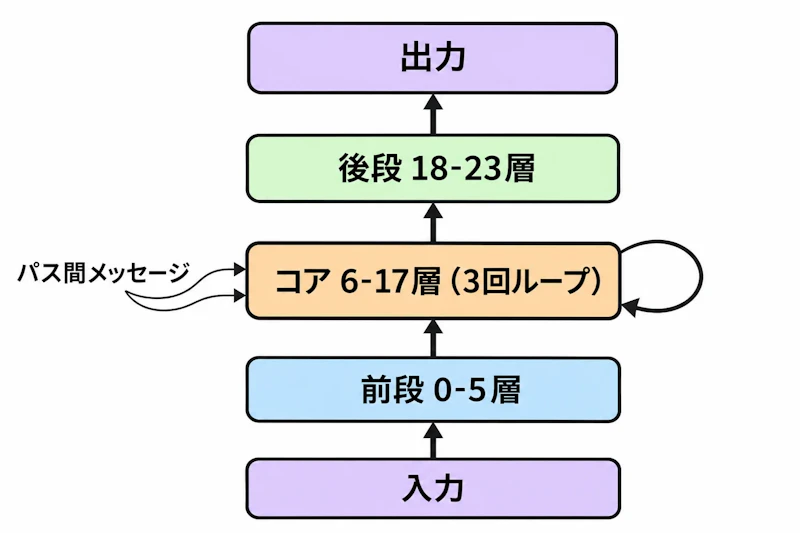
図1のように、2回目と3回目のパスでは単純な再入力ではなく、前のパスの残差ブロック2つを参照する仕組みが加わります。rank-64の4つのゲートがこの情報をクエリ、キー、バリュー、MoE入力それぞれに混ぜ込み、ゲート制御部が現在の入力をどれだけ忘れ、メッセージをどれだけ足すかを決めます。
同時に公開された研究用チェックポイント TML-d24-varloop-research は、ループ回数を可変にして学習したものです。3回ではなく1回や2回に設定すれば推論は大幅に速くなりますが、生成品質は多少落ちる可能性があると説明されています。公開記事ではこの変種について詳細な評価までは行っていないとされており、品質と速度のトレードオフは利用者側の検証に委ねられている状態です。
混在精度とDSparkドラフタ
配布される重みは、エキスパート部分にNVFP4とMXFP8を混ぜた混在精度形式です。量子化済みの状態で配られるため、MLX環境では再変換なしに元のチェックポイントをそのまま使えます。llama.cpp向けにはIQ4_NL(4ビット)とQ8_0(8ビット)のGGUF版も用意されています。
推測デコード用に、3層構成の DSpark ドラフタが同梱されました。ドラフタが先にトークンを提案し、本体モデルがそれを検証する方式です。公開記事によると、このドラフタはデコーダ訪問の5番目、23番目、41番目の入力と、48番目の最終正規化状態を読み取って動作し、追加のメモリコストは小さいと記載されています。速度向上の具体的な数値は本文ではなくグラフ画像でのみ示されています。
ベンチマークの位置づけ
公開記事は、Inkling 2 Mini が Artificial Analysis Intelligence Index v5(AAv5)において同クラスで最高水準だとしています。比較対象は Gemma 4 31B、Muse Glimmer、Qwen3.8-27B、Nemotron 3.5 Super VL の4モデルで、48のベンチマークのうち32で首位に立ったと報告されました。
評価領域はコーディングと自動研究、エージェント的な検索とツール利用、ビジョン、推論と知識、安全性とアラインメントに分かれています。個別では FrontierCode v2.0 で首位、Terminal-Bench 4.0 では Qwen3.8-27B と同等、AutomationBench-AA v1.0.6 では Qwen に及びませんでした。ただし本文にスコアの表は掲載されておらず、数値はグラフ画像とモデルカードを参照する形になっています。著者自身も体感評価について「少なくとも Qwen 3.8 27B と同等」と控えめに述べ、さらなる検証が必要だと付け加えています。画像入力を扱うモデルの設計思想としては、WeMM-Videoのような全モーダルモデルとは対照的に、入力をテキストと画像に絞って効率を取る方向です。
すぐ試せる実行環境
ローカル実行を前提にしているため、対応ランタイムが公開初日から広く揃っています。主な選択肢は次のとおりです。
- Transformers:
AutoModelForMultimodalLMとAutoProcessorで読み込み、ツール呼び出しにも対応 - llama.cpp / Llama App:
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NLで起動し、OpenAI互換APIを提供 - MLX: mlx-lm に統合済みで、画像とテキストの両方を入力可能
- SGLang: データセンター向けに初日対応。
--speculative-algorithm DSPARKで推測デコードを有効化
推論の深さは apply_chat_template の reasoning_effort で調整でき、none(0.0)から high(0.9、既定値)、max(0.99)までの段階指定に加えて0.0〜0.99の任意の数値も受け付けます。SGLang の計測は NVIDIA B300 1枚、プロンプト1,024トークン、生成1,024トークン、並列数1から64という条件で行われました。
層の再利用が示す方向
パラメータ数を増やさずに計算量だけを増やす層のループは、メモリ容量が制約になるローカル実行と相性のよい設計です。重みの保存量は24層分のまま、推論時の計算は48層分に近づけられるため、VRAMの上限に縛られる環境で深さを稼ぐ手段になります。
その代償として、トークンあたりの計算時間は層数に比例して伸びます。可変ループのチェックポイントが同時に公開されたのは、この増分をどこまで許容するかを用途ごとに選べるようにする狙いと読み取れます。手元のGPUやApple Silicon上でどの設定が実用的な速度と品質の均衡点になるかは、公開されたGGUFやMLX版を動かして確かめる段階にあります。


