 AI-Papers
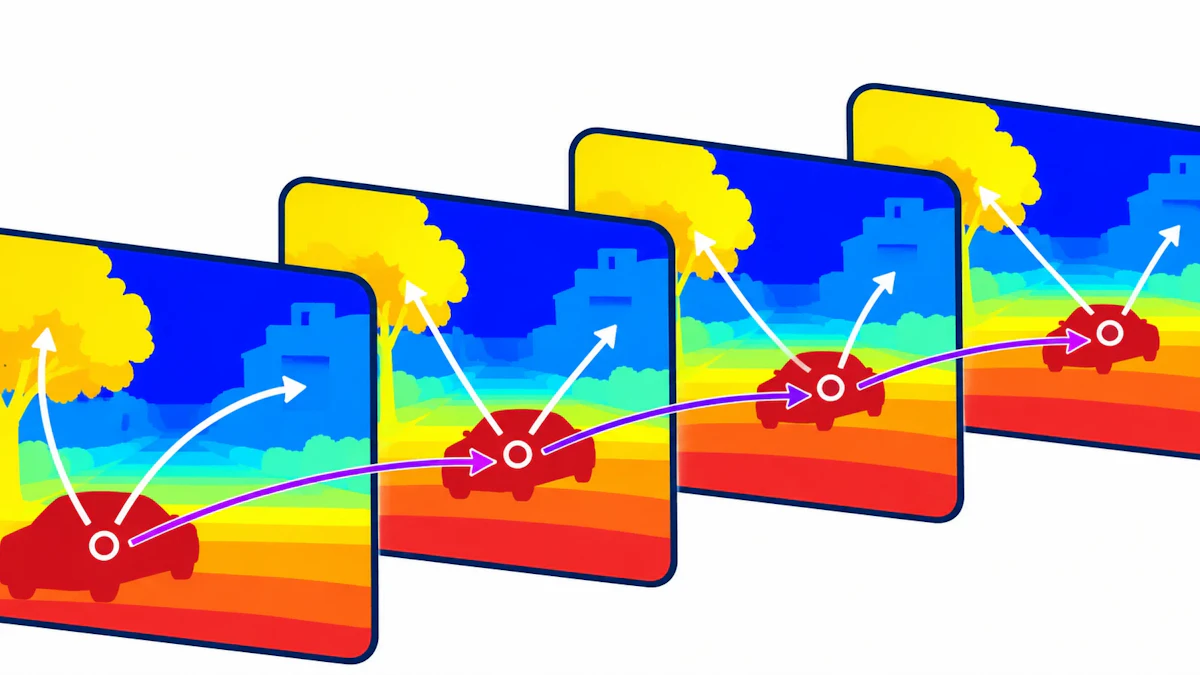
- 単一フレームは境界が鮮鋭だがちらつく、複数フレームは安定だが輪郭がぼける、という従来のトレードオフに正面から取り組んだ研究です
- DINOv3 で初期化したマルチビューTransformerがフレーム内Attentionとフレーム間Attentionを交互に適用し、ネイティブ解像度のまま複数枚を同時処理します
- 焦点距離推定の精度は δ25 で 88.6%(従来の Depth Pro は 71.7%)、最小モデルは 1080p のストリーミングを 53fps で処理します
研究の背景
1枚の画像や動画から各画素までの距離を推定する単眼深度推定は、AR表示、ロボットの空間把握、動画編集の被写体分離など幅広い用途を支える技術です。ただし実用上は、距離の絶対値が正しい(メトリック精度)だけでは足りません。髪の毛や細い枝のような境界が鮮明に出るか、そして動画でフレームごとに値が暴れないか、という2点も品質を大きく左右します。
これまでの手法はこの3つを同時に満たせていませんでした。複数フレームをまとめて扱う手法は時間的に安定する代わりに境界が平滑化され、1枚だけを見る手法は輪郭が鮮鋭でも隣接フレーム間で深度が揺れます。Apple の研究チームが発表した Depth Pro 2 は、画像と動画の両方を1つのネットワークで扱い、この二者択一を解消したと主張しています。
図1の比較が論文の主張を端的に示しています。毛の細部を拾える手法はフレーム間で深度値が一致せず、一貫性の高い手法は輪郭がにじんでいます。
提案手法
中核は、1枚から複数枚までの可変枚数のフレームをネイティブ解像度のまま同時に処理するマルチビューTransformerです。バックボーンは自己教師あり視覚モデル DINOv3 の重みで初期化され、16×16 のパッチ分割と2次元の回転位置埋め込み(RoPE)を使います。入力は長辺を基準に正規化するためアスペクト比が保たれ、リサイズによる歪みが避けられます。
注目したいのはAttentionの配置です。前方の3分の1のブロックはフレーム内の自己Attentionのみを行い、残る3分の2でフレーム内Attentionとフレーム間Attentionを交互に適用します。前半で各フレームの細部表現を作り込み、後半で複数フレームの情報を突き合わせる構成が、鮮鋭さと一貫性の同時達成につながっています。フレーム順の符号化は持たないため、入力の並べ替えに対して出力が変わらない設計です。
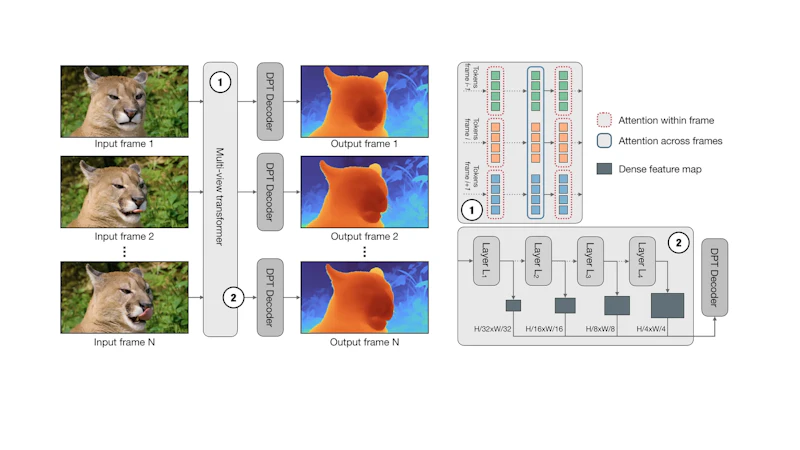
図3のように、Transformer の中間層から取り出した特徴を DPT デコーダが融合し、フレームごとに逆深度マップを出力します。メトリックな距離を得るには焦点距離が必要ですが、ネットワークは焦点距離で正規化した逆深度を予測し、EXIF 情報がない場合は別建ての軽量な推定器(DINOv3 ViT-S/16、23.5M パラメータ)が焦点距離を補います。
学習の設計
学習には19のデータセットを用い、正確な正解深度が得られる合成データを主軸に、スマートフォン動画や Waymo Open Dataset などの実データを組み合わせています。クリップは画像の1フレームから動画・多視点データの最大32フレームまでで、段階的なカリキュラムは使わず一度に学習します。境界の鮮鋭さを損なわないために、正解深度を補間しない方針が徹底されている点が設計思想をよく表しています。
損失はメトリックな絶対値を合わせる項、スケールとシフトに不変な項、合成データのみに適用する多重スケールの勾配項、そして正解カメラ姿勢を用いた多視点一貫性の項を組み合わせた構成です。128基の B200 GPU で 100K ステップ、AdamW(ピーク学習率 5×10⁻⁵)という規模で訓練されています。
実験結果
評価はメトリック精度、境界の鮮鋭さ(Boundary F1)、時間的なちらつき(Temporal Jitter)の3軸で行われ、最大モデル Depth Pro 2-H+ は動画でのメトリック精度の平均順位が 1.0、境界 F1 の平均順位が 1.3 と、複数の既存手法を上回りました。焦点距離推定も大きく改善しています。
項目 | Depth Pro | Depth Pro 2-H+ |
|---|---|---|
焦点距離 δ25(6データセット平均) | 71.7% | 88.6% |
境界 F1(Sintel、動画) | ー | 43.4 |
時間的ジッタ(Sintel、低いほど良い) | ー | 1.39 |
動画メトリック精度の平均順位 | ー | 1.0 |
時間的ジッタは Sintel で 1.39、Spring で 0.86 と報告され、既存の上位手法が Sintel で 2.0 前後であることと比べて小さい値です。単一画像でのメトリック精度は平均順位 2.4 で首位ではありませんが、3軸すべてで上位に入る手法は他にありません。
モデルは 24.3M の S から 96.5M の B、334.0M の L、872.1M の H+ までの4種類が公開されています。速度面では、S が 1080p のストリーミング動画を 53fps、H+ が 8fps で処理するとされ、焦点距離推定器の追加コストは H+ で 0.5%、S でも 8% 程度です。ただし付録の計測表では同じ 1080p で S が 44.8fps、H+ が 5.3fps と報告されており、測定条件の違いによる差がある点は押さえておきたいところです。動画処理の遅延低減は生成側でも共通の課題であり、深度推定がリアルタイム帯に入ったことは応用の幅を広げます。
応用と残る課題
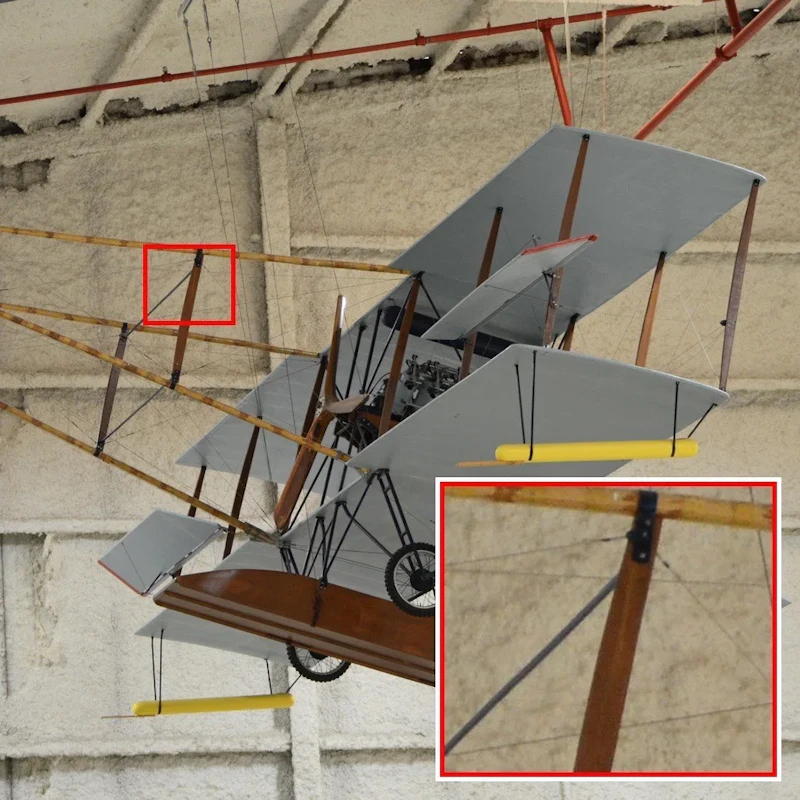
論文では深度を使ったボケ(bokeh)描画と、単一画像からの新規視点合成への適用も示されています。図9の新規視点合成では、既存手法が飛行機の支柱のような細い構造を壊したり歪めたりする一方、Depth Pro 2-H+ は形状を保ったまま最長辺 4096 ピクセル規模で描画できています。
一方で課題も残ります。最も高精度な H+ は 8fps 程度で、鮮鋭さと速度の両取りは依然として難しい状況です。また DIODE での誤差の多くは空の領域の推定に由来すると著者自身が述べており、時間的整合性の別指標(Temporal Alignment Error)では平均順位 3.8 にとどまります。著者はこの指標が遮蔽部で曖昧になり、ぼけた予測を有利に評価しうると説明していますが、評価指標そのものの妥当性を含めた議論の余地はあるでしょう。
まとめと今後の展望
Depth Pro 2 は、フレーム内とフレーム間の Attention を交互に重ねるという比較的素直な設計で、単眼深度推定の長年のトレードオフを緩和しました。ネイティブ解像度処理と補間しない正解深度という地道な設計判断が、境界の鮮鋭さに効いている点も実装上の参考になります。
コードと重みが4サイズ分公開されているため、端末性能に合わせた選択がしやすく、AR、ロボティクス、動画編集といった分野での検証が進みそうです。評価指標の整備や、小型モデルでどこまで鮮鋭さを保てるかが次の焦点になります。
論文情報: "Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth"(Peiyun Hu et al., 2026) arXiv:2611.26603
本記事の図(図1、図3、図9)は解説のため上記論文より引用しています。


