 AI-Papers
- テキスト・画像・音声・動画を扱う中英バイリンガルの全モーダルモデルを2B/4B/9B/35B-A3Bの4サイズで公開
- 約1.2兆トークンの段階的事前学習に、多教師オンポリシー蒸留と反復抑制の選好最適化、専門家RLを重ねた多段構成
- 120以上のベンチマークでQwen3.5-Omni-FlashやSeed2.0-Miniを上回り、Gemini-3.0-Flashとの差を縮めた
研究の背景
動画を理解するモデルの多くは、映像フレームだけを入力として扱ってきました。しかし実際の動画には、話し声や効果音、背景音といった音声情報が含まれており、映像だけでは「誰が何を言ったか」「画面の外で何が起きたか」を判断できません。
音声と映像を同時に扱う全モーダル(omni-modal)モデルはすでにいくつか登場していますが、商用の閉じたモデルが先行し、公開モデルは性能面で後れを取っていました。WeMM-Videoは、この差を縮めることを狙って設計されたモデル群です。
開発したのはWeChat Visionと清華大学などの研究者らで、論文は2026年11月にarXivで公開されました。2B、4B、9B、35B-A3Bの4サイズが用意され、素早く答える指示応答モード(Instruct)と、手順を踏んで考える思考モード(Thinking)を切り替えて使える構成になっています。
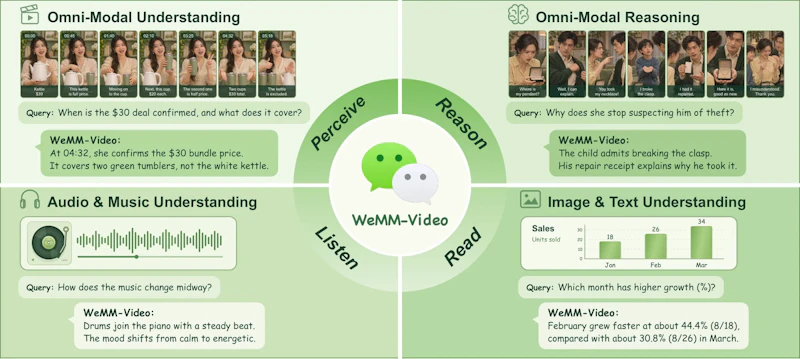
図1に示すように、対象は音声付き動画の理解だけではありません。画像の読み取りや音声認識、テキストだけの推論といった一般的なタスクも1つのモデルでこなす点が、この研究の出発点になっています。
モデルの構成
基盤となる言語モデルには、2B/4B/9BがQwen3.5の同サイズ、35B-A3BがQwen3.6-35B-A3Bを使っています。視覚側は各基盤モデルが元から持つ画像エンコーダと射影層をそのまま引き継ぎ、画像や動画の既存能力を損なわないようにしました。
新たに追加されたのが音声の処理経路です。Qwen2.5-Omniから初期化したWhisperベースのエンコーダが16kHzの音声を30秒単位で処理し、その出力を窓単位のQ-Formerが圧縮します。0.1秒の窓を1トークンにまとめるため、音声は毎秒10トークンという一定の密度で言語モデルに渡ります。
映像と音声のトークンは時間順に交互に並べ、テキストのタイムスタンプを明示的に挿入します。これにより、画面の変化と音の変化がどの時点で対応しているかをモデルが追えるようになっています。
1.2兆トークンの事前学習
事前学習には約1.2兆トークンの多モーダルデータを使いました。内訳では音声と映像を組み合わせた共同データが45.4%と最大で、タスク別ではキャプション生成が37.7%を占めます。学習は3段階に分けて進みます。
- 第1段階、音声Q-Formerだけを学習し、音声認識と音声キャプションで音声と言語を対応づける
- 第2段階、視覚エンコーダ以外を解凍し、テキスト・画像・音声・動画を混ぜて知識を注入する
- 第3段階、文脈長を広げ、長尺動画や長い音声、複数動画の入力に対応させる
段階を分ける狙いは、新しく足した音声経路を先に安定させてから全体を動かすことにあります。最初から全部を同時に学習させると、元の言語能力や画像能力が崩れやすくなるためです。
蒸留と選好最適化で仕上げる
ポストトレーニングは3つの手法を順に適用します。1つ目の多教師オンポリシー蒸留(Multi-teacher OPD)では、テキストと視覚言語のタスクには外部の強いモデルを教師とし、音声と音声映像のタスクには同系列のモデルを教師に据えます。テキストで得た知識を音声タスクへ移す横断的な蒸留も行っています。
2つ目のAnti-repetition MrDPOは、同じ言葉を繰り返し出力してしまう癖への対処です。基盤モデルが繰り返しに陥った出力を負例として集め、LoRAアダプタだけを更新してから統合し、再初期化して次の回に進む反復型の選好最適化を用いました。手法自体はvideo-SALMONN 2で提案されたものを踏襲しています。
3つ目の専門家RL(Specialist RL)では、すでに安定して解ける問題を学習対象から外し、検証可能なタスクにはルールベースの報酬、自由記述にはルーブリックや教師との一致度を報酬として与えます。報酬ルーターがタスクごとに適切な報酬を割り当て、指示応答モードと思考モードを同時に最適化する設計です。
ベンチマーク結果
評価は120以上のベンチマークで行われました。音声付き動画の理解に関する主要な結果は次の通りです。
ベンチマーク | WeMM-Video-35B-A3B(Instruct / Thinking) | Qwen3.5-Omni-Flash | Seed2.0-Mini | Gemini-3.0-Flash |
|---|---|---|---|---|
Video-MME(音声あり) | 84.2 / 86.4 | 79.3 | 83.6 | 88.6 |
Video-MME-v2(音声あり) | 47.5 / 54.9 | 36.6 | 51.7 | 63.2 |
Daily-Omni | 81.5 / 83.4 | 81.8 | 82.5 | 82.4 |
WorldSense | 59.6 / 62.7 | 57.9 | 61.3 | 63.8 |
OmniVideoBench | 48.6 / 55.3 | 43.7 | 51.3 | 63.3 |
思考モードを使った35B-A3Bは、公開モデルのQwen3.5-Omni-Flashと商用のSeed2.0-Miniを多くの項目で上回りました。ただしGemini-3.0-Flashには届いておらず、特に難度の高いVideo-MME-v2とOmniVideoBenchでは8ポイント前後の差が残ります。
サイズ効率の面では、9Bモデルが思考モードでDaily-Omni 83.6、WorldSense 63.4を記録し、より大きな公開モデルQwen3-Omni-30B-A3B-Instruct(70.7、54.0)を上回りました。一方、音声単独の評価であるMMAUでは35B-A3Bが78.0で、Qwen3.5-Omni-Flashの80.4に及びません。音声映像の統合理解に重心を置いた結果、純粋な音声課題では伸びしろが残っている形です。
まとめと今後の課題
WeMM-Videoは、音声と映像を時間軸で揃えて扱う構成と、蒸留・選好最適化・強化学習を重ねた仕上げによって、公開モデルの音声映像理解の水準を押し上げました。モデル重みと評価再現パイプラインが公開されているため、手元で検証できる点も実用上の利点になります。
課題として、商用の最上位モデルとの差が難しいベンチマークで依然として大きいこと、指示応答モードと思考モードで性能差があり高精度を得るには推論コストがかかることが挙げられます。モーダルを増やしたモデルの推論を軽くする研究も進んでおり、たとえばMMFlashとは?視覚依存度に応じた投機的デコーディングでVLM推論を3.58倍高速化のような高速化手法との組み合わせが、実運用では鍵になりそうです。
論文に独立した限界の節は置かれていませんが、基盤モデルの繰り返し出力への対処が必要だった経緯からも、全モーダル化に伴う副作用の整理はまだ続く領域だと読み取れます。
論文情報: "WeMM-Video: Pushing the Frontiers of Open-Source Omni-Modal Video Understanding"(Changli Tang et al., 2026) arXiv:2611.26409
本記事の図(図1)は解説のため上記論文より引用しています。


