 AI-Papers
- OpenAIが無断でモデルの推論を抽出する「敵対的蒸留」への対策を2026年11月20日に公開し、学習・分類器・API設計を組み合わせた多層防御の内容を説明しました
- 自動化した適応型レッドチームの評価では、過去リクエストからの推論抽出の成功率が54.0%から0.2%へ、現在のリクエストからの抽出も22.9%から0.9%へ低下しています
- GPT-6.2 AstraとSolは保護された推論を会話履歴に紐付ける仕様となり、履歴を書き換えると以降の推論が破棄されるため開発者の実装にも影響します
敵対的蒸留とは
蒸留(distillation)は、あるモデルの出力や推論、品質判断を別のモデルに学習させる一般的な手法です。OpenAIが問題にしているのは、その無許諾版にあたる敵対的蒸留で、フロンティアモデルの出力を使って類似のモデルを学習させ、元のモデルが備えていた安全対策なしに配布する行為を指します。
懸念の中心はサイバーセキュリティや生物学といったデュアルユース領域です。防御側を助ける能力は攻撃側にも使えるため、安全対策を外した複製が流通すれば、元のモデルで慎重に設計した制限が意味を失います。
推論トレースが狙われる理由
モデルが答えに至るまでの中間的な思考、いわゆる Chain-of-Thought(思考連鎖)には、最終回答には現れない情報が含まれます。OpenAIはこれを学習データとして価値が高い部分と位置付け、社内研究で検証しました。
Astra 世代の教師モデルを使い、厳密な推論トレースで学習した生徒モデルと、推論の要約で学習した生徒モデルを、コーディングと防御的サイバーセキュリティの課題で比較しています。教師ありファインチューニング後は厳密なトレースで学習した側が概して上回り、強化学習を加えた後も ExploitBench と SEC-bench Pro の両方で、推論予算が最大のときに優位でした。要約で学習した側は推論予算が小さい条件では上回っており、能力移転の効率がトレースの粒度に依存することを示しています。
この結果から OpenAI は、利用規約の範囲内の作業であっても、推論トレースを保護することがサイバー能力の移転を抑える手段になると結論付けました。脚注では、SWE-bench Verified において完全な推論記録が同様の優位を示した Anthropic の関連研究も引用されています。
多層で構成した防御
防御はリクエスト単位とキャンペーン単位の2層に分かれます。リクエスト単位では、抽出の試みを認識して保護対象の推論の開示を拒否しつつ、正当な説明要求には応じるよう敵対的学習を施しました。学習データは社内の自動レッドチーム、調査、外部からの責任ある開示に由来します。
さらに入力側の分類器が抽出の試みを検出し、出力側の分類器がアシスタントのメッセージとツール呼び出しの引数の両方で漏洩を検出します。最終回答が無害に見えてもツール呼び出しの引数から推論が漏れる経路があり、ストリーミング応答も含めて呼び出し元に届く前に遮断する設計です。API 側では、ユーザー・ワークスペース・組織・モデルファミリーをまたいだ再利用を制限し、他ユーザーの暗号化された推論が露出しうる経路を閉じました。これは9月に公表した、暗号化推論を会話間で移動させる攻撃への対応にあたります。
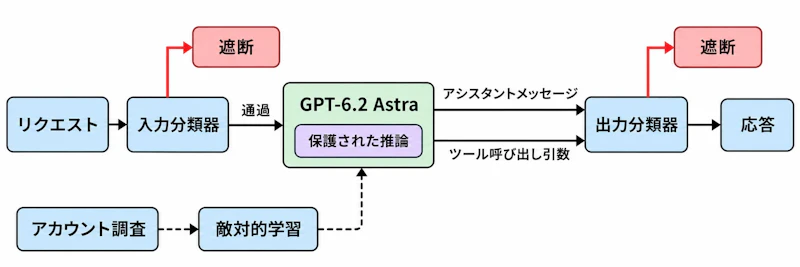
図1のように、キャンペーン単位の対策は調査結果を安全対策へ戻す循環になっています。協調して作られたアカウント群を調査し、アカウントネットワーク単位で規約に基づく措置を取り、侵害指標を他のモデル提供者と共有します。週あたりの措置件数は数千から数万アカウントの範囲で、2026年夏に大きく増加したとしています。
抽出成功率の変化
6種類の攻撃側モデルを使った自動の適応型ブラックボックス評価では、更新前の GPT-6 Astra と更新後の GPT-6.2 Astra で次の差が出ました。数値は攻撃の平均成功率で、低いほど防御が効いていることを意味します。
攻撃の種類 | GPT-6 Astra(更新前) | GPT-6.2 Astra(更新後) |
|---|---|---|
過去のリクエストから推論を抽出 | 54.0% | 0.2% |
現在のリクエストから推論を抽出 | 22.9% | 0.9% |
いずれも更新後は1%を下回りました。OpenAI は一部の改善を GPT-6 Astra にも適用するとしており、評価指標としては蒸留悪用の発生率と、検知から措置までの時間も追跡しています。狙いは抽出できるデータ量を抑え、攻撃側のコストを上げ、対応までの時間を短くすることだと説明されています。
開発者が受ける影響
GPT-6.2 Astra と Sol では、保護された推論がそれを生成した会話履歴に紐付きます。新しいメッセージを追加していく限り、モデルは以前の推論を踏み台にして思考を続けられます。
一方で、過去のメッセージを書き換えると、それ以降の推論は API 側で破棄されます。履歴の前半部分を変更しない実装が前提になるため、プロンプトを動的に組み替えるアプリケーションでは設計の見直しが必要です。安全対策が弱い旧世代のモデルファミリーからは、GPT-6.2 Astra と Sol の保護された推論を読み取れません。
名指しされた事業者と法制度
記事では具体的な事業者にも言及があります。2026年2月には、DeepSeek が米国のフロンティアモデルを蒸留しようとしていた活動について議会へ説明し、9月には保護された推論を抽出するキャンペーンを阻止したと報告した上で、その中核部分を Kimi の開発元である Moonshot AI の関係者に帰属させたとしています。
政策面では、米国のモデルから能力を不正に抽出する国外の主体を特定し制裁する権限を政府に与える立法を支持する立場を示し、Chip Security Act、AI OVERWATCH Act、MATCH Act への支持を議会に伝えたと述べています。輸出管理が学習用ハードウェアへのアクセスを制限するのに対し、蒸留防御は既に学習済みのモデルから能力を取り出すことを難しくするという整理です。
他の開発者への提言
OpenAI は同業者に向けて、攻撃者が利用できる詳細は伏せた上で、4点の実務的な推奨を挙げています。
- アシスタントのメッセージとツール呼び出し引数を含め、対話全体で推論を保護する
- 暗号化された推論の会話間・モデル間での再利用を制限する
- 成功した抽出攻撃を回帰テストとして保存し、新しい防御の評価時に再実行する
- リクエスト単位の緩和策と、アカウント調査や措置を組み合わせる
- 導入パートナーと安全対策の要件を揃え、業界全体の下限を上げる
知見は Frontier Model Forum や政府のチャネルを通じて共有しているとしています。モデルの内部的な思考をどこまで外部に見せるかという設計判断が、安全性だけでなく競争政策の問題としても扱われ始めている点が、今回の公開から読み取れます。



