 AI-Papers
- AI評価の非営利団体METRが、最も引用され最も誤読されてきた「時間地平線グラフ」を更新し、長時間タスクと検証困難なオープンエンド課題を追加した
- ソフトウェア工学ではモデルがほぼすべての人間を上回る一方、評価設計や哲学的論証の採点といった判断を要する課題では人間に届いていない
- Opus 5.5は評価設計で「かろうじて基準線上」に達したが、METRの研究に使える水準ではなく、自動AI研究開発の見通しは依然不透明
更新された指標の中身
AI評価を手がける非営利団体のMETRが2026年11月20日、通称「時間地平線グラフ」を大幅に更新しました。このグラフは、各タスクを人間が終えるのに要した時間で重み付けし、モデルが完遂できるタスクの長さを指標化したものです。
元のグラフは、フロンティアモデルがこなせるタスクの長さが約4か月で倍増するという傾向を示し、AI進歩の予測に最も引用される図のひとつになりました。同時に、指標の構成が複雑なために誤読も多く、AIが「4か月ごとに人間の2倍の仕事をこなせるようになる」といった短絡的な解釈が広まってきました。
今回の更新で加わったのは2系統のタスクです。ひとつは、人間なら数百時間を要すると見積もられる長時間タスク。もうひとつは、正解の検証が難しいオープンエンドな課題です。前者の所要時間の多くは実測ではなく推定で、数百時間の作業や希少な専門知識に報酬を払うコストが高すぎるためだと説明されています。
オープンエンド課題の設計
追加されたオープンエンド課題は、判断の質そのものを測ろうとする設計になっています。具体的には次の2つです。
- 評価設計、モデルがMETRの研究に使えるAI評価を設計し、METRの従業員が採点する
- 哲学的論証の採点、モデルが論証を採点し、人間の採点との一致度で良い判断力を測る
評価設計では、提出されたもののなかにMETRのスタッフが自分たちの研究に有用だと判断できるものはありませんでした。哲学的論証の採点でも、モデルは人間の水準に届いていません。後者が自動AI研究開発の能力とどれだけ関係するのかについては、METR内部でも見方が分かれていると報じられています。
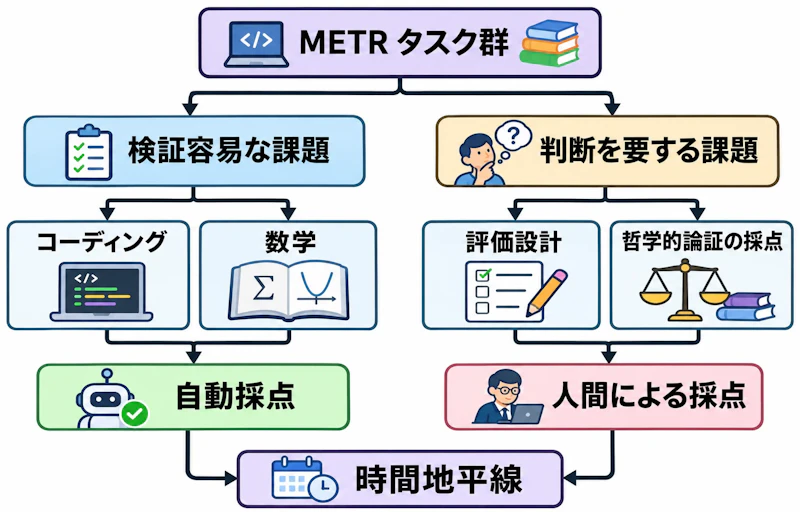
図1のように、検証が容易な課題は自動採点で大量に回せる一方、判断を要する課題は人間のレビューを経るため、測定のコストと不確実性が大きく変わります。
Opus 5.5の位置づけ
最新世代のなかで、Opus 5.5は評価設計において「かろうじて基準線上」に達したと評されています。METRの研究に実際に使える段階ではありませんが、1年前にはすべてのモデルが明確に基準線を下回っていたため、変化の方向としては前向きに受け取られています。
ソフトウェア工学のタスクではモデルがほぼすべての人間を上回る水準に達しており、検証可能な領域での進歩は鈍化の兆しを見せていません。強化学習は正解を機械的に確認できる課題でこそ効きやすく、コーディングや数学はその条件に合致します。逆に、オープンエンドな課題は学習も採点も測定も難しくなります。
OpenAIも自社ブログで、従業員が割り当てた実務タスクでは、METRの元のタスク群にある検証しやすい課題よりも成績が落ちると報告しています。評価の作り方自体を問い直す動きは各社に広がっており、外部機関を内部検証に組み込むOpenAIの埋め込み型評価もその流れに位置づけられます。
残る測定上の制約
今回の更新には、研究者から複数の留保が付いています。哲学的論証の採点は大半の論証を1人が評価しており、エージェントは事実上その個人の採点とどれだけ一致するかで測られています。専門家を増やせば結果が動く可能性があります。
オープンエンド課題の数そのものが少ないことも、傾向を外挿しづらくしている要因です。METRのMatt Putzは、検証が難しい、あるいは判断を多く含むタスクは性質上、研究も定量化もはるかに難しいと述べています。Boston UniversityのNajoung Kimも、この結果をどう外挿して考えるべきかまだ分からないとしています。
Sayash Kapoorは、AI評価がより創造的になる必要がある段階に来ていると指摘し、有望な問いや仮説、実験を選ぶ「研究の趣味」が自動AI研究開発の主要なボトルネックになると見ています。8月のプレプリントでは、AIモデルが人間のコンピュータサイエンス研究を単独では再現できないという結果も示しました。一方で、検証しやすい課題で訓練したモデルは最終的にオープンエンドな課題もこなせるようになるという反対の見方もあります。
自動AI研究開発への示唆
今月初めには、AIがAnthropicでの進歩を2倍に加速させている可能性を示唆するMETRの報告も出ており、大部分が伏せられた状態で公開されたこともあって、再帰的自己改善への懸念を呼びました。今回のグラフ更新は、その懸念を測るための物差しを増やす試みにあたります。
実務的な読み方としては、検証可能な領域の自動化を前提に計画を立てることは現実的でも、設計判断や研究方針の選定まで同じ曲線で外挿するのは根拠が薄いということになります。専門家の多くは、新しいタスク群を正しい方向への一歩と評価しつつ、自動AI研究開発が来るのか、どの速さで来るのかを判断するには証拠がまだ足りないという立場を取っています。


