 AI-Papers
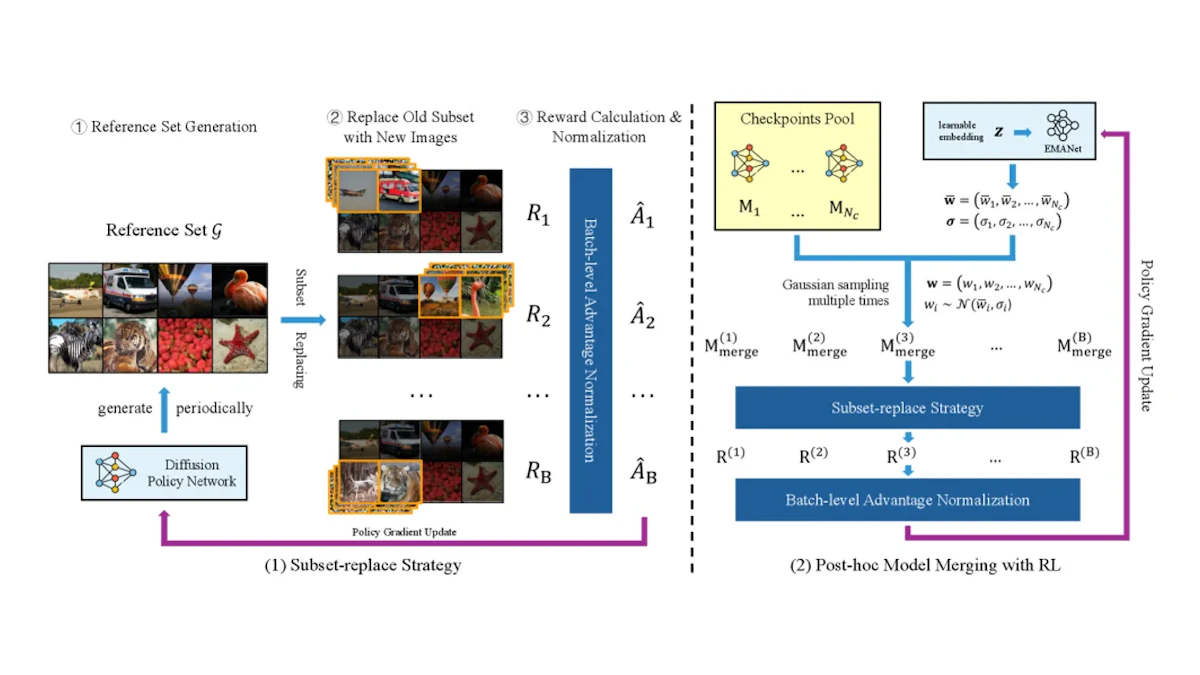
- 従来のサンプル単位RL報酬が引き起こすモードコラプスと視覚的アーチファクトを、生成分布全体を実データと比較するDistribution-wise Rewardで根本解決
- 計算コストを抑えるSubset-Replace戦略で参照セットの一部のみ置換してFIDを報酬に活用。SiTモデルのFID-50Kを8.30から5.77へ大幅改善
- ICML 2026採択。SiT・EDM2双方で有効性を確認し、幅広い視覚生成モデルに適用できる汎用フレームワーク
研究の背景
近年、視覚生成モデルの品質向上に強化学習(Reinforcement Learning、RL)を活用する研究が増えています。報酬モデルを用いて生成画像を評価し、その報酬を最大化するよう学習するアプローチで、画像の美しさやプロンプトへの忠実度を高める効果があります。
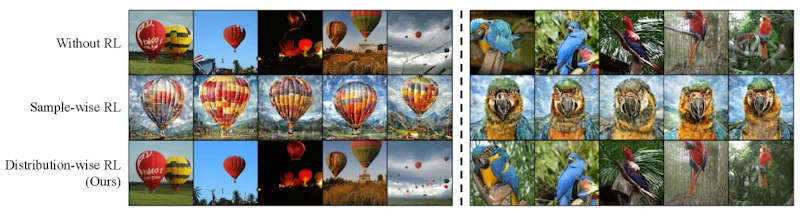
しかし、従来の手法には根本的な問題があります。報酬を画像1枚ずつ計算する「サンプル単位の報酬」を使うと、モデルが報酬を得やすい特定のパターンに偏り始めます。これをリワードハッキングと呼び、放置すると生成サンプルの多様性が失われる「モードコラプス(モード崩壊)」が発生します。
さらに、虹色の縞模様や画像の歪み、不自然なビネット(周辺減光)といった視覚的なアーチファクトも出現しやすくなります。本論文はこの問題に正面から取り組み、ICML 2026で発表された成果です。
分布単位の報酬とは
本研究が提案するのは、サンプルを1枚ずつ評価するのではなく、生成サンプルの集合(分布)全体を実データの分布と比較する「Distribution-wise Reward(分布単位の報酬)」です。
具体的には、FID(Fréchet Inception Distance)などの分布間の距離指標を報酬として使用します。FIDは実データの分布と生成データの分布がどれだけ近いかを測る指標で、値が小さいほど品質が高いことを意味します。分布全体を見るため、モデルが特定パターンに偏ることを自然に抑制できます。
サンプル単位の報酬では「この1枚を良くする」最適化が多様性を壊すのに対し、分布単位の報酬では「分布全体を実データに近づける」最適化が求められるため、モデルはさまざまな種類の画像を生成せざるを得なくなります。iRDMなど分布マッチングを活用した1ステップ生成モデルでも類似の考え方が効果を上げており、分布レベルの評価が生成品質向上の鍵として注目されています。
提案手法の詳細
分布単位の報酬をRL学習に組み込む際の最大の課題は計算コストです。FIDの計算には数千枚以上のサンプルが必要で、毎ステップ全サンプルを生成し直すのは現実的ではありません。
そこで本研究はSubset-Replace戦略を提案しています。あらかじめ参照セット(大きな画像集合)を用意しておき、各学習ステップではその一部だけを新しく生成したサンプルで置き換えます。置き換え後の集合に対してFIDを計算し、これを報酬として使います。参照セット全体を再生成する必要がないため、計算コストを大幅に抑えられます。
加えて、学習時と推論時の不整合も問題になります。RLの学習ではSDEベースの推論(確率的微分方程式)が使われることが多い一方、本番利用ではODEベースの推論(常微分方程式)が高速なため好まれます。この乖離を解消するため、Post-hoc Model Merging with RLも提案されています。複数のモデルチェックポイントを混合する際の重みをRLで最適化するアプローチで、ODE推論でもRLの恩恵を享受できるようになります。
実験結果
ImageNet 256×256のクラス条件付き生成タスクで評価を行いました。SiTモデルでは、RL適用前のFID-50Kが8.30でしたが、分布単位の報酬を適用することで5.77まで改善されました。一方、サンプル単位の報酬を使った場合はFID-50Kが34.26まで悪化しており、リワードハッキングの深刻さが数値でも裏付けられています。
すでに高品質なEDM2モデルにおいても有効性が確認されており、FID-50Kが3.74から3.52へ向上しました。アブレーション実験では、参照セットのサイズ・置き換え枚数・更新間隔といったハイパーパラメータの影響が詳細に分析されています。置き換えサンプル数は50枚、更新間隔は10ステップが最良という結果で、バッチレベルのアドバンテージ正規化も性能向上に寄与することが確認されました。
まとめと今後の展望
本研究は、RLによる視覚生成モデル改善の実践的な問題、すなわちサンプル単位の報酬が引き起こすモードコラプスとアーチファクトに対して、分布単位の報酬という明快な解決策を示しました。Subset-Replace戦略による計算コスト削減と、Post-hoc Model Mergingによる訓練・推論不整合の解消も実用面での貢献として評価されます。
SiT・EDM2いずれのベースモデルでも改善が確認されており、特定のアーキテクチャに依存しない点がこの手法の強みです。今後はText-to-Imageモデルや動画生成モデルへの応用、またFID以外の分布指標を報酬として活用する研究への展開が期待されます。
論文情報: "Optimizing Visual Generative Models via Distribution-wise Rewards"(Ruihang Li et al., 2026) arXiv:2607.02291, CC BY-SA 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。

