 AI-Papers
- 独立した視覚エンコーダとVAEを廃止したNEO-unifyアーキテクチャで、マルチモーダルの理解と生成をアダプタ不要で単一モデルに統合
- 8B密モデルと30B-A3B MoEの2バリアントを公開し、視覚推論・インフォグラフィック生成・VLA・世界モデルまで幅広いタスクで高性能を発揮
- LightLLM/LightX2Vによる分離推論設計で、2048×2048の高解像度画像生成を1ステップ約0.4秒で処理
理解と生成を分ける壁
マルチモーダルAIの研究では長年、「理解」と「生成」が別々のシステムとして発展してきました。視覚言語モデル(VLM)は画像を理解して質問に答えることは得意でも、新しい画像を生成することはできません。逆に拡散モデルは高品質な画像を生成できますが、複雑な質問応答や論理推論には対応していません。
この二分法は、実際の応用で大きな制約となります。「この画像を説明しつつ、別の視点から描き直して」「テキストと画像が混在した資料を理解しながら新しいインフォグラフィックを生成して」といった複合タスクには、複数モデルを組み合わせる複雑なパイプラインが必要でした。
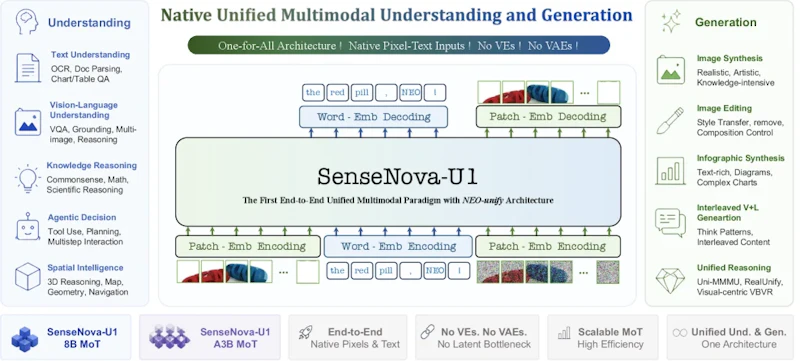
商湯科技(SenseTime)が発表したSenseNova-U1は、この分断を根本から解消しようとする試みです。理解と生成を「単一プロセスの相補的な側面」として統一的に扱うNEO-unifyアーキテクチャを提案し、アダプタ不要の真の統合モデルを実現しました。
NEO-unifyアーキテクチャの核心
従来の統合型マルチモーダルモデルの多くは、視覚エンコーダ(CLIP系)とVAE(Variational Autoencoder、変分オートエンコーダ)を別々に持ち、それらをLLMに接続する形を取っていました。NEO-unifyはこの設計を根本から見直し、これらの独立したコンポーネントを廃止しています。
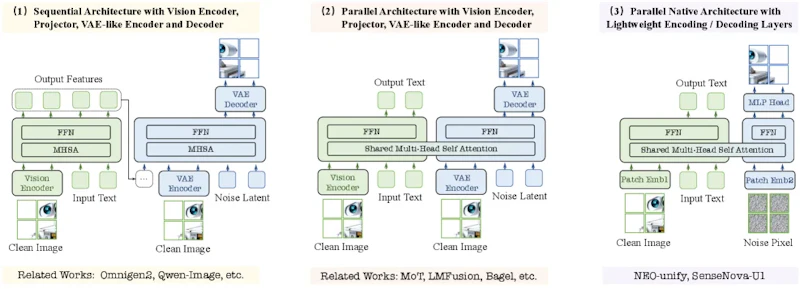
視覚入力の処理には、2層の軽量な畳み込みエンコーダを使用します。16×2のストライドで32×32パッチに変換する「ニアロスレス(損失がほぼゼロに近い)」な視覚インターフェースで、32倍の圧縮率にも関わらず高い画質を維持します。生成時は、同様に軽量なMLPベースのデコーダで直接ピクセル値を予測します。
バックボーンとなるのがネイティブMixture-of-Transformers(MoT)です。理解ストリームと生成ストリームがパラメータを完全に分離しつつ、1つのモデル内で共存します。テキストトークンは因果マスク(過去のトークンのみを参照する標準的な仕組み)で処理され、画像トークンは画像スパン内を双方向に参照できる独自のアテンションパターンを持ちます。
2種類のモデルバリアント
SenseNova-U1は用途に応じた2つのバリアントを公開しています。
- SenseNova-U1-8B-MoT:8Bパラメータの密モデル。理解・生成ストリームが対称的な並列構造を持ち、バランスの取れた性能を発揮
- SenseNova-U1-A3B-MoT:総パラメータ数30B、実際に活性化されるのはA3B相当のMoE構成。理解側は128エキスパート中トップ8を選択、生成側は32エキスパートを持つ
MoE(Mixture of Experts、専門家混合)構成のA3B-MoTは、理解タスクにより多くの専門化されたエキスパートを割り当てることで、推論・知識問答での高性能を維持しながら計算コストを抑えています。
6段階の学習パイプライン
SenseNova-U1の学習は6つの段階で構成されています。まず理解側のウォームアップを行い、続いて生成の事前学習を3フェーズ・合計30万ステップで実施します。その後、理解と生成データを混合した統合中間学習(8.4万ステップ)、教師ありファインチューニング(9千ステップ)、テキスト描画・スタイル・審美性に関する報酬を用いた強化学習によるポストトレーニングと続き、最後にステップ蒸留(100ステップから8ステップへ削減)で推論速度を大幅に改善しています。
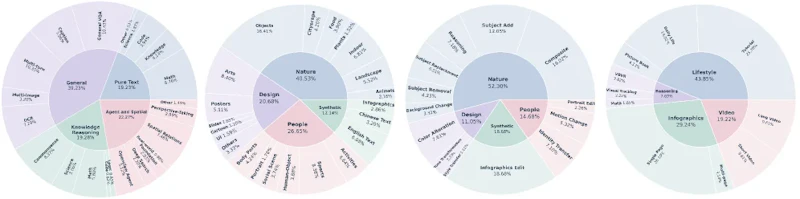
理解コーパスの構築では、10の垂直ドメインにわたる大規模マルチモーダル指示データを、分布バランス調整・プロンプト拡張・多基準品質フィルタリングの3段階で処理しています。生成コーパスは、低レベルフィルタリング・重複排除・VLMキャプショニング・品質フィルタリングの4段階パイプラインで高品質なデータを確保します。
分離推論アーキテクチャ
推論設計にも独自の工夫があります。SenseNova-U1は推論を2つのエンジンに分離しています。LightLLMがマルチモーダル理解・テキストストリーミング・制御フローを担当し、LightX2Vが画像生成を担当します。2つのエンジンはPinned Shared Memory(GPUとホストメモリ間でゼロコピー転送を実現するメモリ管理技術)を介して生成状態を交換します。
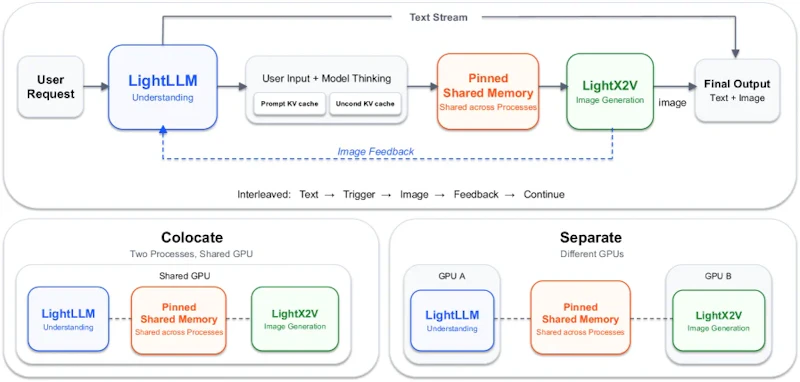
この分離設計により、テキスト側にはテンソル並列処理、画像生成側にはClassifier-Free Guidance並列処理を独立して適用できます。RTX 5090やL40S GPUでの測定では、2048×2048の高解像度画像生成を1ステップ約0.4秒で処理する速度を達成しており、理解と生成で異なるリソース要件を効率的に充足できる設計です。
主要ベンチマークの結果
公開されたベンチマーク結果では、理解・推論・生成の全方面で競合モデルと遜色ない性能を示しています。理解タスクではMMBench-EN(マルチモーダル総合評価)で91.59%(A3Bスケール)、MMMU(大学レベルのマルチモーダル理解)で74.78%を達成しています。
視覚生成ではGenEval(テキストに忠実な画像生成評価)でスコア0.91、TIIF(テキスト密度の高い画像生成)で89.74を記録します。空間推論を要するVSI-Benchでは62.66%、立体的空間理解を測るMindCube-Tiny(A3B)では70.86%という結果も示されています。同種の統合モデルとしてQwen-Image-2.0も理解と生成の統合に取り組んでいますが、SenseNova-U1の特徴はアダプタを完全に排除した「ネイティブ統合」の徹底にあります。
VLAと世界モデルへの展開
SenseNova-U1の応用範囲は画像理解・生成にとどまりません。論文ではVLA(Vision-Language-Action、視覚言語行動)モデルとしての活用例も示されています。ロボットアームの映像を入力として次の行動を予測するタスクや、ロボット視点からの世界モデル(次の状態を予測する生成タスク)にも対応しています。
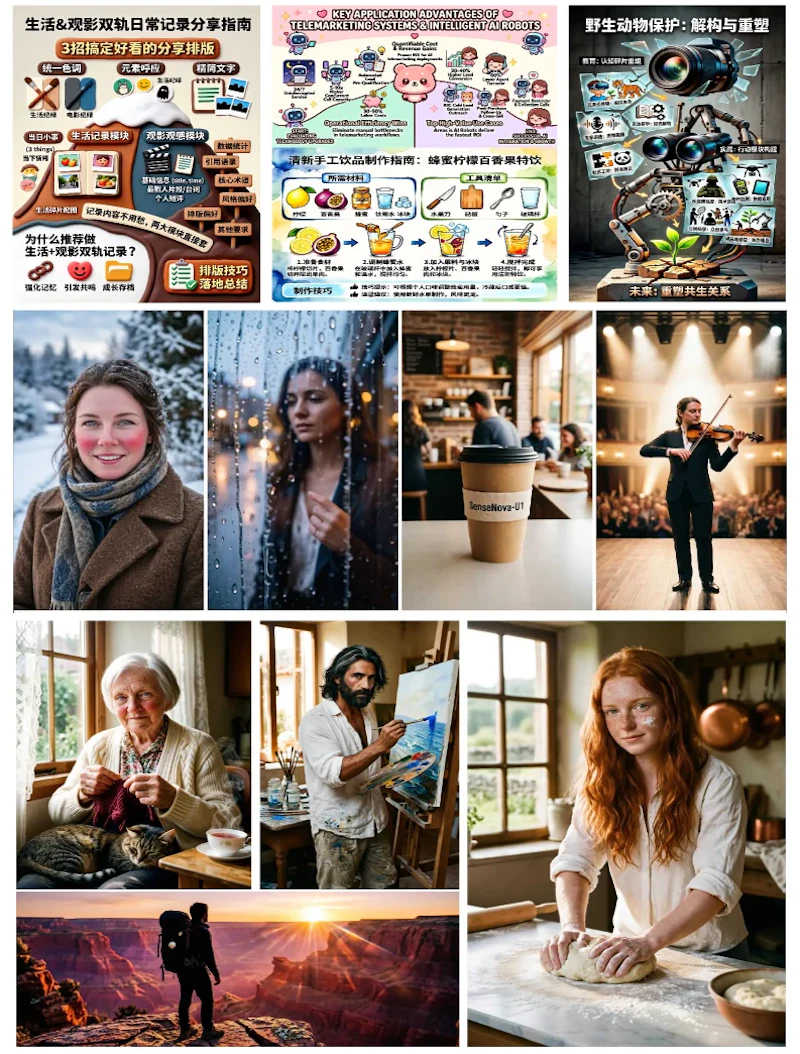
インフォグラフィック生成では、テキストと図形・レイアウトを組み合わせた複雑な視覚コンテンツを出力できます。これは理解側で獲得したテキスト・レイアウト構造の知識が生成側に自然に転移する、真の統合アーキテクチャならではの特性です。
まとめ
SenseNova-U1は、マルチモーダルAIにおける「理解と生成の分断」という根本的な問題に正面から取り組んだ研究です。独立したエンコーダ・デコーダを廃したNEO-unifyアーキテクチャ、6段階の精緻な学習パイプライン、分離推論による効率的なデプロイ設計を組み合わせることで、単一モデルで幅広いタスクをカバーしています。
GitHub公開直後に1,580スターを記録した高い注目度は、アダプタ不要の真の統合への研究コミュニティの期待の大きさを示しています。VLAや世界モデルへの展開可能性も示されており、ロボティクスをはじめとした物理世界への応用を見据えた今後の発展が待たれます。
論文情報: "SenseNova-U1: Unifying Multimodal Understanding and Generation with NEO-unify Architecture"(Haiwen Diao et al., 2026) arXiv:2605.12500
本記事の図(図1〜図5)は解説のため上記論文より引用しています。


