 AI-Papers
- 14次元アダプティブマージゲノムで複数LLMを重み空間で進化的に組み合わせ、追加訓練なしにGPQA Diamond 86.9%(1252モデル中6位)を達成
- MRI-Trust Fusionが層重要度診断と進化的探索を学習可能なパラメータτ(0.35〜0.55)で統合し、ゲノムのみより+2.5ポイント向上を実現
- Architecture MapperがTransformerとMambaなど異種アーキテクチャ間の交配を可能にし、4B〜35Bのスケールで一貫した改善を確認
研究の背景
Large Language Model(LLM)の推論能力を高めるには、大量のGPUを使った事後学習(post-training)が一般的です。強化学習や教師ありファインチューニングによって性能を引き上げる手法が主流ですが、計算コストが高く、多くの研究機関や個人開発者にとって現実的ではありません。
そこで注目されているのが「モデルマージ」というアプローチです。複数の既存モデルの重みを重み空間で統合することで、追加学習なしに性能を高めようとする研究が近年活発になっています。しかし従来のマージ手法は、各レイヤーの重要度を考慮せず、どのモデルをどの比率で混ぜるかを事前に固定するケースが多く、最適なマージ戦略の探索が困難という課題がありました。
Darwin Familyの概要
「Darwin Family」は、この課題に取り組むために提案された訓練不要の進化的モデルマージフレームワークです。生物進化のメカニズムを模倣し、複数のLLMを「親モデル」として交配(クロスオーバー)・突然変異させながら、最適なマージ戦略を自動で探索します。
フレームワークの核心は、どのレイヤーをどの比率でどのように混ぜるかを「ゲノム」と呼ばれるパラメータベクトルで表現する点にあります。このゲノムを進化的アルゴリズムで最適化することで、勾配更新を一切行わずに推論特化型のモデルを生み出せます。
3つの主要技術
14次元アダプティブマージゲノムは、マージ戦略をコンポーネント単位・ブロック単位で細かく制御する仕組みです。グローバルな重み比率、Attention(注意機構)層とFeed-Forward(全結合)層・埋め込み層ごとの重み、スパース化の密度、ブロックレベルの係数など14種の次元を持ち、非常に精密な組み合わせを表現できます。
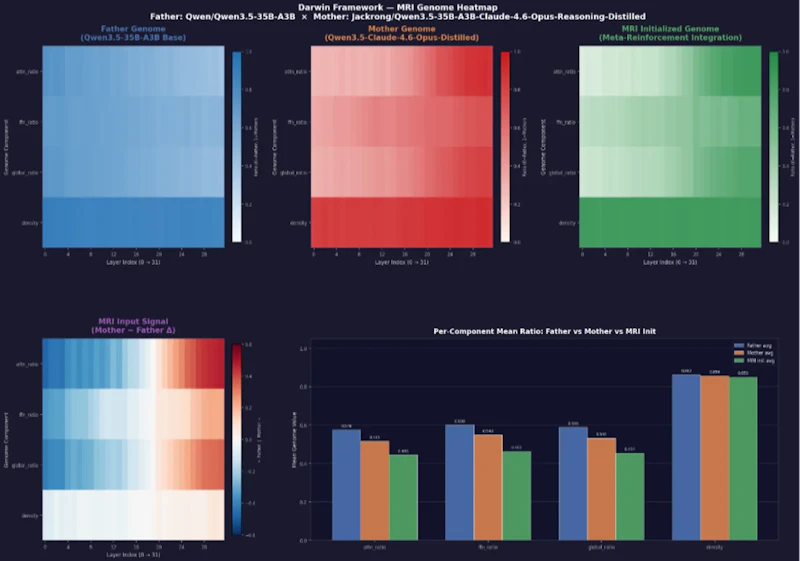
MRI-Trust Fusionは、診断的な層重要度信号と進化的探索のバランスを学習可能なパラメータτで制御する機構です。各テンソルの最終的な混合比を r_final(T) = τ · r_MRI(T) + (1−τ) · r_genome(T) の式で決定します。実験で収束したτ値は0.35〜0.55の範囲に集中しており、診断信号のみでも無制約探索のみでも不十分なことを示しています。進化したゲノムはAttentionモジュールを保護しながら、Feed-Forward層を積極的に再結合する傾向が見られました。
Architecture Mapperは、異なるアーキテクチャ間のテンソル互換性スコアを計算することで、TransformerベースのモデルとMambaベースのモデルを組み合わせるクロスアーキテクチャ交配を可能にします。従来のモデルマージが同一アーキテクチャに限定されていたのに対し、Darwin Familyは異なる設計思想を持つモデル間でも重みを交換できます。
進化的最適化プロセス
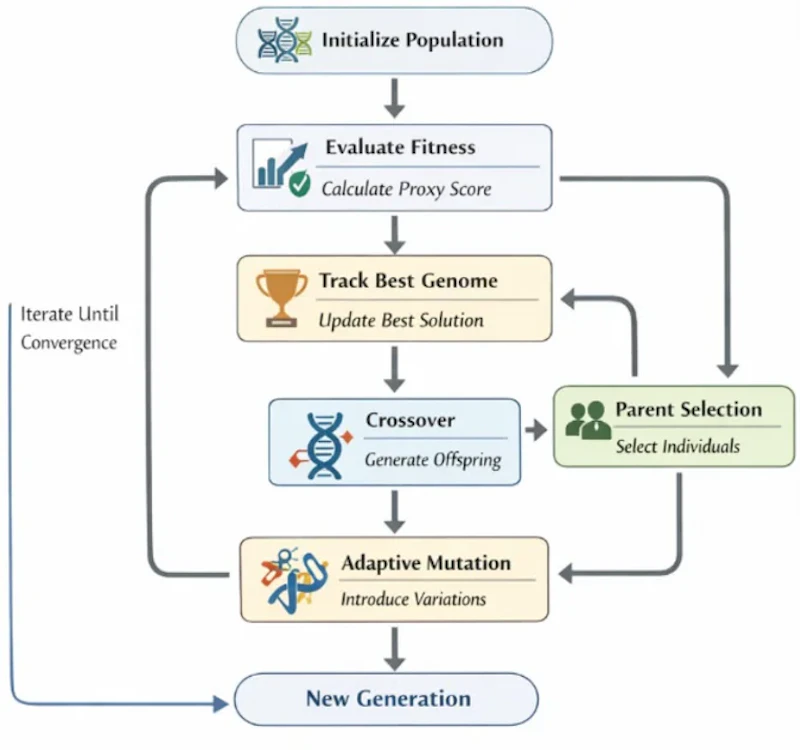
最適化は2フェーズで進行します。Phase 1では、候補ゲノムを代理評価(プロキシ評価)で効率的に評価しながら、選択・交叉・突然変異を繰り返してゲノム集団を進化させます。このループは収束するまで続き、高品質なゲノム候補群を特定します。Phase 2では、絞り込まれたゲノム候補を実際のベンチマークで評価し、最終モデルを選定します。
再帰的な多世代進化もサポートしており、生成されたモデルを次世代の親モデルとして再投入することで、さらなる性能向上を追求できます。
DARE-TIESマージカーネル
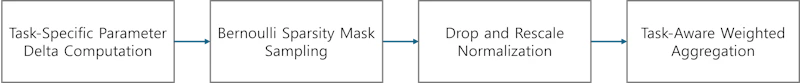
実際のパラメータ統合にはDARE-TIESマージカーネルが用いられます。ベースモデルとの差分(パラメータデルタ)にベルヌーイマスクを適用してスパース化し、生き残ったエントリを期待値が保たれるようリスケールした後、ゲノムで指定された混合係数で各モデルの寄与を統合します。この手続きにより、複数モデルの専門知識が衝突(destructive interference)する問題を緩和しています。
実験結果
フラッグシップモデル「Darwin-27B-Opus」は、GPQA Diamond(大学院レベルの難解な科学的推論ベンチマーク)で86.9%を記録し、1252モデル中6位という順位を達成しました。9つのベンチマークの平均スコアは0.786(±0.040)で、ARC-Challengeでも77.9%を記録しています。いずれも親となるベースモデルを上回る結果です。
アブレーション実験では、MRI-Trust FusionがGPQA相対でゲノムのみの場合より+2.5ポイント向上に寄与し、学習可能なτを固定値とした場合より+0.9ポイントの改善をもたらすことが確認されました。性能向上は4B〜35Bのモデルサイズにわたって一貫しており、進化したゲノムに繰り返し現れる構造的パターンは、サイズ固有の最適化ではなくスケール不変の原理を発見していることを示唆しています。
高性能な推論モデルの実現には大量の計算資源を投じた事後訓練が必要とされてきましたが、SU-01のような訓練ベースの高性能推論モデルと比べても遜色のない水準を、訓練コストゼロで達成した点は特筆に値します。
まとめと今後の展望
Darwin Familyは、勾配更新を一切必要とせずに複数のLLMを進化的に組み合わせることで、高額なGPU計算なしに推論特化モデルを生み出せることを実証しました。14次元ゲノム・MRI-Trust Fusion・Architecture Mapperという3つの技術の組み合わせが、単純なモデルマージを超えた体系的な探索を可能にしています。
NeurIPS 2026への投稿論文として、今後のレビューとコミュニティからの検証が進む見込みです。論文が示すように、このアプローチは「コストのかかる事後訓練パイプラインへの実用的かつ再現性の高い代替手段」となりうるものです。計算資源の制約を抱える研究機関や個人開発者にとって有望な選択肢であり、異種アーキテクチャ間のマージ精度向上や、より大規模なモデルへの適用が今後の発展として期待されます。
論文情報: "Darwin Family: MRI-Trust-Weighted Evolutionary Merging for Training-Free Scaling of Language-Model Reasoning"(Taebong Kim et al., 2026) arXiv:2605.14386, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


