 AI-Papers
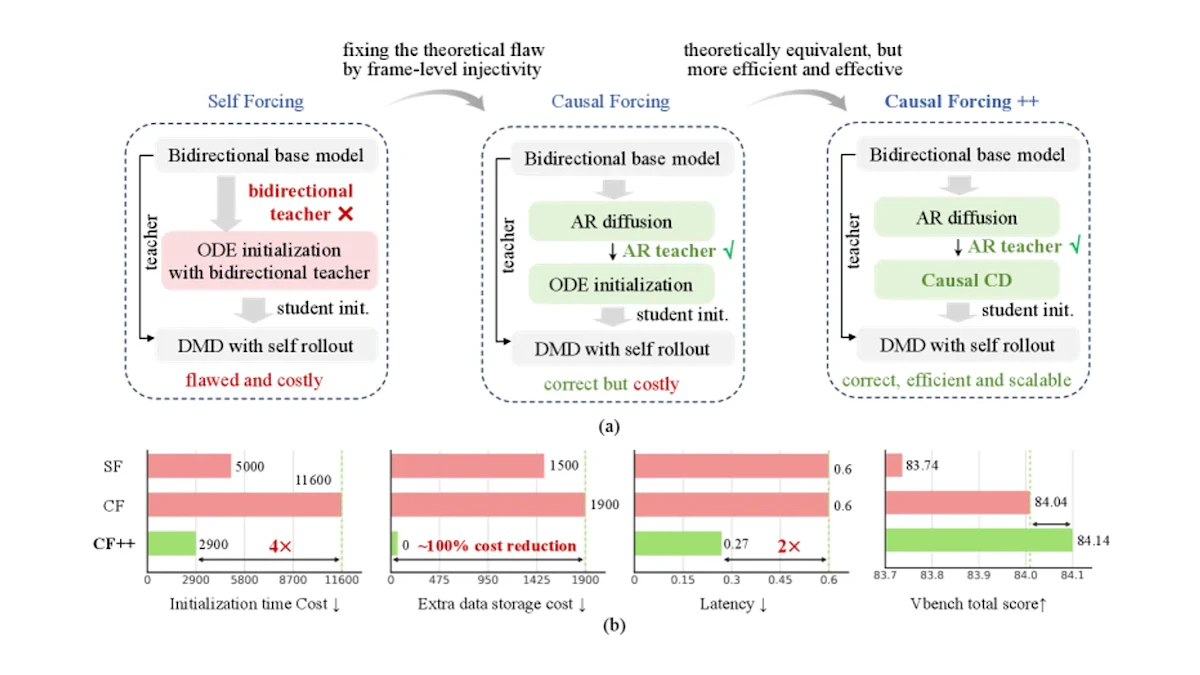
- 因果一貫性蒸留(Causal CD)を導入し、Stage 2訓練コストを約4倍削減しながらVBench品質スコア+0.3を達成
- フレーム単位1〜2ステップの超高速生成で初回フレームレイテンシを50%削減し、リアルタイム対話型動画生成を実現
- 露出バイアス問題に強い3段階訓練パイプラインにより、長い自己回帰ロールアウトでも安定した高品質を維持
研究の背景
ゲーム、ロボット制御、インタラクティブシミュレーションといった応用では、ユーザーの操作に即座に応答できる低遅延の動画生成システムが不可欠です。拡散モデル(Diffusion Model)は高品質な動画生成を得意とする一方で、通常は多数の推論ステップが必要であり、リアルタイム性との両立が大きな障壁になっていました。
この課題に対処するアプローチとして、自己回帰型(Autoregressive)の動画生成モデルをフレームひとつずつ順に生成しながら、蒸留によって推論ステップを極端に削減する手法の研究が進んでいます。特にフレーム単位で1〜2ステップのみでサンプリングする超高速生成は、リアルタイム対話型システムへの直接的な応用が見込まれる領域です。
既存手法の課題
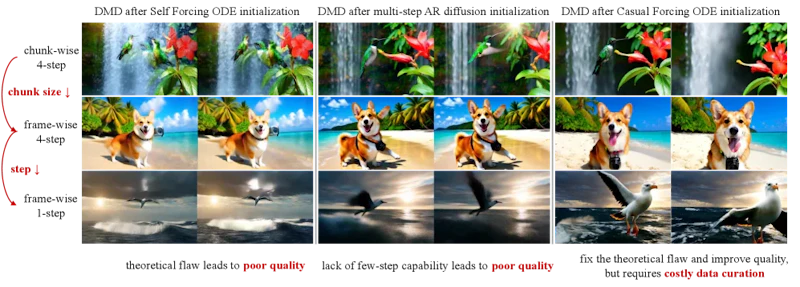
先行研究として、Self Forcing(SF)とCausal Forcing(CF)という2つのフレームワークがあります。Self Forcingは自己回帰ロールアウト中に学生モデル自身が生成したフレームを履歴として活用しますが、フレーム単位での単射性(Injectivity)が保証されないという理論的な欠陥を持ちます。この欠陥は特に少ないステップ数での生成において品質の不安定化につながります。
Causal ForcingはSelf Forcingの欠陥を修正し理論的正当性を確立しましたが、訓練時に自己回帰型の完全なODE(常微分方程式)軌跡を事前に生成・保存する必要があります。これにより11,600 A800-GPU時間に及ぶ膨大な訓練コストと1,900 GiBものストレージが必要となり、スケーラビリティが実用上の制約になっていました。
Causal Forcing++の提案手法
本研究が提案するCausal Forcing++(CF++)の中核は、「因果一貫性蒸留(Causal Consistency Distillation、Causal CD)」と呼ぶ新しい蒸留手法です。Causal ODE蒸留と同じ学習目標、すなわち自己回帰条件付きフローマップの推定、を保ちながら、教師信号の取得方法を根本的に変えています。
従来のCausal ODE蒸留が完全なODE軌跡を事前生成して大きなタイムステップ間隔で回帰するのに対し、Causal CDは隣接するタイムステップ間の1段階のみODE計算をオンラインで実行して教師信号を取得します。これにより大量の軌跡データの事前保存が一切不要となり、追加ストレージをゼロにしながら訓練コストを大幅に削減できます。
3段階の訓練パイプライン
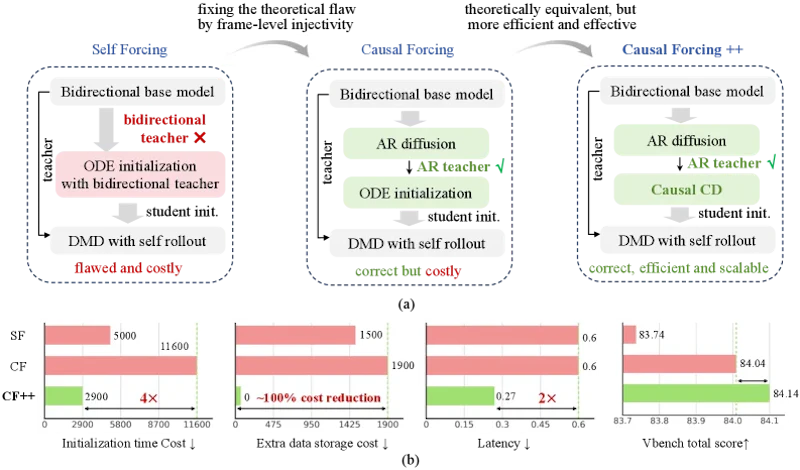
Causal Forcing++は3つのステージで段階的に訓練します。Stage 1では教師強制(Teacher Forcing)を使用した多段階AR拡散モデルを訓練し、高品質な基盤となる教師モデルを構築します。Stage 2でCausal CDを適用して少数ステップAR学生モデルの初期化を行います。そしてStage 3では双方向批評家(Bidirectional Critic)を用いた非対称DMD(Distribution Matching Distillation)で、学生モデルの自己ロールアウトをさらに最適化します。
Stage 3の初期化においてCausal CD対Causal DMD(スコアマッチング型蒸留)の比較も詳細に分析されています。Causal DMDはモード追求的な性質を持つため初期フレームの鮮明さには優れますが、自己回帰ロールアウトが進むにつれて履歴の誤差が累積し、品質が急速に劣化する「露出バイアス(Exposure Bias)」問題を引き起こします。Causal CDはモード網羅的な分布を維持するため、長い生成シーケンスでも安定した品質が保持されます。
また、任意ステップ対応の動画拡散蒸留フレームワークAnyFlowをはじめとする関連手法と比較しても、Causal Forcing++はリアルタイム性と品質のバランスにおいて独自の優位性を持ちます。フレームフロー写像に対してCausal CDを適用するという設計は、自己回帰型の時間構造を尊重しながら効率的に蒸留できる点で新規性があります。
実験結果
VBenchベンチマークにおけるフレーム単位2ステップ生成の評価では、Causal Forcing++は総合スコア84.14、品質スコア84.89を達成しました。Self Forcingの品質スコア84.59、Causal Forcingとの比較でも同等以上の水準を示しており、理論的正当性を犠牲にせず品質を向上させた点が確認されています。
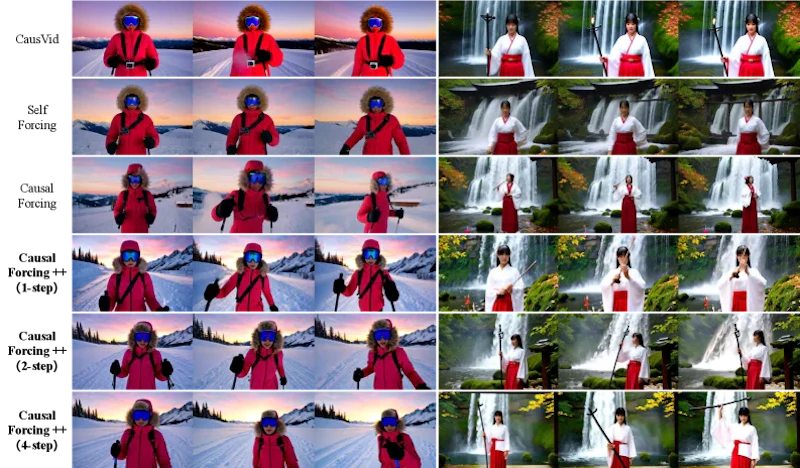
訓練効率の面では、Stage 2コストが11,600から約2,900 A800-GPU時間へと約4倍削減されています。事前ストレージも1,900 GiBからゼロとなり、大規模な計算クラスタなしでも研究・実装が現実的になりました。初回フレームレイテンシについては従来比50%の削減が報告されており、リアルタイム性への要件を大きく前進させる結果です。
応用実験として、カメラポーズを条件情報として与えるアクション条件付き世界モデルでの検証も行われています。「前進し続ける」「前進してからカメラを下方向に傾ける」といった複合操作に対して、ユーザーの入力に即応した動画を安定的に生成できることが確認されました。
まとめと今後の展望
Causal Forcing++は、因果一貫性蒸留という新しいアプローチにより、自己回帰型動画拡散モデルの蒸留が抱えていたコストと品質のトレードオフを実用的な範囲で解消しました。理論的正当性、訓練効率、生成品質という3つの軸でバランスの取れた改善を達成しています。
論文ではフレーム単位1ステップ生成による完全なリアルタイム動作がひとつの目標として示されており、品質とレイテンシのさらなる均衡探索が今後の課題として挙げられています。GitHubでのコード公開も予定されており、再現性を重視した研究姿勢は産業応用を見据えた実用的な成果として評価できます。一方で、1ステップ生成では品質と動的表現力の双方を維持することが依然として難しく、この限界を克服する手法の探索は引き続き重要な研究課題です。
論文情報: "Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation"(Min Zhao et al., 2026) arXiv:2605.15141, CC BY 4.0
本記事の図(図1、図2、図6)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


