 AI-Papers
- Challenger・Reasoner・JudgeのマルチエージェントSelf-Playループでコンテキスト固有スキルを人間監督なしに自動発見・精錬
- Cross-Time Replayで敵対的崩壊を防ぎ、CL-benchの4タスクでGPT-4.1のスコアを11.1%から16.5%に向上
- 人間のアノテーション・外部フィードバック不要で任意のLLMに適用可能。GitHubでコードが公開されており再現性が高い
研究の背景
現実世界では、法律文書・医療レポート・技術マニュアルのような複雑な長文コンテキストをLLMが正確に理解し、情報を引き出す「コンテキスト学習(Context-based Learning)」が求められます。こうした場面でLLMの精度を上げる有効な方法の一つが、コンテキスト固有の知識を「スキル」として体系化し、推論時に参照させることです。
しかし従来手法は、スキルの定義や精錬に人間のアノテーションや外部評価システムを必要とし、スケールするためのコストが課題でした。清華大学・DeepLang AI・UIUC・復旦大学・香港中文大学の共同研究チームは、この課題に取り組む自己進化フレームワーク「Ctx2Skill」をarXivで発表しました。
Ctx2Skillの全体像
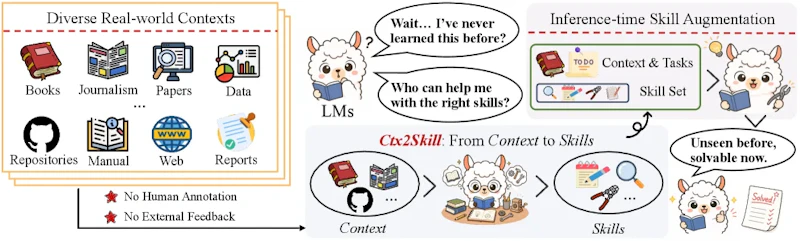
Ctx2Skillは、コンテキストドキュメントから「スキル」と呼ばれる自然言語の知識断片を自動抽出・進化させます。スキルとは、「このコンテキストを扱う上で必要な知識や手順を箇条書きで記述したもの」です。LLMが回答を生成する際にスキルセットを参照することで、コンテキスト固有の専門知識を補完できます。
特徴的なのは、スキルの精錬を人間に頼らない点です。代わりに複数のLLMエージェントが互いに対戦(Self-Play)しながらスキルを磨く設計になっており、外部フィードバックを一切必要としません。
3エージェントの自己対戦ループ
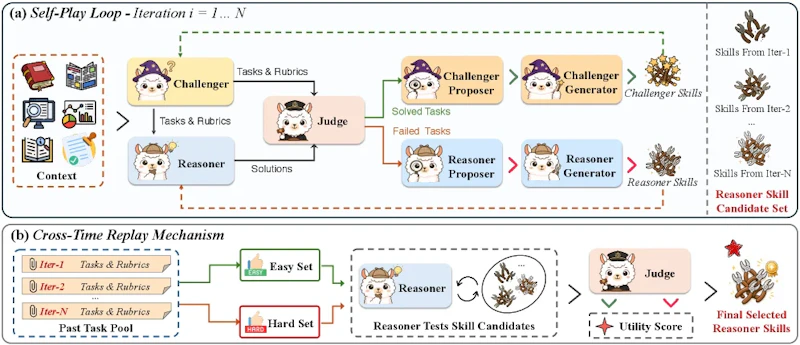
フレームワークの核心は、Challenger・Reasoner・Judgeの3エージェントが繰り返すSelf-Playループです。まずChallengerがコンテキストと自身のスキルセットをもとに検証タスクと採点基準(ルーブリック)を生成します。次にReasonerが自身のスキルセットを参照しながらそのタスクを解きます。そしてJudgeがすべての採点基準を満たしたかをバイナリ評価します。
Judgeが「失敗」と判定した場合、専門のProposer–Generatorペアが欠落した知識を診断してReasonerのスキルを更新します。「成功」と判定された場合はChallengerのスキルが更新され、次ラウンドでより難度の高いタスクを生成できるようになります。両エージェントはお互いのスキルセットを参照しないため、厳格な対抗関係が保たれます。この自律的なフィードバックループは、RLHFやDPOなどのLLMアライメント手法が強化学習的な信号でモデルを改善するアプローチを、外部報酬なしで実現したものといえます。
Cross-Time Replayの役割
自己対戦を繰り返すと、ChallengerとReasonerが互いに過剰適応する「敵対的崩壊」のリスクが生じます。ChallengerがReasonerの弱点を突く極端なタスクを生み出し、Reasonerがそのパターンにのみ特化してしまうことで、未知のタスクへの汎化性能が低下します。
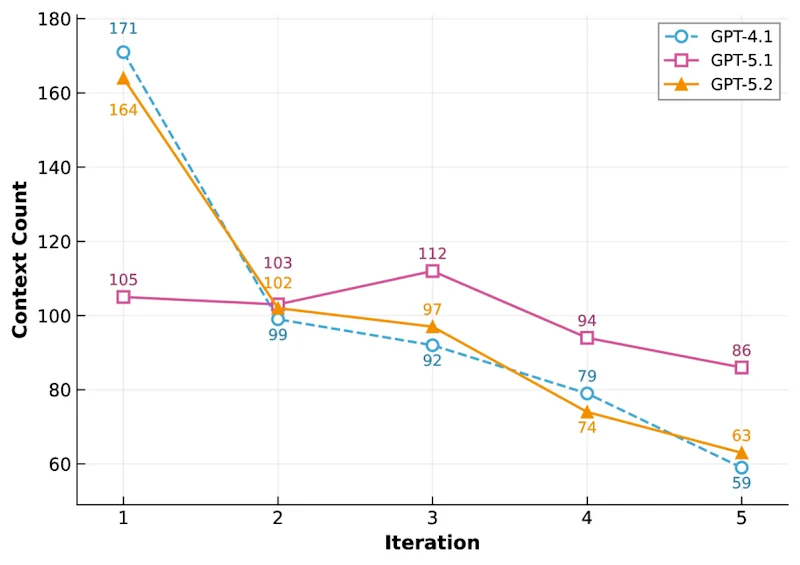
これを防ぐのがCross-Time Replayです。各イテレーションから「難問プローブセット」と「易問プローブセット」の両方を収集し、その両方に対してバランスよく機能するスキルセットを選択します。スコアの計算には両性能の乗積形式を使うため、どちらか一方に偏ったスキルセットは自動的に除外されます。図3が示すように、最終的に選ばれるスキルセットは特定のイテレーションに偏らず、多様なタイミングから選択されており、フレームワークの安定性が確認できます。
CL-benchによる評価結果
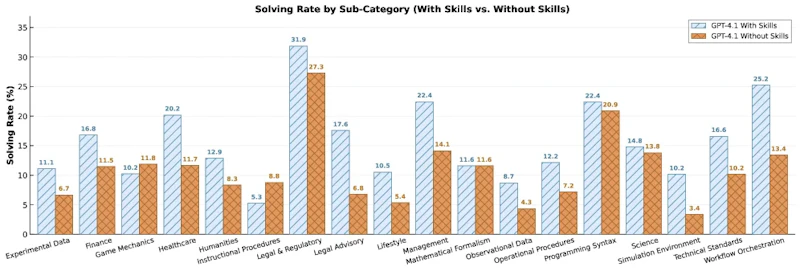
評価にはコンテキスト学習専用ベンチマーク「CL-bench」を使用し、ドメイン知識推論・手続き的タスク実行・経験的発見シミュレーションなど4つのタスクカテゴリで検証しました。GPT-4.1をバックボーンとした場合、スキルなしの解答率11.1%に対し、Ctx2Skillは16.5%(+5.4ポイント)を達成しています。
手法 | GPT-4.1での向上幅 |
|---|---|
シンプルなプロンプティング | +1.2% |
AutoSkill4Doc | +2.1% |
Ctx2Skill(提案手法) | +5.4% |
複数のバックボーンモデルで一貫した改善が確認されており、特に手続き的タスク実行ではAutoSkill4Docの+4.6%に対し+7.2%という大きな差をつけています。スキルの品質評価では、忠実性84.8%・明確性96.2%も報告されています。なお、異なるバックボーン間でスキルを転用した場合は同一バックボーン比で約2ポイントの性能低下が生じることも確認されており、スキルのモデル依存性は今後の研究課題として挙げられています。
まとめと今後の展望
Ctx2Skillは、人間のアノテーションも外部評価システムも必要とせず、LLMが複雑なコンテキストから自律的にスキルを学習できる自己進化型フレームワークです。Challenger・Reasoner・JudgeのSelf-Playループと、過学習を防ぐCross-Time Replayの組み合わせにより、既存手法を大きく上回る性能向上を実現しました。
現在の実験はイテレーション数5・タスク数5という制約下で実施されており、より大規模な設定での検証が今後の課題として残ります。実装はGitHub(S1s-Z/Ctx2Skill)で公開されており、任意のLLMへの適用も容易なため、さまざまなドメインへの展開が期待されます。
論文情報: "From Context to Skills: Can Language Models Learn from Context Skillfully?"(Shuzheng Si et al., 2026) arXiv:2604.27660
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


