 AI-Papers
- パイプライン並列化の「weight binding問題」を解消するラウンドロビン方式スケジューリングでバブル率をほぼゼロに削減
- 8×RTX 4090で1.7Bから32Bモデルのファインチューニングを最大2.16倍高速化し、単一コンシューマーサーバーでQwen3-235BのLoRAチューニングを実現
- 優先度認識転送スケジューリング・分散イベント同期プロトコル・自動レイヤー分割を統合したシステム設計でオープンソース公開済み
研究の背景
大規模言語モデル(LLM)のファインチューニングには、膨大なGPUメモリが必要です。単一のGPUに収まらないモデルを学習する際、複数のGPUにレイヤーを分割して順番に処理する「パイプライン並列化(Pipeline Parallelism)」が広く使われています。
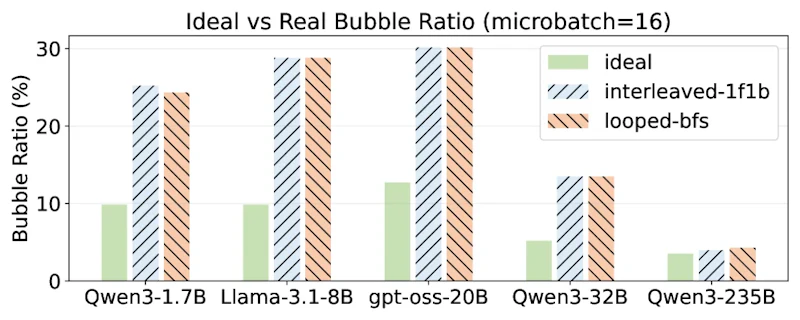
しかし、パイプライン並列化には根本的な問題があります。各マイクロバッチの処理が次のGPUに依存するため、GPU間で「待ち時間(バブル)」が生じやすく、ハードウェアの利用効率が低下するのです。とりわけコンシューマーグレードGPU(RTX 4090など)は、データセンター向けGPUと異なりNVLink等の高速インターコネクトを持たないため、バブルの影響が顕著に表れます。
既存のLooped BFS(幅優先探索)スケジュールは複数のマイクロバッチをまとめて処理することでバブルを減らしますが、「weight binding問題」という新たな障害に直面します。各GPUが特定のレイヤー(重み)に固定されるため、処理の柔軟な割り当てができず、パーティションの不均一性によるバブルを回避できません。
RoundPipeの提案手法
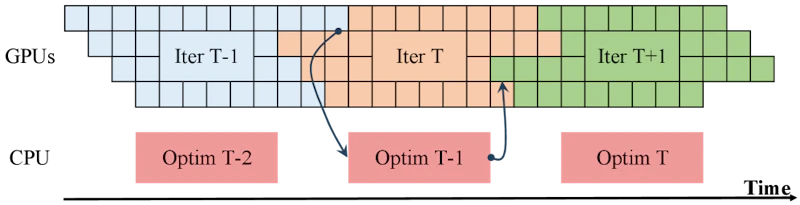
RoundPipeは、weight binding問題を根本から解決する新しい設計思想を採用しています。各GPUを「特定レイヤーに紐づいた処理ノード」ではなく、「ステートレスな実行ワーカーのプール」として扱い、ラウンドロビン方式で計算ステージを動的に割り当てます。
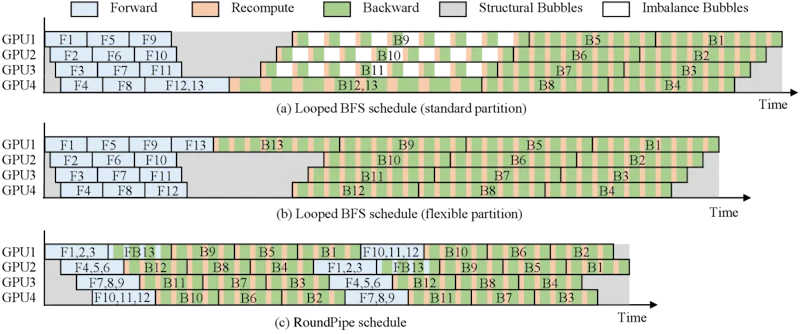
この方式により、あるGPUが処理を終えた瞬間に次の計算ステージを割り当てられるため、待ち時間がほとんど発生しません。各ラウンド内でのバブル率は従来のLoopedスケジュールと同等ですが、パーティションの不均一性に起因するバブルを排除できる点が決定的な違いです。
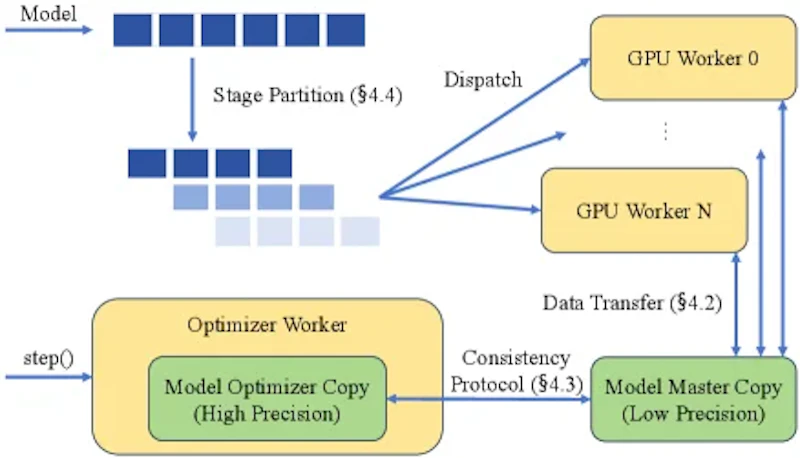
RoundPipeは、スケジューリング革新に加えて3つのシステムコンポーネントを統合しています。
- 優先度認識転送スケジューリング: GPU間の重み・勾配転送をパイプライン処理と重ね合わせ、通信コストを隠蔽する
- 分散イベント同期プロトコル: 非同期オプティマイザ更新を実現し、CPU→GPUへの重みコピー待ちをなくす
- 自動レイヤー分割アルゴリズム: モデル構造を分析し、GPU間で均等な計算負荷になるよう自動的にレイヤーを割り当てる
実験結果
RoundPipeの性能は、8枚のRTX 4090(合計192GB VRAM)を搭載したコンシューマーサーバーで評価されました。比較対象はTorchTune(メタが公開するファインチューニングライブラリ)のLooped BFSスケジュールです。
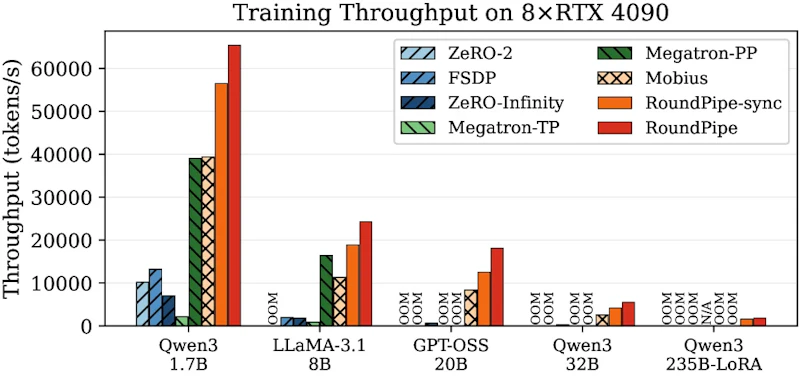
スループット面では、1.7Bから32Bのモデルサイズにわたって1.48倍から2.16倍の高速化を達成しました。バブル率の削減がそのままスループット向上に直結しており、モデルが大きくなるほど効果が顕著に表れる傾向があります。
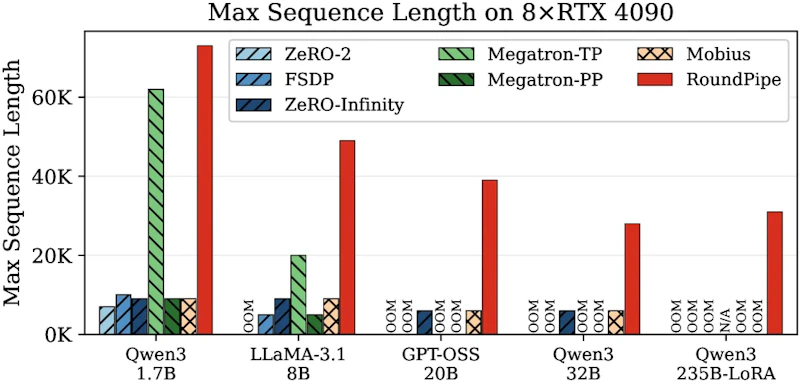
最大学習可能シーケンス長の面でも顕著な改善が見られます。特に注目すべきは、Qwen3-235Bという巨大なMixture of Experts(MoE)モデルを、31Kシーケンス長でLoRAファインチューニングできる点です。これは単一のコンシューマーサーバーで実現できる水準を大幅に超えており、一般開発者にとって実用的な大規模モデル活用の道を開きます。
データセンター向けGPUである8×A800での検証でも同様の傾向が確認されており、RoundPipeはハードウェアを選ばない汎用性の高い手法であることが示されています。LLM推論高速化の各種技術と組み合わせることで、さらなる効率化も期待できます。
まとめと今後の展望
RoundPipeは、パイプライン並列化の根本的な制約であるweight binding問題を、GPUをステートレスなワーカープールとして扱うという発想の転換で解決しました。バブルをほぼゼロに抑えつつ、転送の重ね合わせや非同期オプティマイザ更新といったシステム最適化を組み合わせることで、コンシューマーGPUでの実用性を大幅に高めています。
コードはGitHubでオープンソース公開されており、再現性も高い研究です。今後はNVLink非搭載環境特有の通信ボトルネックへの対応や、さらに多数のGPUへのスケールアウト性能の検証が課題となるでしょう。コンシューマーハードウェアで235Bクラスのモデルをファインチューニングできるという事実は、大規模モデルの研究・活用の裾野を確実に広げるものです。
論文情報: "Efficient Training on Multiple Consumer GPUs with RoundPipe"(Yibin Luo et al., 2026) arXiv:2604.27085
本記事の図(図1〜図6)は解説のため上記論文より引用しています。


