AI-Papers
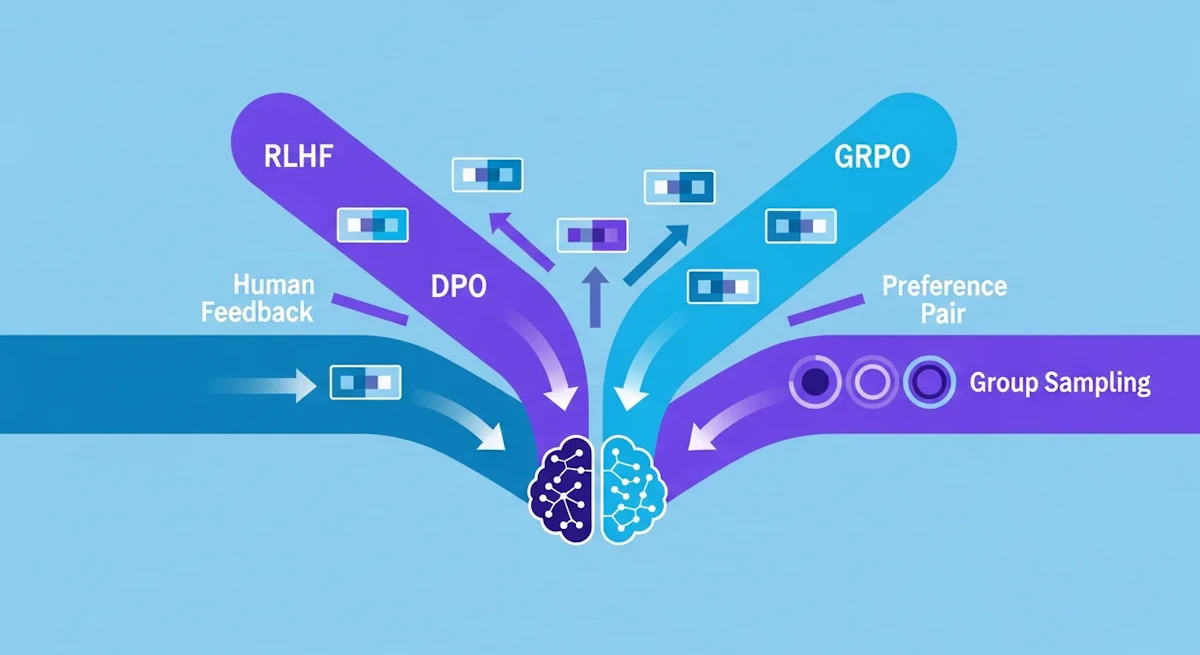
- RLHFはSFT・報酬モデル・PPOの3段階で人間の好みをAIに学習させる手法で、ChatGPT(InstructGPT)の基盤技術として確立された
- DPOは報酬モデルを不要にした効率的な最適化手法で、7Bモデルが70Bモデルを上回る実績が示すほどアライメントの質が重要
- GRPOは複数応答のグループ内比較で人間アノテーション不要の推論能力創発を実現し、DeepSeek-R1に採用されて注目を集めた
LLMアライメントとは何か
ChatGPTをはじめとする大規模言語モデル(LLM: Large Language Model)は、膨大なテキストデータから「次のトークンを予測する」ことを学習しています。しかしこの事前学習だけでは、AIは人間にとって有益・誠実・無害な応答を生成するとは限りません。差別的な表現を出力したり、もっともらしい嘘をついたりするリスクが残ります。
この課題を解決するのがLLMアライメントです。アライメントとは、AIの出力を人間の意図や価値観に一致(align)させるための技術群を指します。AI開発の世界では「HHH(Helpful・Honest・Harmless: 有益・正直・無害)」という3原則が指針として広く採用されており、アライメント技術はこの3原則を実現するための後学習(Post-training)プロセスの中核を担います。
アライメントの効果は数字でも明らかです。OpenAIが2022年に発表した研究では、13億パラメータのRLHF適用モデルが、アライメントなしの1750億パラメータのGPT-3を人間評価で上回りました。これは「アライメントボーナス」と呼ばれ、パラメータ数よりもアライメントの質がユーザー体験を左右することを示しています。
RLHFの仕組みを図解
RLHF(Reinforcement Learning from Human Feedback: 人間フィードバックからの強化学習)は、現在主流のアライメント手法の出発点です。ChatGPTの前身であるInstructGPTで採用され、LLMアライメント研究を大きく前進させました。
3段階のパイプライン
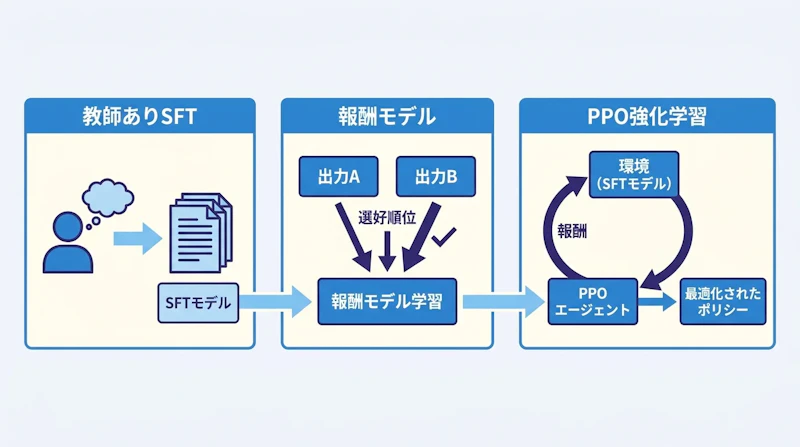
RLHFは次の3つのステップで構成されます。
- 教師ありファインチューニング(SFT): 人間が作成した高品質な指示応答ペアでモデルを微調整し、指示に従う基礎能力を獲得させる
- 報酬モデルの学習: 同じプロンプトに対して複数の応答を生成させ、人間アノテーターがランク付けする。その選好データを使って「良い応答を判定する」報酬モデルを訓練する
- PPOによる強化学習: 報酬モデルのスコアを最大化するようにPPO(Proximal Policy Optimization)アルゴリズムで本体モデルを最適化する
RLHFの課題
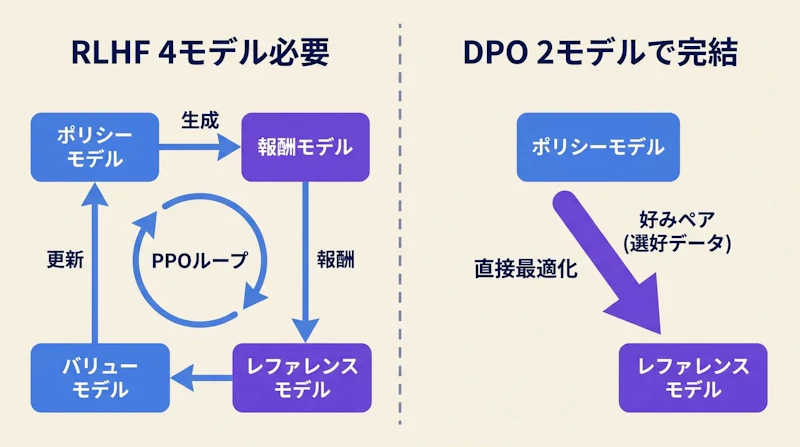
RLHFは強力な手法ですが、実装上の困難がいくつかあります。最大の課題は計算コストと複雑性です。学習時にSFTモデル・報酬モデル・参照モデル・アクターモデルの計4つのモデルを同時にメモリに読み込む必要があり、大規模モデルでは計算資源の確保が非常に困難になります。
PPOは超参数の調整が難しく、学習が不安定になりやすい問題もあります。人間アノテーターへの大量依存もコストとばらつきの原因になります。これらの課題を解消するために生まれたのがDPOです。
DPOがRLHFを革新した理由
DPO(Direct Preference Optimization: 直接選好最適化)は2023年にスタンフォード大学の研究チームが発表した手法です。論文タイトルは「Your Language Model is Secretly a Reward Model(あなたの言語モデルは密かに報酬モデルだ)」というもので、RLHFの数学的等価性を利用してパイプラインを大幅に簡略化しました。
報酬モデルを不要にする数学的な洞察
DPOの核心は「言語モデル自体が暗黙的な報酬モデルとして機能できる」という数学的証明にあります。RLHFでは別途報酬モデルを学習してからPPOで最適化する2段階の手順が必要でしたが、DPOではこれを1つの損失関数に統合します。
具体的には、「良い(chosen)」応答の生成確率を高め、「悪い(rejected)」応答の生成確率を低下させる方向に、通常の教師あり学習と同じ枠組みでモデルを直接更新します。参照モデル(SFT済みモデル)との距離を保つKLダイバージェンス制約も設けることで、過度な分布のずれを防ぎます。
DPOの実力
DPOの効果は研究でも実証されています。Hugging FaceとEleutherAIが共同開発したZephyr-7Bは、DPOで学習した70億パラメータのモデルですが、RLHFで学習した700億パラメータ規模のモデルと同等以上の性能を一部ベンチマークで達成しました。計算効率の面では、RLHFと比較してメモリ使用量を約半分に削減でき(4モデルから2モデルへ)、学習の安定性も高まります。
一方でDPOは高品質な「良い/悪い」応答ペアデータを必要とする点に変わりはありません。このデータ収集コストを大幅に削減し、さらに推論能力そのものを引き出す手法として登場したのがGRPOです。
GRPOはどう違うのか
GRPO(Group Relative Policy Optimization: グループ相対方策最適化)は、DeepSeekが2024年に提案したアルゴリズムで、DeepSeek-R1の学習に採用されて世界的な注目を集めました。RLHFやDPOと比べて最大の特徴は、人間アノテーションを排除できる点と、推論能力を自発的に引き出せる点にあります。
グループサンプリングの仕組み
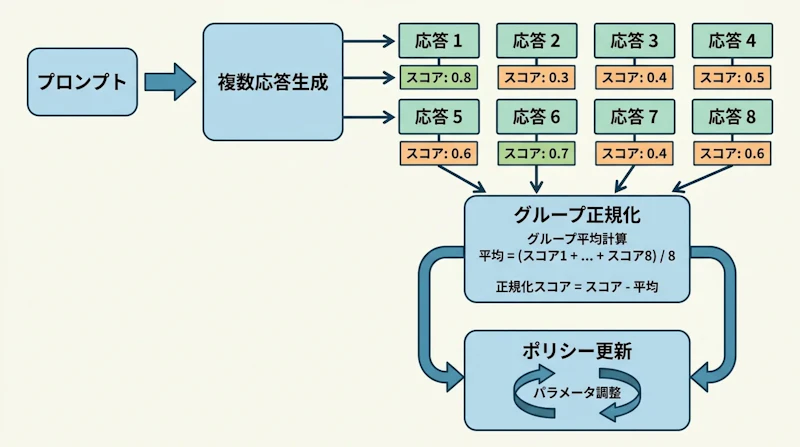
GRPOの動作原理はシンプルです。1つのプロンプトに対して、モデルが複数の応答(通常4〜16個)を生成します。次に各応答を報酬関数(数学問題の正誤判定などルールベースの評価)でスコアリングします。
評価で重要なのは、絶対的なスコアではなくグループ内の相対的な有利度を使う点です。計算式は次のようになります。
advantage = (reward - mean(group_rewards)) / std(group_rewards)これはテストの「偏差値」に似た考え方です。同グループの平均より高スコアの応答はプラスの学習シグナルを受け、低スコアの応答はマイナスのシグナルを受けます。このグループ内正規化により学習シグナルのスケールが安定し、別途Criticモデル(価値関数モデル)を持つ必要がなくなりました。
「アハ体験」の出現
DeepSeek-R1の学習実験で最も注目されたのが、「アハ体験(Aha Moment)」と呼ばれる現象の自発的な出現です。GRPOで学習させたモデルが、数学問題を解く途中で自ら誤りに気づき、「待って、再考しよう」という省察的な言語を自然に使い始めました。
この自己修正行動は明示的に教えたわけではありません。ルールベースの報酬(答えの正誤)だけで学習した結果として、内省・自己修正という高次の能力が自発的に創発したのです。純粋な強化学習がSFTなしでも推論能力を育てられることを示し、AI研究界に大きな衝撃を与えました。
ChatGPTとDeepSeek-R1の実例
ChatGPT(InstructGPT)はRLHFで誕生した
ChatGPTの基盤となるInstructGPTは、OpenAIが2022年に発表したRLHFの実証研究から生まれました。学習には人間アノテーターが作成した高品質なデモデータとランク付けデータを使用し、PPOによる強化学習の結果、13億パラメータという比較的小さなモデルでも1750億パラメータのGPT-3より有用な回答を生成できるようになりました。
この成果が「アライメントボーナス」という概念を生み出し、その後のLLM開発の標準的な手順としてRLHFが確立されました。MoE(Mixture of Experts)などのアーキテクチャ革新とともに、アライメント手法の進化がLLMの急速な性能向上を下支えしています。
DeepSeek-R1はGRPOで推論を自力で獲得した
DeepSeek-R1は2025年1月に発表され、OpenAIのo1に匹敵する推論性能を大幅に低いコストで達成したとして注目されました。学習の核心にGRPOがあり、訓練は4フェーズで構成されています。少量の高品質データでコールドスタートSFTを行い、次にGRPOを使った数学・コーディング・論理の推論強化フェーズ、その後は生成サンプルの品質管理フェーズ、最後に多様なタスクへの汎化フェーズと続きます。
最終的なDeepSeek-R1の性能は顕著です。数学ベンチマークのAIME 2024では79.8%、MATH-500では97.3%を達成し、コーディングでもCodeforces Rating 2029というトップクラスのスコアを記録しました。純粋RL学習のみのDeepSeek-R1-Zeroでも71.0%(AIME 2024)という高い成績を出した点は、アライメント手法そのものの力を改めて証明しています。
3手法の特徴を比較する
比較項目 | RLHF | DPO | GRPO |
|---|---|---|---|
学習段階数 | 3段階(SFT→報酬モデル→PPO) | 2段階(SFT→DPO) | 2段階(SFT→GRPO) |
必要モデル数 | 4モデル同時(低効率) | 2モデル(高効率) | 中程度(グループ生成) |
人間アノテーション | 大量必要 | 中程度 | ルールベースで不要も可 |
学習の安定性 | 不安定(崩壊リスクあり) | 安定 | グループサイズに依存 |
推論能力の引き出し | 間接的 | 限定的 | 自発的な創発が可能 |
主な採用モデル | ChatGPT(InstructGPT) | Zephyr、Llama-3系列 | DeepSeek-R1 |
どの手法を選ぶべきか
実際にLLMのファインチューニングやアライメントを行う場合、現時点での実務的な指針をまとめます。
高品質な選好データセット(良い/悪い応答ペア)が用意できるなら、DPOから始めるのが現実解です。比較的少ない計算資源と安定した学習プロセスで良好な結果が得られます。HuggingFace TRLなどのライブラリで簡単に実装でき、Llama-3系列など多くのオープンソースモデルで採用実績があります。
数学・コーディング・論理など正解が明確に検証できるタスクでの推論能力強化を目指す場合、GRPOが選択肢になります。人間アノテーションが不要な分コストを抑えられますが、報酬関数の設計が学習品質を大きく左右するためドメイン知識が求められます。
最高品質のアライメントを求め、計算資源と人的リソースに余裕があるならRLHFが依然として有力です。主観的な品質(文章の自然さや有用性)を多角的に評価したい場合は、人間の判断を報酬モデルに落とし込むRLHFの強みが発揮されます。3手法は競合するものではなく、DeepSeek-R1のようにSFTとGRPOを複数フェーズで組み合わせる形が今後の主流になると考えられます。