 AI-Papers
- Ai2がCMU・NVIDIA・Johns Hopkinsと共同で、誤った前提の質問を見抜く力を測る8,115問のベンチマークXYBenchを公開した
- Claude Sonnet 4.6やGPT-5など主要5モデルが本来の目的を主眼に答えた割合は、Stack Overflow由来の設問で35〜41%にとどまった
- 選択形式では目的重視の回答を71〜84%で選べており、良い助言を見分ける力と自力で書く力の差が浮かんだ
XY問題を測る新指標
Allen Institute for AI(Ai2)は、Carnegie Mellon University、NVIDIA、Johns Hopkins Universityの研究者と共同で開発したベンチマークXYBenchを公開しました。EMNLP 2026のBest Resource Paper Awardを受賞しています。
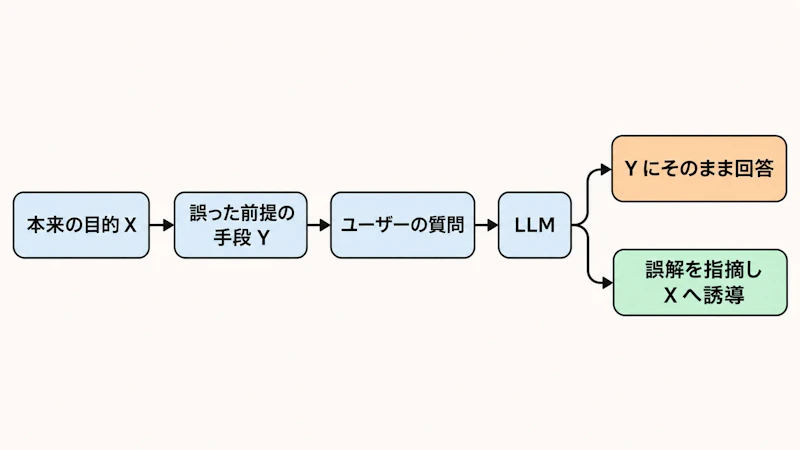
測るのは「XY問題」への対応力です。XY問題とは、本来達成したい目的Xがあるのに、誤った思い込みから手段Yに行き着き、Yのやり方だけを質問してしまう状況を指します。プログラミングの質問サイトでは典型的な失敗パターンとして知られています。
人間の回答者であれば「そもそもYは不要で、Xなら別の方法がある」と前提のずれを指摘します。一方、大規模言語モデル(Large Language Model、LLM)は聞かれたYにそのまま答えてしまい、ユーザーを遠回りさせる可能性があります。図1のように、同じ質問に対して応答が2通りに分岐する点がこのベンチマークの着眼点です。
8,115問の内訳と作り方
データセットはプログラミングに加え、料理や家の修理といった日常的な作業も対象としています。出典別の構成は次のとおりです。
- Stack Overflow由来: 1,557問
- Stack Exchange由来: 184問
- 人手で精査したもの: 102問
- WikiHowのガイドから生成: 6,272問
フォーラム由来の設問では、高評価の人間回答3件とベストアンサーを参照データとして使っています。聞かれたとおりに答えるだけで十分と判断できる事例は除外し、前提のずれが本質的な問題である設問だけを残しました。WikiHow由来の設問はClaude Sonnet 4.5でもっともらしい誤解を軸に生成し、文字どおりの回答でほぼ解決してしまう例を削っています。
評価は3つの観点
評価軸は、聞かれた要求Yと本来の目的Xそれぞれに対する解決策が含まれているか(pragmatic solution)、回答の重心がYとXのどちらにあるか(pragmatic emphasis)、誤った手段を避けるよう促してXへ導いているか(misconception identification)の3つです。
採点はClaude Sonnet 4.5による自動判定で行い、2名の人間が500件の応答を確認しました。判定の一致率は、解決策の有無で97.5〜100%、誤解の指摘で84.6〜93.3%、回答の重心で74.2〜79.8%でした。重心の判定は人間同士でも揺れやすい項目だといえます。
主要5モデルの結果
評価対象はClaude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B、DeepSeek-V4 Proの5モデルで、1問1応答のシングルターン設定です。Stack Overflow由来の設問での結果は次のようになりました。
項目 | 5モデルの範囲 |
|---|---|
聞かれた要求Yの解決策を含む | 75〜86% |
本来の目的Xの解決策を含む | 59〜71% |
回答の重心がXにある | 35〜41% |
回答の重心がYにある | 47〜57% |
Xへの解決策自体は6割前後の応答に現れるものの、回答全体の主眼がXに向くのは4割弱です。残りはXとYを同程度に扱っています。誤解の指摘については、すべてのモデルが人間の回答を下回りました。
YとXの両方をあらかじめ与えるオラクル実験では、Claude Sonnet 4.6のX解決率は59%から67%へ上がった一方、誤解の指摘率は47%から34%へ下がりました。目的を教えられると、前提の誤りを指摘する動機がかえって薄れるという結果です。
選択形式では71〜84%
上記5モデルにGPT-4.1を加えた6モデルに、目的重視の回答を選ばせる選択形式の課題を与えると、正答率は71〜84%に達しました。自由記述では35〜41%だった数字との差は大きく、研究チームはこれを「有益な助言を見分ける能力と、それを自ら産出する能力のギャップ」と表現しています。
知識として持っていても出力に反映されないという構図は、モデルの能力を多面的に評価する必要性を示します。単一のスコアでは見えない挙動を切り分ける観点は、SO-Arenaとは?System Oneモデル21種の能力と信頼性を横断評価で扱った横断評価の発想とも重なります。
実装者への示唆
AIアシスタントやエージェントを組み込む側にとって、この結果は設計上の論点になります。ユーザーの要求をそのまま実行するエージェントは、前提が誤っていた場合に誤った作業を完遂してしまうためです。前提の確認を促すプロンプトや、目的を聞き返す対話設計の効果を測る物差しとして、XYBenchは使えます。
現状のカバー範囲は英語で、主に手順のある問題に限られます。研究チームは他言語や他文化、複数ターンの対話への拡張を今後の課題に挙げています。データセットはHugging Face、コードはGitHubで公開されており、論文はarXivで読めます。


