 AI-Papers
- 長い推論を出さず即座に構造化判断を返す「System One」モデルを、11ドメイン2,919タスクで横断評価するベンチマーク「SO-Arena」が公開されました
- 正答率による能力評価とは別に、選択肢の並べ替え耐性と「正解が存在しない」ことの認識という2つの信頼性指標を独立に測定しています
- 能力首位のSystem Oneモデルは信頼性で7位、能力11位のJevAny-27Bが信頼性首位となり、精度の高さが判断の安定性を保証しないことが示されました
研究の背景
近年の大規模言語モデル(Large Language Model、LLM)は、長い思考過程を出力してから答えを出す方式で精度を伸ばしてきました。しかし実運用では、問い合わせの振り分け、安全性の判定、検索結果の並べ替え、ツール呼び出しの可否といった「短い判断」が大量に発生します。こうした処理に数千トークンの推論を挟むと、応答時間とコストが現実的でなくなります。
そこで注目されているのが、1回のフォワードパス(入力を一度通すだけの処理)で構造化された判断を返すモデル群です。論文はこれを人間の直感的思考にちなんでSystem One モデルと呼び、熟考型の推論モデルをSystem Twoと位置づけています。実際にGoogleがGemini Decisions APIを公開したように、判断専用のAPIは製品として整い始めています。
一方で、この種のモデルをどう選ぶべきかという評価の枠組みは未整備でした。既存のベンチマークは正答率の平均値を報告するだけで、どの領域が得意なのか、入力の提示方法が変わっても判断がぶれないのか、という運用上の疑問に答えられません。SO-Arenaはその空白を埋めるために設計されています。
ベンチマークの構成
SO-Arenaは11ドメイン、合計2,919タスクで構成されます。感情理解、意図分類とルーティング、数学、コード理解、科学的推論、知識と常識、安全性、検索と再ランキング、タスク完了の検証、ツールとAPIの利用、テキストベースのWeb操作という内訳で、これらを意味理解、知識と推論、安全性とポリシー遵守、証拠の評価、エージェントのタスク遂行という5つの能力ファミリーにまとめています。
2,919タスクのうち2,300件は静的な問題、619件はサンドボックス環境で実際に操作させる対話型タスクです。参照ラベルは信頼できる情報源から作られ、人手で検証されています。ドメインごとに難易度基準を定めているため、単純な平均点ではなく、どの難易度帯で崩れるかを追えるようになっています。
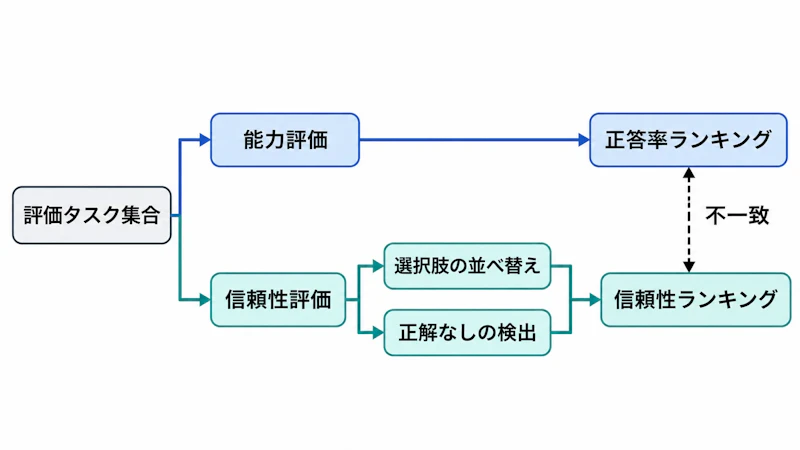
図1に示すように、SO-Arenaの特徴は能力と信頼性を切り離して測る点にあります。信頼性のうち並べ替え耐性は、同じ問題を元の順序に加えて12通りの並べ替えで出題し、判断が変わらないかを見る指標です。もう一方は「正解の選択肢が削除された597件」を使い、正解がないことに気づけるかを識別能力の指標として数値化しています。
実験結果
評価対象は21モデルです。0.4BのLayaから31BのKnowLine-31BやSieve-31B-v3までの公開モデル16種、思考するかどうかを自分で決めるハイブリッド型のStartLux Auto、商用APIのJev API 1.14とOpenAI Decisions、そして比較用のSystem TwoとしてGPT-6 SolとGPT-6 Lunaが含まれます。
モデル | 種別 | 総合スコア |
|---|---|---|
GPT-6 Sol | System Two | 82.3 |
GPT-6 Luna | System Two | 79.7 |
GLiDE(27B) | System One | 70.2 |
KnowLine-31B | System One | 70.2 |
JevAny-27B | System One | 58.4(21モデル中11位) |
System Oneの首位はGLiDEとKnowLine-31Bが並ぶ70.2で、GPT-6 Lunaとの差は約10ポイントです。ただしこの差はドメインによって大きく異なります。知識と常識、感情理解、検索ではSystem OneがSystem Twoとほぼ並び、意図分類、安全性、タスク検証、ツール利用、Web操作という根拠が明示された5領域ではGLiDEがLunaの4ポイント以内に収まりました。
逆に数学、科学、コードでは差が開きます。思考の効果が最も大きいのは数学で、StartLux Autoは思考なしの50.8から思考ありで92.5まで上昇しました。判断の種類によって熟考が要るか要らないかがはっきり分かれる、という実務的な示唆が読み取れます。
速度面では、公開されているSystem Oneモデルはいずれも1台のH100で1タスクあたり0.3秒未満で応答し、GPT-6 SolやLunaより数十倍高速でした。ただしこれは1件ずつ逐次実行した計測であり、商用APIはネットワーク越しの計測なので、同じ条件の比較ではありません。
能力と信頼性の乖離
信頼性の評価はSystem One系18モデルを対象に行われました。並べ替え耐性は18モデル中14モデルが0.8を超え、おおむね0.83から0.94の範囲に収まっています。一方でLayaは0.35、OpenAI Decisionsも0.68から0.72の水準にとどまり、選択肢の順序で判断が変わるモデルが一定数存在することが確認されました。
正解なしの検出能力はさらにばらつきが大きく、ほぼ偶然と変わらない水準から0.8程度まで分布します。この指標はモデルサイズと相関せず、一部の4Bモデルが9Bや27Bのモデルを上回りました。Kev-27B、Jev API 1.14、JevAny-27Bの3モデルは、能力上位4モデルをいずれも上回っています。
結果として、能力首位のSystem Oneモデルは信頼性では7位にとどまり、能力11位のJevAny-27Bが信頼性で最も高い評価を得ました。総合点の高いモデルを選んでも、判断の安定性まで最良になるとは限らないという結論です。選定時に確認すべき項目は次のように整理できます。
- 自社の用途に対応するドメインでのスコア(総合平均ではなく領域別)
- 選択肢やプロンプトの提示順を変えても判断が変わらないか
- 想定外の入力に対して「該当なし」を返せるか
- 実際のバッチ条件での応答時間とコスト
ここから分かるのは、単一のリーダーボード順位でAPIを選ぶ運用はリスクを抱えるということです。特に安全性判定やルーティングのように誤判断が下流に波及する用途では、信頼性側の指標を別に確認する価値があります。
まとめと今後の展望
SO-Arenaは、短い判断を返すモデル群に対して能力の広がりと判断の安定性を分けて測る評価軸を提示しました。推論モデルの精度競争とは別の軸で、実運用に近い選定材料を与える試みと言えます。
ただし限界もあります。難易度の区分は各ドメイン内での相対評価であり、ドメイン間で較正されていません。信頼性指標は一貫性を測るもので正しさそのものを測るわけではないため、順序に対して安定だが常に誤るモデルも高いスコアを得てしまいます。参照ラベルの一部はモデル由来でメタデータに注記されており、この部分の品質は人手検証に依存します。
とはいえ、判断専用APIが製品として広がる局面で、評価の語彙を能力と信頼性の2軸に整理した点は実務的な意味を持ちます。今後はドメイン横断の難易度較正や、正しさと一貫性を同時に評価する指標の設計が課題になるはずです。
論文情報: "SO-Arena: Benchmarking the Capability Spectrum and Reliability of System One Models"(Lichen Li et al., 2026) arXiv:2611.15777, CC BY 4.0


