 AI-Papers
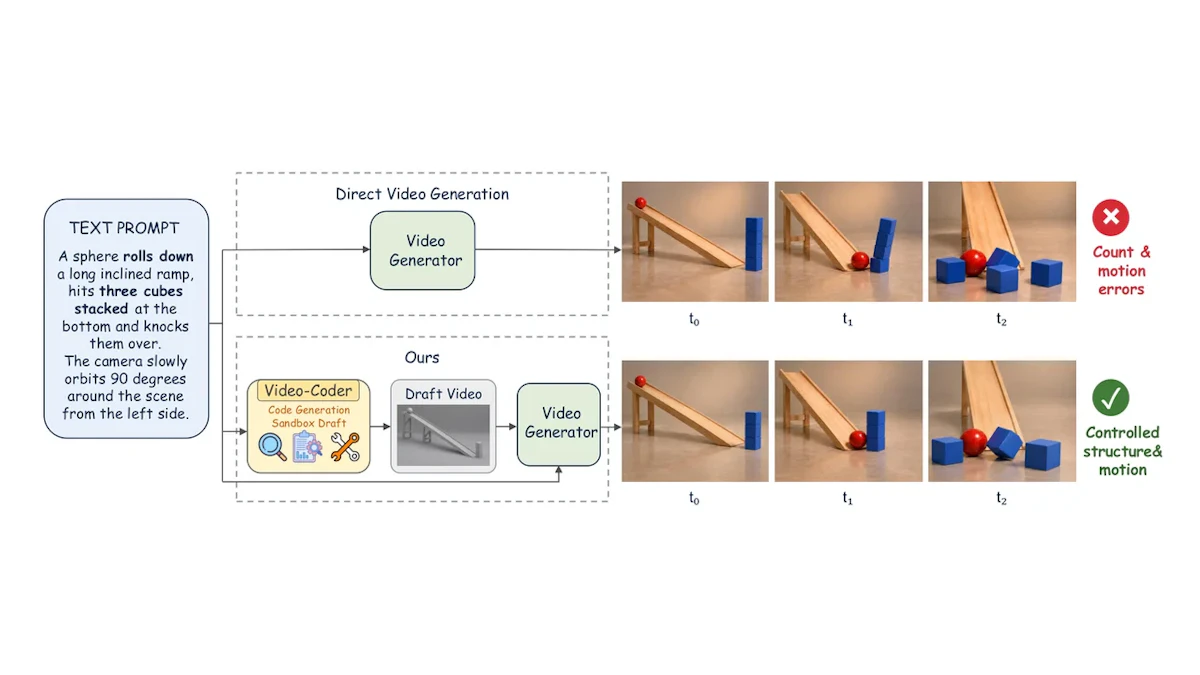
- Video-Coder はエージェントが Blender の Python コードを書いて 3D シーンを組み立て、下書き動画(Draft Video)として動画生成モデルに構造と運動の情報を渡す手法です
- コードが正しく実行できたかを見る実行報酬と、生成動画の内容を見る動画報酬を組み合わせ、実行報酬を学習の進行とともに減衰させる強化学習を採用しています
- MiniMax-H3 単体と比べて PhyGenBench が 0.61 から 0.67、VBench-2.0 の平均が 54.58% から 78.19% へ改善しました
研究の背景
テキストから動画を生成するモデルは見た目の品質を大きく伸ばしてきましたが、物体がぶつかったあとの動き方や、熱や光の振る舞いといった物理的な整合性はいまも弱点として残っています。プロンプトに「ボールが坂を転がり落ちる」と書いても、転がる向きや速さが途中で破綻することは珍しくありません。
原因のひとつは、生成モデルが映像のピクセルを直接作る際に、シーンの三次元的な構造や時間を通した運動を明示的に持っていないことです。そこで本研究は、動画を直接描かせる前にプログラムとして 3D シーンを記述させるという回り道を取りました。
arXiv に公開された「Video-Coder: Reinforcing Agentic Coding for Video Generation」(arXiv:2611.09894)は、コード駆動の動画生成エージェントを学習させた最初の試みだと位置づけられています。
Draft Videoという中間表現
Video-Coder の中心にあるのは Draft Video と呼ばれる中間表現です。エージェントはプロンプトを読んだあと、Blender(3D 制作ソフト)向けの Python スクリプトを書いて物体やカメラ、動きを配置し、それをレンダリングして質感のない灰色のモデルだけの短い映像を作ります。この下書きが構造と運動の指示として後段の動画生成モデルに渡され、最終的な映像が出力されます。
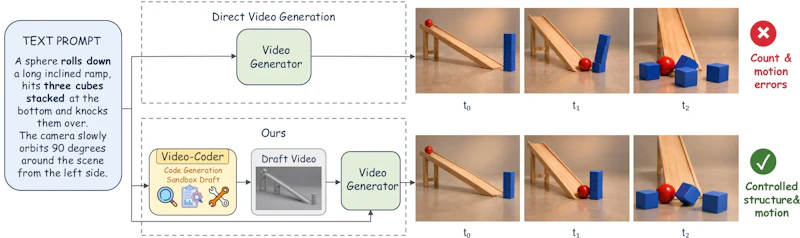
図1のように、従来の直接生成ではプロンプトから一気に動画へ飛びますが、Video-Coder はコード実行とレンダリングを挟むことで、どこに何があってどう動くかを明示的に決めてから映像化します。物理法則にかかわる部分を 3D シーンの側で担保する設計です。
学習と推論の土台になるのが Video-Coder Harness です。各エピソードは Blender が入った隔離サンドボックスで動き、エージェントは静的チェック用の check_script とレンダリング実行用の run_blender を呼びながらスクリプトを直していきます。返ってくるフィードバックは次の3種類です。
- 実行エラーやトレースバック
- 内容チェック(空フレーム、静止したまま、物体が画面外に出るなど)
- 等間隔に抜き出した数フレームの画像による視覚的な確認
提出時には最終スクリプトをクリーンなディレクトリで再実行し、もう一度通った場合にだけエピソードを有効とします。強化学習時の上限は 100 ターン、文脈長は最大 120K トークンです。
学習データの構築
データは4段階のパイプラインで作られます。プロンプトの構築、エージェントの試行軌跡の生成、正解となる参照動画の合成、そして洗浄とフィルタリングという流れです。
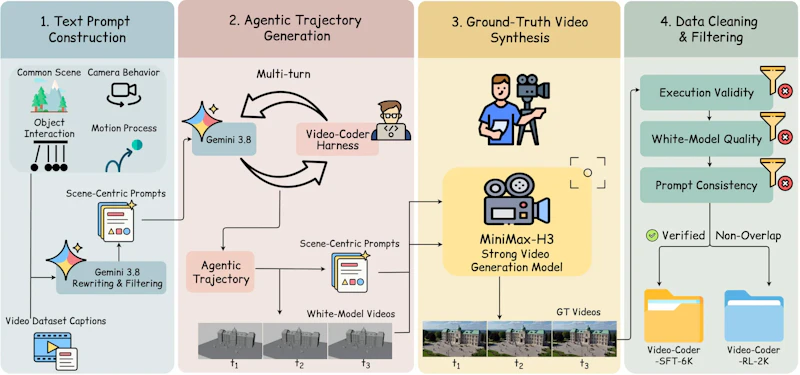
図2の工程を経て、教師ありファインチューニング(SFT)用と強化学習用の2つのデータセットが用意されます。公開されている名称は Video-Coder-SFT-6k と Video-Coder-RL-2k で、Abstract とデータ構築の節(3.1節)もこの 6k と 2k の規模で記述されています。一方で実験設定の節(4.1節)と結論では 10k と 4k という数字が使われており、論文内で表記が揺れています。データセット名として公開されているのは 6k と 2k のため、本記事ではこちらを採用します。
二重報酬とアニーリング
SFT のあとに、ハーネス上でそのまま強化学習を行います。報酬は2本立てで、ひとつはコードの実行報酬です。ツール呼び出しの形式が正しく、最終的な Blender プログラムが走ってチェックをすべて通れば 1、そうでなければ 0 という二値で与えられます。
もうひとつは動画報酬で、生成された動画がプロンプトと参照動画にどれだけ合っているかを、物体のカテゴリ、空間配置、動き、カメラの観点から評価して 0 から 1 に正規化します。最終報酬はこの2つの加重和ですが、実行報酬側に学習ステップ数に応じた指数的な減衰係数を掛けるのが特徴です。
初期はコードを動かせるようになること自体に報酬を与え、学習が進むにつれて実行報酬の寄与をほぼゼロまで下げ、動画の良さに重心を移すという設計です。最適化は GRPO(グループ単位で相対的に優劣を比較する強化学習手法)をグループサイズ 8 で用います。ベースモデルは Qwen3.5-9B で、学習は H100 8 枚に加えてロールアウト用の動画生成に 16 枚を使い、約3日かかったと報告されています。動画分野でのエージェント型強化学習の工夫としては、TurnWiseとは?ターン単位のクレジット割り当てでストリーミング動画RLを改善も参考になります。
実験結果
物理整合性を測る PhyGenBench と VBench-2.0 で評価されました。Video-Coder-9B が下書きを作り、後段の生成に MiniMax-H3 を使った構成が最も良い結果です。
手法 | PhyGenBench 平均 | VBench-2.0 平均 |
|---|---|---|
Video-Coder-9B + MiniMax-H3 | 0.67 | 78.19% |
MiniMax-H3 | 0.61 | 54.58% |
CogVideoX-1.5 | 0.45 | 77.04% |
HunyuanVideo | 0.33 | 65.66% |
Kling 1.6 | 0.49 | 64.34% |
同じ後段モデルを使う MiniMax-H3 単体との比較で、VBench-2.0 の平均は 54.58% から 78.19% へ約 24 ポイント上がりました。PhyGenBench は 0.61 から 0.67 で、論文は約 7 ポイントの改善と記述していますが、表の数値どおりに引き算すると 6 ポイント分です。
報酬設計のアブレーションでは、重みを固定した場合が 0.67 に対して 0.65、どちらかの報酬を外すと 0.63 から 0.64 まで落ちました。アニーリングと二重報酬の両方が効いていることを示す一方、差分自体は小さめです。
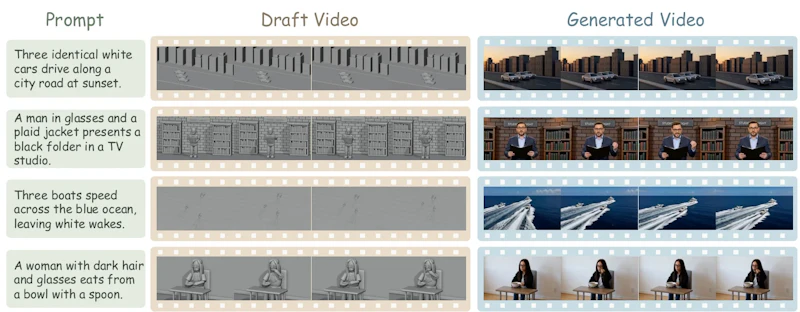
図3では、灰色のモデルだけで構成された下書きの各フレームと、それを条件にした最終出力が並べて示されています。構造と動きは下書きに従いつつ、質感や背景は後段のモデルが補っているという関係が読み取れます。
まとめと課題
Video-Coder は、物理整合性という扱いにくい性質を「コードで書ける 3D シーン」に押し出し、実行可能性と映像品質の両方を報酬にして学習させた手法です。コード、モデル、データセット、ハーネスが公開されているため、追試や改良の土台にしやすい点も実務的な価値があります。
ただし課題も残ります。素材感を問う VBench-2.0 の Material 項目は 75.02% で、CogVideoX-1.5 の 83.19% に届きません。下書きが質感を持たない灰色モデルであり、構造と運動しか伝えていないことが理由として挙げられています。
また、軌跡生成やデータ洗浄、動画報酬の採点に外部の商用モデルを複数使う構成になっており、完全に自己完結した再現は容易ではありません。データセット規模の表記揺れのように、論文内で整理しきれていない記述もあります。中間表現をコードとして持つという方向自体は、制御可能な動画生成の選択肢を増やすものといえます。
論文情報: "Video-Coder: Reinforcing Agentic Coding for Video Generation"(Chaoyang Wang et al., 2026) arXiv:2611.09894, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


