 AI-Papers
- 感圧式・磁気式・視触覚型という原理の異なる触覚センサーを、1つの表現空間にまとめる触覚基盤モデルLingBot-Touchが公開されました
- 約4,983時間・13億フレームの触覚データで事前学習し、出力したトークンはDiffusion Policyやπ0.5などの既存方策にそのまま差し込めます
- 実機26タスクの平均成功率はπ0.5で48.06%から69.87%へ、LingBot-VLAで48.3%から73.1%へ改善しました
研究の背景
ロボットの器用な操作には、視覚だけでは得られない情報が必要になります。指先が物体のどこに、どのくらいの強さで触れているか、滑り始めていないか。こうした情報を取るのが触覚センサーですが、実用化を阻んできたのはセンサーの規格が統一されていないことでした。
触覚センサーには、圧力で抵抗値が変わる感圧式(piezoresistive)、磁石の変位を読む磁気式(magnetic)、ゲル越しにカメラで変形を撮る視触覚型(visuotactile)などがあります。測定原理も、センサー点(taxel)の数も配置もばらばらで、あるハードウェアで集めたデータを別のハードウェアに流用できません。結果として、触覚データは視覚や言語のように大規模に積み上がらず、モデルもセンサーごとに作り直す状況が続いてきました。
Robbyantらが発表した「Learning Heterogeneous Tactile Representation for General Dexterous Manipulation」は、この分断を埋めることを狙った研究です。触覚の理解をセンサー固有の物理特性から切り離すという設計方針のもと、異種センサーのデータを横断して学習できる基盤モデルLingBot-Touchを提案しています。
統一表現の作り方
鍵になるのは、センサーの配列インデックスではなく幾何的な位置でデータを表す点です。各taxelを指のローカル座標系に置き直し、1つのトークンを「時刻、どの指か、指上の3次元位置」の組として定義します。この共通の座標づけを著者らはcanonical geometric interfaceと呼んでいます。
その前段に、センサー種別ごとのトークナイザを置きます。感圧式なら61点や16点、磁気式なら96点から24点、視触覚型なら200点や32点といった異なる点数の入力を、それぞれのトークナイザが共通形式に変換し、後段の共有Transformer(Haptic Transformer)が受け取ります。位置と時間の扱いには5次元のRoPEを使います。
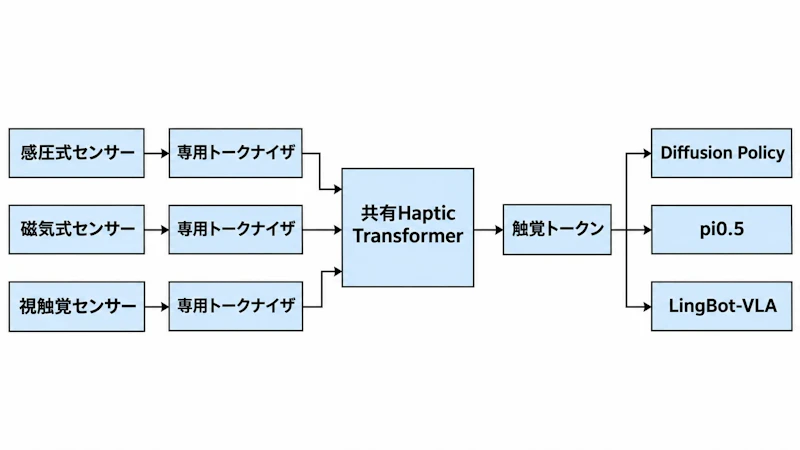
図1のように、入口で種別ごとの違いを吸収し、出口では共通の触覚トークンを出す構造になっています。このトークンは[B, N, C]の潜在表現に加えて、各トークンの時刻・指・3次元座標が添えられた形で取り出せます。公開リポジトリでは、学習可能なクエリを使ったAttentionベースの読み出しが推奨されており、単純な平均プーリングやトークン単位の線形射影は勧められていません。トークンが自己注意を通じてtaxel間・時刻間の情報をすでに混ぜているため、特定のトークンを選ぶだけでは個別の指や時間区間を切り出せないからです。
Tactile-JEPAによる事前学習
学習方式にはJEPA(Joint Embedding Predictive Architecture)を触覚向けに適用したTactile-JEPAを採用しています。入力の一部を隠したコンテキストエンコーダと、全体を見るターゲットエンコーダを用意し、予測器が隠された位置の潜在特徴を当てにいきます。ターゲットエンコーダはコンテキスト側の指数移動平均(EMA)で更新されます。
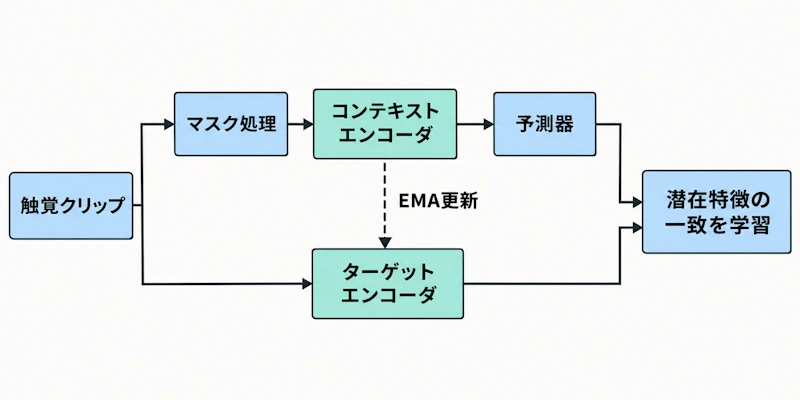
図2に示すとおり、生のセンサー値そのものではなく学習された特徴を予測対象にします。生値の復元を目標にすると、センサーごとのノイズや物理特性まで覚え込んでしまうためです。マスクは時間方向にtaxel単位でかけ、マスク率は最初の300ステップで40%から80%へ段階的に引き上げます。初手から強くマスクすると学習が不安定になったと報告されています。
事前学習コーパスは464,431エピソード、約13億フレーム、合計4,983時間です。内訳は次のとおりで、人が装着する触覚グローブと遠隔操作のロボットハンドの両方から集めています。
- 感圧式: 2,197時間 / 86,906エピソード
- 磁気式: 1,136時間 / 294,871エピソード
- 視触覚型: 1,650時間 / 82,654エピソード
ラベルはエピソード単位のものだけで、力の大きさや接触位置、接触タイミングの注釈は付いていません。アノテーションコストを抑えたまま量を稼ぐ設計だと言えます。Ai2のToyBlocksのような視覚中心のロボット学習データセットとは別の軸で、触覚側のスケーリングを狙った取り組みです。
実験結果
実機評価はSharpa Waveで20タスク、XHand1で6タスクの計26タスク、各20試行で行われました。麻雀牌の仕分け、SDカードの取り出し、キャップのひねり開け、鍵の解錠といった、視覚だけでは状態が読みにくい作業が並びます。4,000時間で事前学習したTinyモデル(5.46Mパラメータ)を凍結し、学習可能な読み出し層を介して方策に接続しています。
方策 | 触覚なし | 生の触覚を付加 | LingBot-Touch特徴 |
|---|---|---|---|
LingBot-VLA | 48.3% | 56.5% | 73.1% |
π0.5 | 48.06% | 54.69% | 69.87% |
生のセンサー値をそのまま入力に足すだけでも成功率は上がりますが、学習済み表現を通した場合の伸びはその倍近くあります。104組のタスクと方策の組み合わせのうち、LingBot-Touch版が生触覚版を上回ったのは95組、下回ったのは9組でした。Diffusion PolicyとT-Rexを含む4つの方策系統すべてで最良となっています。パラメータ増加はLingBot-VLA比で0.13%にとどまる一方、実行時の速度や総計算量は報告されていません。
事前学習に含まれていない磁気式センサーXHand1での凍結プローブ評価も示されています。指先の力推定の平均絶対誤差は1.32N(比較対象のFTP-1は3.72N)、接触中心の推定誤差は0.16mm(同5.89mm)、触覚から映像を引き当てるRecall@5は47.1%(同6.0%)でした。ただしFTP-1側はセンサー固有のアダプタをプローブと同時に学習しており、条件が対称ではない点は著者らも断っています。
データの組み合わせ方についても分析があります。あるセンサーの時間数を固定したまま他センサーのデータを足すと、8つのセンサーとタスクの組のうち7つで性能が改善しました。一方、合計1,000時間という固定予算では、単一センサーだけで学習したモデルが自分のセンサー上では8組中7組で勝っており、特に空間的な精度で差が出ています。混ぜれば常に得をするわけではなく、総量が十分にあってこそ効く関係だと読めます。
課題とまとめ
残された制約も明示されています。事前学習コーパスには静電容量式センサーが含まれておらず、実機検証は2種類のハンドにとどまります。また、幾何表現と学習データが指先に偏っており、手のひらや指の側面など指先以外の接触は十分に扱えていません。実験で使われた方策側との組み合わせも、結局は同じ研究グループのプラットフォームが中心です。
とはいえ、センサーの物理特性と触覚の意味理解を分離するという方針が、異種データの合算と未知センサーへの転移の両方で効くことを定量的に示した点には実用的な価値があります。コードはApache License 2.0で公開され、重みはHugging FaceとModelScopeで配布されています(アクセスには権限申請が必要)。視覚と言語が中心だったマルチモーダル基盤モデルに触覚を接続する足がかりとして、追試の進展が期待される研究です。
論文情報: "Learning Heterogeneous Tactile Representation for General Dexterous Manipulation"(Bing Han et al., 2026) arXiv:2611.12806, CC BY 4.0


