 AI-Papers
- ストリーミング動画モデルの「今答えるか、観察を続けるか」という各判断に、個別の学習信号を与えるGRPO拡張手法TurnWiseが提案されました
- 沈黙補完プレフィックススコアリングで各ターンの残余リターンを求め、criticや追加ロールアウトなしにターン単位のアドバンテージを算出します
- Qwen2.5-VL-3BでProactiveVQAのPAUCが43.56(+3.96)、冗長な繰り返し応答は61.5%削減されました
研究の背景
ストリーミング動画理解では、モデルが動画を見続けながら「いま応答するか、黙って観察を続けるか」を何度も決めなければなりません。オフラインの動画質問応答と違い、応答のタイミング自体が性能の一部になるタスクです。
近年はGRPO(Group Relative Policy Optimization、複数のロールアウトを互いに比較して方針を更新する強化学習手法)をこの設定に持ち込む研究が増えてきました。ただし既存手法の工夫はほとんど報酬設計に向いており、アドバンテージ(その行動が平均よりどれだけ良かったかを表す値)は軌跡全体で1つの値を共有したままです。
著者らはここに構造的な欠陥があると指摘します。会話の前半でうまく答えて高い報酬を得た軌跡では、後半の冗長な言い直しまで正のクレジットを受け取ってしまいます。逆に前半で失敗した軌跡では、後から出した有益な補足応答が負のクレジットで罰せられます。
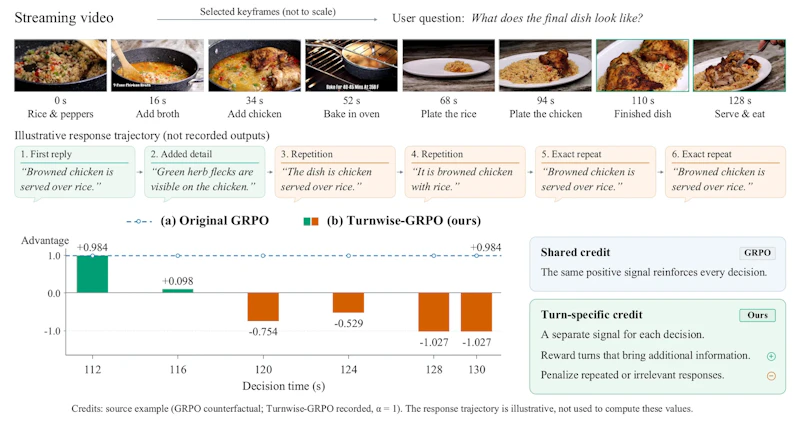
図1は、この問題を実際の学習ログから可視化したものです。GRPOでは全ターンに同じ値が配られる一方、TurnWiseは各判断の時点で既に獲得した報酬を差し引くため、後半のターンには残っているリターンに応じたクレジットが割り当てられます。
提案手法
TurnWiseの中核は2つの要素から成り立っています。1つめが沈黙補完プレフィックススコアリングです。ある軌跡について、先頭からt個の行動だけを残し、それ以降の行動をすべて「沈黙(応答しない)」に置き換えた上で報酬を再計算します。
これにより「そのターンに至るまでに既に稼いだ報酬」を推定でき、最終報酬からそれを引いた値が各判断の残余リターンになります。価値関数を学習するcriticも、追加のロールアウト生成も必要としない点が実装上の利点です。得られた値はグループ内で正規化し、±5でクリップして使います。差し引く割合を決める係数αは、学習の最初の10%で0から1へ線形に上げていきます。
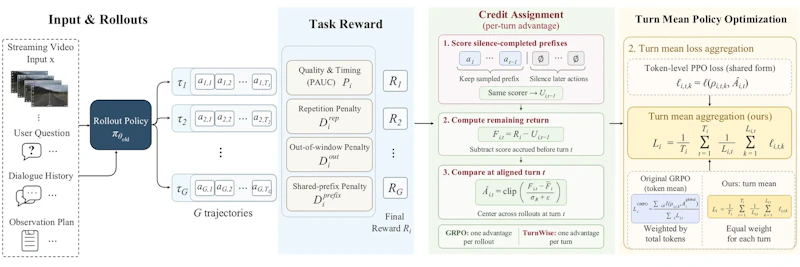
2つめがターン平均の方針最適化です。通常のトークン平均では、長い応答のターンが損失の大半を占め、トークン数がわずかな「待機」の判断はほとんど学習されません。TurnWiseはトークン損失をまずターン内で平均し、その後ターン間で平均することで、応答と待機のどちらにも出力長によらず等しい重みを与えます。図2のように、報酬の変換と損失の集約という2段階でストリーミング特有の判断構造に合わせているわけです。
学習にはQwen2.5-VL-3BとQwen3-VL-4Bを使い、それぞれ100,874件の教師ありデータでSFTした後、3,983件のストリーミング事例で強化学習を行っています。報酬はMMDuet2のPAUCベースの定式化に従い、判定にはgpt-oss-20bを用いました。
実験結果
評価はProactiveVQA(PAUC)、OVO-Timing(Timing F1)、StreamingBench(リアルタイム精度と先読み精度)の3つで行われました。比較対象はSFT、MMDuet2、ThinkStream、StreamProで、いずれも同一のストリーミングGRPO基盤上で再実装されています。
ベースモデル | ProactiveVQA PAUC | OVO-Timing F1 | StreamingBench 平均 |
|---|---|---|---|
Qwen2.5-VL-3B | 43.56(+3.96) | 21.59(+3.87) | 49.43(+0.69) |
Qwen3-VL-4B | 42.44(+6.26) | 11.15(+1.92) | 58.96(+2.38) |
括弧内はTurnWise以外で最も強い手法との差です。2つのバックボーンのいずれでも3ベンチマークすべてで最良の総合スコアを示しました。ただしStreamingBenchの伸びは3Bで0.69ポイントにとどまり、改善幅はベンチマークによってかなり差があります。
切り分け実験では、クレジット割り当てのみを使った場合はPAUC 43.12に対し繰り返し率が15.53でした。ターン平均を加えたフル構成では繰り返し率が5.98まで下がり、クレジットのみに比べて61.5%の削減になります。2つの要素が別の役割を担っていることが分かります。
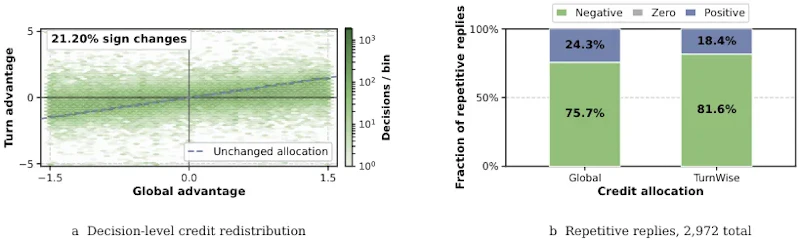
図4は、クレジットの付け替えが実際に何を直しているかを示しています。軌跡全体では正のアドバンテージを受けていた繰り返し応答722件のうち59.83%(432件)が、ターン単位の割り当てでは負のアドバンテージに変わりました。つまり「前半の成功に便乗していた冗長な応答」が、意図したとおり抑制されていることになります。
一方で評価は2つのバックボーンと3ベンチマークに限られ、ProactiveVQAの評価セットは300事例です。αの掃引は3Bモデルのみで行われ、複数シードでの分散も報告されていません。ストリーミング動画をめぐるWave Forcingのような生成側の研究と同様、評価設定の標準化はまだ発展途上の領域だと言えます。
まとめと今後の展望
TurnWiseは、報酬設計ではなくクレジット割り当ての側からストリーミング動画強化学習の問題に切り込んだ手法です。沈黙で補完した軌跡を再採点するという発想で、追加の学習モジュールを持たずにターン単位の信号を作り出しました。
コードはGitHub(XD111ds/turn-wise-rl)、学習済みモデルと訓練データはHugging Faceで公開されており、追試の障壁は低く抑えられています。マルチターンの判断を伴うエージェント的なタスク全般に応用できる可能性はありますが、現時点で検証されているのはストリーミング動画理解という限られた範囲です。より大きなモデルや他のドメインへ広げたときに同じ効果が出るかは、今後の検証を待つことになります。
論文情報: "Turns Matter: Advancing Streaming Video RL via Turn-Level Credit"(Shuai Dong et al., 2026) arXiv:2611.06728
本記事の図(図1、図2、図4)は解説のため上記論文より引用しています。


