 AI-Papers
- 1タスクあたり約32枚の参照画像と20以上の制約から1枚の整合画像を作る「長文脈マルチリファレンス画像生成」を評価する専門家設計のベンチマーク
- エンティティ関係グラフを節点・辺・全体の義務に分解し、4,670個の原子的なチェック項目に落とし込む採点設計で二重ラベル一致率89.4%を確認
- 固定の画像生成器をエージェントで包むLongBanana-Genが直接生成を上回り、最良構成は総合78.4点に到達
研究の背景
画像生成モデルの評価は長らく「1枚のプロンプトから1枚の画像」を前提にしてきました。しかし実務で求められるのは、キャラクター設定資料、商品写真、背景のラフ、構図指示といった大量の素材を渡し、それらを矛盾なく1枚にまとめさせる使い方です。
この設定では、モデルは散在する視覚的な手がかりを探し出し、紛らわしい無関係な参照(ハードネガティブ)を無視し、属性を正しいエンティティに結び付け、全体として一貫した構図を組み立てる必要があります。既存のベンチマークは参照画像が数枚程度で、こうした長文脈での情報探索と結合の能力をほとんど測れていませんでした。
NeurIPS 2026のEvaluations and Datasetsトラックに採択された本論文は、この空白を埋めるためにLongBananaを提案します。専門家が設計し、専門家が検証したうえで、採点の根拠まで追跡できる形に整えた点が特徴です。
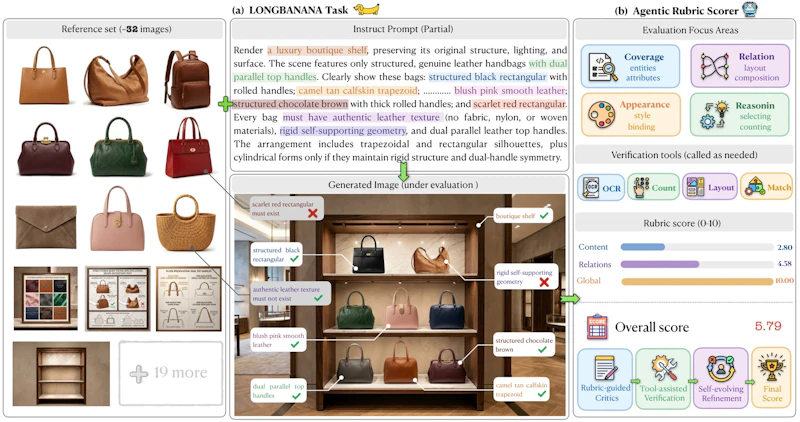
図1に示すように、各ケースは異種の参照画像群と構造化された指示のペアからなり、生成された画像はチェックリスト項目を経て次元別のスコアと監査可能な根拠に変換されます。
ベンチマークの設計
LongBananaは90ケースを3×3の分類体系で整理しています。行方向はScene Composition(場面の構成)、Visual Appearance(視覚的な外観)、Reference Reasoning(参照の推論)の3つのスイートで、列方向に細分類が並び、各サブクラスがちょうど10ケースを担当します。
1ケースあたりの規模は、参照画像が約32枚、参照をまたぐ制約が20以上、チェックリスト項目が平均約52個です。全体では4,670個の原子的な項目が積み上がり、30ケース以上には意図的に2枚以上のハードネガティブ参照が混ぜられています。
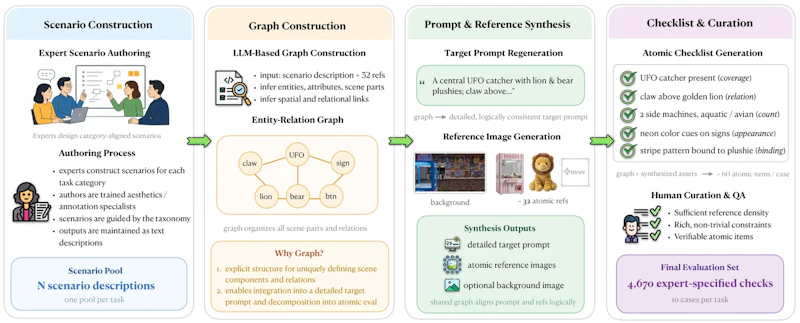
構築手順は図3の4段階です。まず専門家が分類体系に沿ってシナリオを書き、次にLarge Language Model(LLM)がそれをエンティティ、属性、関係、場面全体の制約からなるグラフへ構造化します。
そのグラフが指示文と参照画像の生成を導き、最後にグラフ上の制約が根拠と紐付いたチェックリスト項目へ翻訳されます。人手の監修者が指示・参照・チェックリストの整合性、視覚的な実現可能性、検証可能性をレビューする工程も挟まれています。
3つの評価次元と信頼性
採点はLongBanana-Evalが担います。グラフの節点に対応するのがContent Fidelity(必要なエンティティや属性が描かれ、禁止されたものが入っていないか)、辺に対応するのがRelational Binding(空間関係や局所的な外観の結び付け)、グラフ全体に対応するのがGlobal Constraint Satisfaction(レイアウト、個数、状態、参照の選び方)です。各項目は0・1・2の3値でラベル付けされ、0から100へ換算されます。
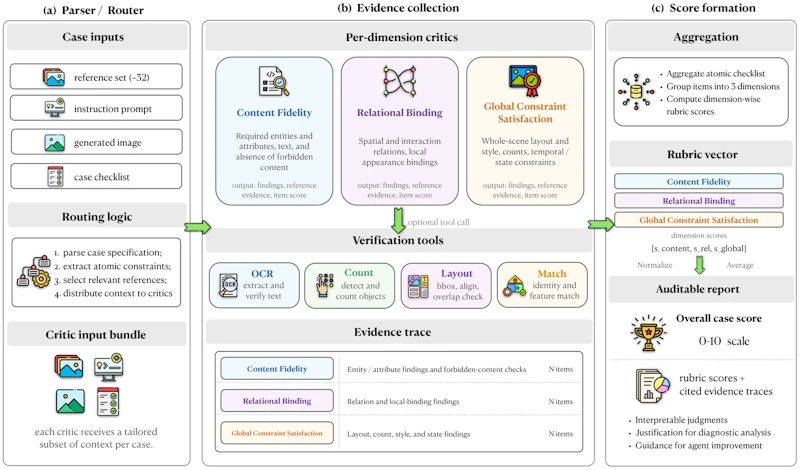
図4のように、パーサが項目固有の参照根拠を組み立て、各チェックを3つのクリティックのいずれかへ振り分けます。クリティックは根拠を確認し、必要なら検証ツールを呼び出して、ラベルと裏付けの履歴を返します。
信頼性の検証として、90ケース×10条件の900出力について46,700ラベルが人手でレビューされました。15%を二重ラベル化した7,005件のサブセットでは、完全一致率89.4%、二次重み付きカッパ係数0.83という高い一致が得られています。
判定器としての妥当性も確認されており、専門家スコアとの出力レベル相関はVLM-as-judgeのPearson 0.841に対しLongBanana-Evalが0.871、項目レベルの完全一致率は約15.8ポイント改善しました。生成モデルの評価設計そのものを問い直す研究としては、BestRandのようなベンチマーク圧縮の誤差を扱う研究とも関心が重なります。
実験結果
著者らは画像生成器を固定したまま、その外側をエージェントで包む枠組みLongBanana-Genも提案しています。エージェントモデルにはClaude Sonnet 4.6を共通で用い、参照の状態管理、プロンプトの組み立て、修正の反復を担わせます。さらにReAct(根拠の検索)、Plan-Exec(部分目標への分解)、Reflect(下書きの点検と改稿)を組み合わせたRPRワークフローを重ねます。
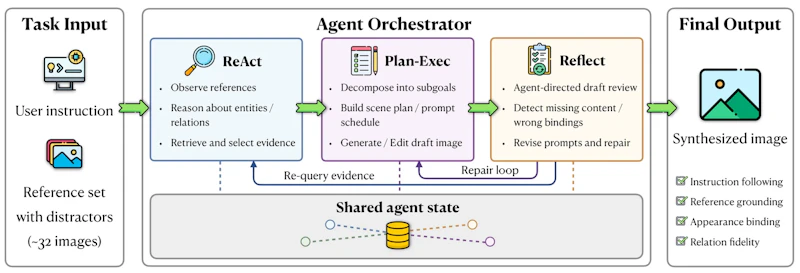
Nano Banana 2を画像生成器に固定した結果は次の通りです。P@70%は、総合70点以上に到達したケースの割合を示します。
構成 | 総合平均 | P@70% |
|---|---|---|
FP-Direct(直接生成) | 68.4 | 24.4 |
PD-Direct(グラフ情報あり) | 74.6 | 35.6 |
Hermes-Agent | 73.9 | 43.3 |
Hermes-Agent + RPR | 75.6 | 35.6 |
OpenCode | 77.3 | 47.8 |
OpenCode + RPR | 77.8 | 43.3 |
OpenClaw | 76.1 | 40.0 |
OpenClaw + RPR | 78.4 | 47.8 |
最小構成のエージェントハーネスでも直接生成を上回り、最良のOpenClaw + RPRは9サブクラスのうち8つでPD-Directを超えました。平均で3.8ポイント、P@70%で12.2ポイントの差です。
ただしRPRの効果はハーネス依存です。Hermes-Agentでは平均が73.9点から75.6点へ上がった一方でP@70%は43.3%から35.6%へ下がり、OpenCodeでも平均は微増ながらP@70%は47.8%から43.3%へ低下しました。平均点の改善が、閾値を超えるケースの増加に必ずしも結び付かないことを示しています。
画像生成器を替えた比較では、OpenClaw + RPRを固定した条件でNano Banana 2が78.4点、Seedream 4が63.6点、GPT Image 1が61.8点となり、バックエンドの違いが大きく出ました。なお、PD-Directはエージェント系が受け取らないグラフ情報を特権的に与えられている条件であり、比較の読み方には注意が必要だと論文自身が注記しています。
まとめと今後の展望
LongBananaは、参照画像が数十枚規模になったときの情報探索・属性結合・全体整合という能力を、根拠付きの原子的項目で分解して測る枠組みを提示しました。採点の一つ一つが監査できる設計は、スコアだけを比べる評価からの一歩前進と言えます。
一方で90ケースという規模は細分類ごとに10ケースしかなく、サブクラス単位の数値は少数のケースに左右されやすい点に留意が必要です。チェックリストの生成にLLMを使う以上、設計者が想定した制約の外側にある失敗は捉えにくいという構造的な限界もあります。コードとデータは公開されており、長文脈の参照を扱う生成パイプラインを設計する側にとっては、エージェントによる反復修正がどこで効きどこで効かないかを確かめる出発点になるでしょう。
論文情報: "LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis"(Haoxiang Cao et al., 2026) arXiv:2611.06856
本記事の図(図1、図3、図4、図18)は解説のため上記論文より引用しています。


