 AI-Papers
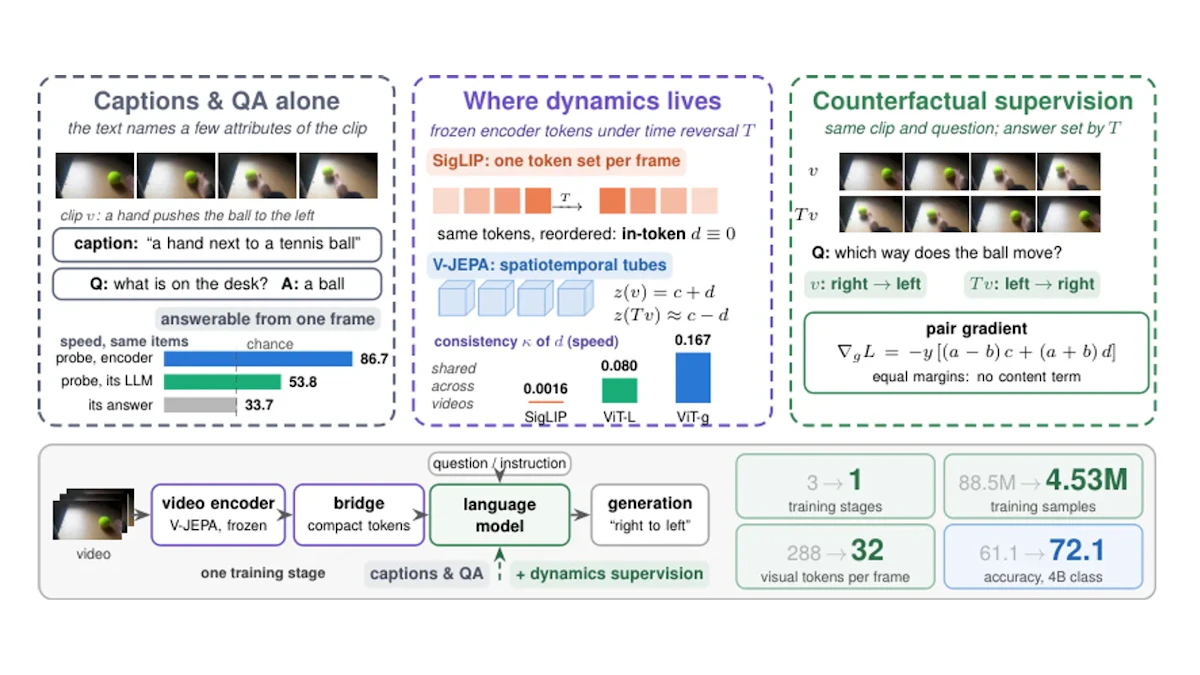
- V-JEPA特徴から線形プローブは物体の速度を86.7%で識別できるのに、同じ素材で動画言語モデルの正答率は33.7%のチャンスレベルにとどまる「読めるのに読んでいない」問題を特定
- ピクセル変換で動画を加工し、同じ質問に逆の答えが付く反実仮想ペアを自動生成。14種類の変換で4.53M件の学習データを構築
- 1フレーム32トークンの単一段階学習で、4Bモデルが動画11ベンチマーク平均72.1を記録し、既存公開モデルの4B(61.1)と8B(64.8)を上回る
研究の背景
動画を理解するAIの多くは、動画エンコーダ(映像を数値表現に変換する部分)と言語モデルを組み合わせた構成を取ります。エンコーダ側の候補として近年注目されているのがV-JEPAで、これは次の映像を予測する学習を通じて、物体の移動方向や速度、出来事の順序といった動きの情報を内部表現に蓄えます。
一方で言語モデル側の学習には、キャプション(映像の説明文)と質問応答ペアが使われます。ここに落とし穴がありました。キャプションや質問文は映像の属性のうちごく一部しか言及しないため、言語モデルは映像を見る代わりに、テキストから想起できる属性を取り出す振る舞いを覚えてしまいます。
Hanyang Universityの研究チーム(Keuntae Kim氏ら)は、この食い違いを定量的に示し、データ側の工夫で解消する手法V-JEPA-LMを提案しました。論文の結論は「エンコーダが何を読めるかを決め、教師データが何を読むかを決める」という一文に集約されています。
読めるのに読んでいない
チームはまず、速度の比較を問う540件のテスト項目(3択なのでチャンスレベルは33.3%)で診断を行いました。凍結したV-JEPA特徴に線形プローブ(単純な線形分類器を後付けして情報の有無を調べる手法)をかけると86.7%で正解が読み取れます。
キャプションと質問応答だけで学習した2Bモデルでも、エンコーダと言語モデルをつなぐ橋渡し層の出力では83.5%が残っていました。ところが言語モデル内部の層に進むと47〜54%程度まで落ち、最終的なモデルの回答精度は33.7%、つまりまったく当てられていません。情報はモデルに届いているのに、回答の生成過程で捨てられているわけです。
図1はこの構図をまとめたものです。キャプションと質問応答が教えること、動きの情報がエンコーダのどこに宿っているか、そこから組み立てた教師信号という3点が左から順に示されています。追加の分析では、動きの情報は予測型エンコーダでは複数の動画に共通する部分空間に収まる一方、SigLIPのようなフレーム単位でテキストと対応づける方式のエンコーダではそうした構造が見られないことも報告されました。
反実仮想データの作り方
解決策として採用されたのが、ピクセルレベルの変換で動画自体を加工し、答えが変換によって一意に決まるデータを作る方法です。たとえば同じクリップを順方向と逆方向で用意すれば、「物体はどちらに動いたか」という同一の質問に対して正解が反転します。図2がこの生成例で、32フレームのうち4枚が示されています。
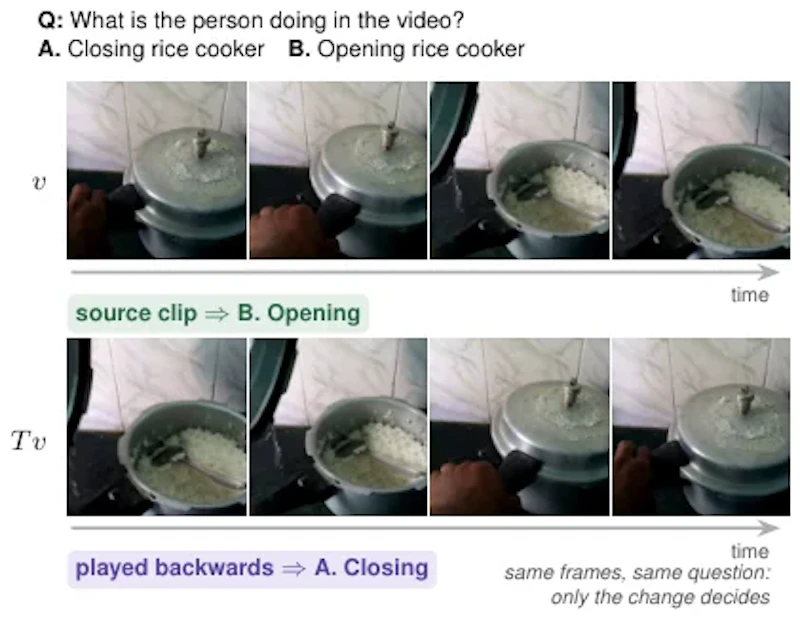
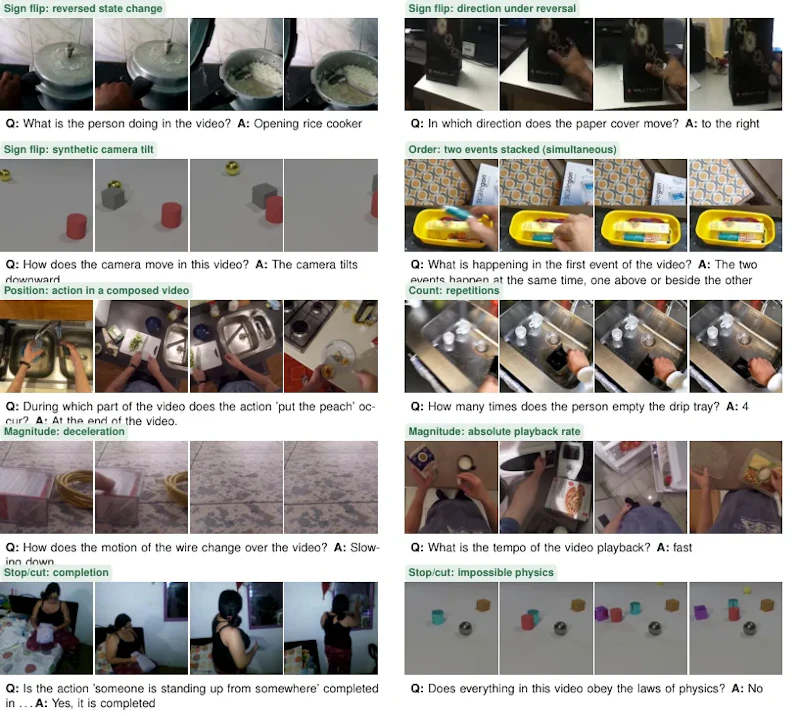
ペアになった2本は問われている変化以外は完全に同じ映像なので、テキストの手がかりや背景の常識から答えを推測する余地がありません。答えを出すには映像の動きを実際に読む以外の方法がないという状況を、データ側で強制的に作り出しています。論文では以下の6系統、計14種類の変換が使われました。
- 符号反転(逆再生、方向の鏡像反転、カメラのパンやズームの反転)
- 順序(2本のクリップの連結、同時提示、2動作キャプションとの対応づけ)
- 位置(問われた動作が冒頭・中間・末尾のどこにあるか)
- 大きさ(再生時間の伸縮による加速・減速・一定、スローやタイムラプス)
- 回数(同じ動作の反復回数、1〜4種類の活動の連結)
- 停止と切断(動作完了前のカット、シミュレータによる物理的に可能・不可能な編集)
図6には各構成の学習サンプルが1行ずつ並び、どの変換がどの質問と答えに結び付いているかを確認できます。重要なのは、正解の分布が設計上均衡している点です。回答の偏りを学習して当てにいく抜け道があらかじめ塞がれています。
学習構成と効率
V-JEPA-LMは4.53M件の公開サンプルを使い、段階を分けない単一段階で学習されます。既存の公開動画言語モデルが9M〜172M件のデータを複数段階で使い、1フレームあたり平均64〜256トークンを割り当てているのに対し、本手法は1フレーム32トークンに抑えています。視覚トークンの設計が性能を左右するという観点は、dNaViTとは?離散視覚トークンで理解・生成・編集を統一する新手法でも扱われているテーマです。
バックボーンにはQwen3とLlamaが使われ、1Bから8Bまでのモデルが用意されました。データ量とトークン数の両方を削りながら性能を上げている点が、この研究の実用面での価値になります。
実験結果
評価にはMVBench、PerceptionTest、TVBench、TempCompass、TOMATO、MotionBench、NExT-QA、MVP、TemporalBench、SSv2、Vinogroundの11ベンチマーク(Vinogroundはテキストと動画の2スコア)が使われ、比較対象の公開モデルも32フレーム・選択肢記号での採点という同一条件で測り直されています。
サイズ帯 | 既存公開モデルの最良 | V-JEPA-LM |
|---|---|---|
2B | Qwen3-VL-2B:52.45 | 66.02 |
4B | Molmo2-4B:61.08 | 72.14 |
8B | PLM-8B:64.79 | 70.51 |
4Bモデルの72.14は、同サイズ帯の最良値を11ポイント、ひとつ上の8B帯の最良値も7ポイント以上引き離した数字です。Metaの動画言語モデルとの比較では、共通する6ベンチマークでV-JEPA 2が63.3、V-JEPA 2.1が62.8に対し、本手法の8Bモデルが70.0を記録しました。
手法の寄与を切り分けるため、2Bモデルで同一予算のもとエンコーダと教師データを組み替えた比較も行われています。V-JEPAにキャプションと質問応答のみを与えた場合の平均61.53に対し、反実仮想データを加えると66.02まで上がりました。SigLIPでも58.52から62.13へ改善しており、反実仮想データの効果はエンコーダの種類に依存しません。
診断対象だった速度の質問では、自然なベンチマーク上の正答率が32.4%から65.3%へ跳ね上がり、論文は全体として約38ポイントの改善を報告しています。先の線形プローブ診断を再実行すると、橋渡し層で91.2%、モデルの回答自体も92.8%に達しました。一方、逆再生の判別だけを教える「時間の矢」単独の学習は61.17で、キャプションと質問応答のみとほぼ同じでした。単一の手がかりを教えるだけでは足りず、変換の多様さと答えの均衡が効いていることになります。
課題と展望
限界も明示されています。V-JEPAは映像の予測を学ぶエンコーダであってテキストを読む設計ではないため、文字認識や単一画像の理解は対象外です。長時間動画についても、この規模での学習は計算コストの面で現実的でないとして今後の課題に残されました。
とはいえ、評価データを増やすのではなく「何を読まざるを得ないか」をデータ側で設計するという考え方は、動画以外のマルチモーダル学習にも持ち込める発想です。コードとモデルはGitHubで公開されており、追試や他ドメインへの応用も進めやすい状態にあります。
論文情報: "V-JEPA-LM: Video-Language Models That Read Dynamics Beyond Static, Text-Aligned Representations"(Keuntae Kim, Dongjun Kim, Yong Suk Choi, 2026) arXiv:2611.17831, CC BY 4.0
本記事の図(図1、図2、図6)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


