 AI-Papers
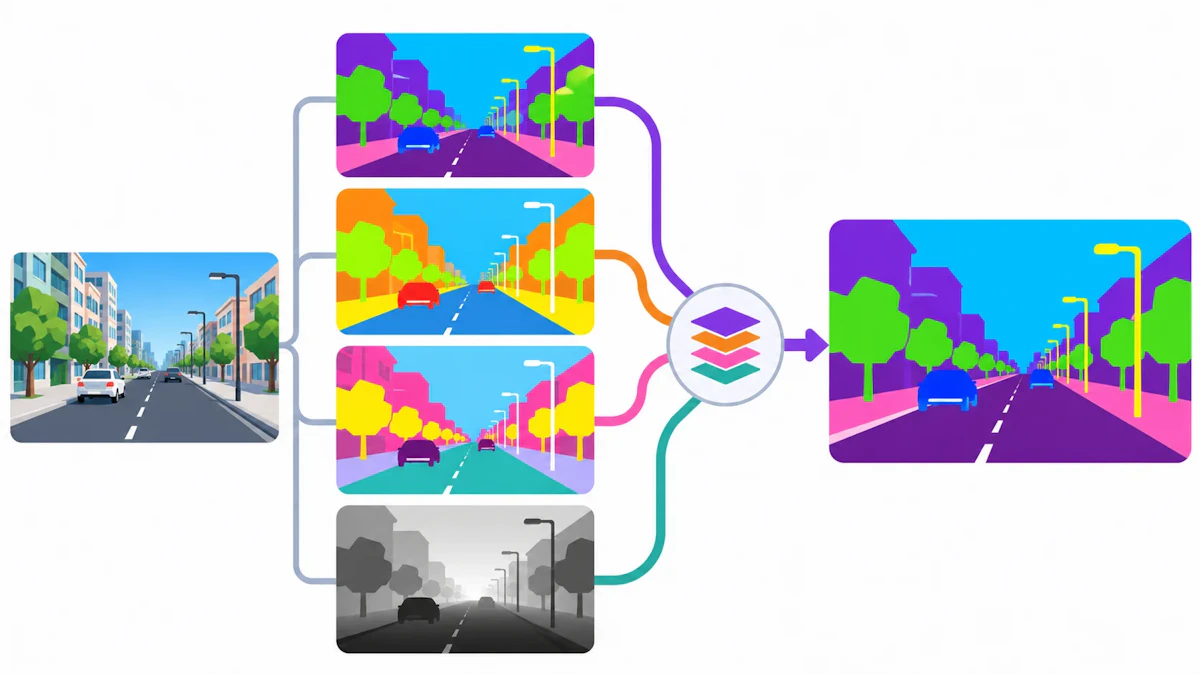
- 事前学習済み画像生成モデルを、セグメンテーションや深度推定などの視覚認識タスクへ転用する手順を完全公開した研究です
- 公開データ210万〜380万ペアのみの学習で、Cityscapesのゼロショット性能は73.9 mIoUと非公開のVision Banana(69.9)を上回りました
- 再学習なしで使える推論時手法「legend ensembling」により、Cityscapesで65.4から73.9 mIoUへ改善しています
研究の背景
画像生成モデルは、大量の画像とテキストから世界の見え方を学んでいます。その内部表現を認識タスクに使えないかという発想は以前からありましたが、近年注目されたのが「視覚タスクを条件付き画像編集として扱う」考え方です。
たとえばセマンティックセグメンテーション(画像の各ピクセルがどの物体カテゴリに属するかを塗り分けるタスク)であれば、入力画像を「道路を紫、歩行者を赤に塗り替えた画像」へ編集する問題として解かせます。深度推定も、近いほど明るい画像への変換として表現できます。この路線で高い性能を示したVision Bananaというモデルが登場しましたが、データ・重み・コード・実装の詳細はいずれも非公開でした。
そのため、どの設計判断が性能に効いているのかを外部から検証できない状態が続いていました。Open Vision Banana(OVB)は、この空白を埋めるために提案された再現可能なレシピです。著者らはFLUX.2 Klein の4Bと9Bという公開重みのモデルを出発点に、公開データセットのみで学習を行いました。
4つの設計因子を体系化
論文の中心は、生成モデルを認識器に変える際に効く設計因子を切り分け、その相互作用を調べた点にあります。著者らが取り上げたのは次の4つです。
- 色エンコーディング(クラスと色の対応をどう決めるか)
- プロンプト設計(どのクラスを指示文に並べるか)
- パラメータ適応(モデルのどこを学習させるか)
- タスクバランス(生成・編集データをどれだけ混ぜるか)
色の扱いは特に影響が大きい因子でした。クラスと色の対応を固定して学習させると、分布内では53.9 mIoU(予測領域と正解領域の重なり具合を0〜100%で表す指標。高いほど良い)に達する一方、テスト時に色の割り当てを変えるだけで7.1まで崩れます。つまりモデルは色の対応を暗記してしまい、指示文を読んでいません。学習時に色をランダムに振り直すことでこの問題は解消し、互いに見分けやすい64色のパレットを使う設定が最も良い結果となりました。
プロンプト設計では、クラスの部分集合をランダムに提示する例を70%、画像内の全クラスを提示する例を15%、画像に存在しないクラスを混ぜる例を15%という混合が採用されています。部分集合だけで学習すると、全クラスをまとめて要求された際に約15 mIoU低下しました。
パラメータ適応では、VAE(画像を圧縮して復元するニューラルネット)とテキストエンコーダを凍結したうえで、Transformer(入力の重要な部分に注目する仕組みを積み重ねたネットワーク本体)の全パラメータを学習させる設定がほぼ全タスクで最良でした。LoRA(少数の追加パラメータだけを学習する軽量な手法)はランク64〜128で編集・深度・法線推定では全体学習に並びますが、セマンティックセグメンテーションでは約12 mIoU届きません。学習データには生成タスクを15%、編集や同一画像の再現を25%混ぜています。これらを外すと幾何タスクや編集能力の維持が悪化し、因子どうしが独立でないことが示されました。
推論時の多数決で精度向上
もう一つの提案が legend ensembling です。同じ画像に対して、クラスと色の対応表(legend)をランダムに変えながら複数回推論し、それぞれの出力を自分のlegendでクラスIDへ読み戻したうえで、ピクセルごとの多数決で統合します。図4がこの流れを示しています。
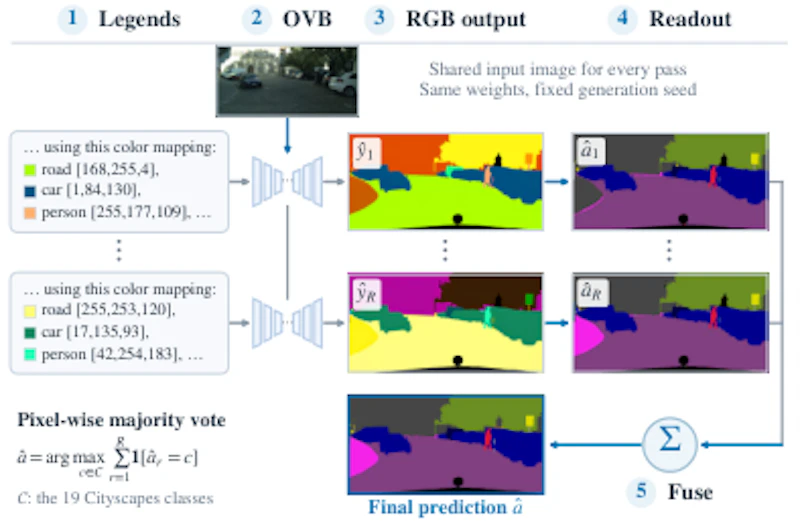
9Bのゼロショットモデルでは、Cityscapesで1回の推論が65.4 mIoUだったのに対し、20回の多数決で73.9まで上がりました。COCO-Objectでは38.7から90回で53.0へと伸びています。再学習は不要で、計算時間を増やすだけで精度が改善する点が実用面での利点です。
著者らは、予測領域の形を理想的に塗り直した場合のスコア(オラクル)が85.6付近でほぼ変わらないことを示し、改善の多くは領域の形ではなく色とクラスの結び付けの誤りが直ることによると分析しています。図7のように、抜け落ちていた道路や誤ってラベル付けされたバスが復元される様子が確認できます。
実験結果
主要な結果を下表にまとめます。ZSはゼロショット(評価対象データセットを学習に使わない設定)を指します。cIoUとgIoUは参照表現セグメンテーションでの重なり具合、cgF1はインスタンス分割の検出精度と再現率の調和平均、δ1は深度の予測誤差が一定範囲に収まったピクセルの割合です。
モデル | ZS | Cityscapes mIoU | RefCOCOg cIoU | ReasonSeg gIoU | SA-Co/Gold cgF1 | NYUv2 δ1(%) | 法線誤差(度) |
|---|---|---|---|---|---|---|---|
OVB 9B | ✓ | 73.9 | 57.4 | 67.1 | 37.4 | 97.4 | 19.85 |
OVB 9B | ✗ | 75.7 | 69.2 | 68.6 | 39.6 | 99.0 | 13.51 |
OVB 4B | ✓ | 71.3 | 57.0 | 67.9 | 34.0 | 97.5 | 19.87 |
OVB 4B | ✗ | 76.4 | 65.6 | 74.6 | 35.9 | 98.7 | 13.21 |
Vision Banana | ✓ | 69.9 | 73.8 | 79.3 | 47.5 | 94.8 | 17.8 |
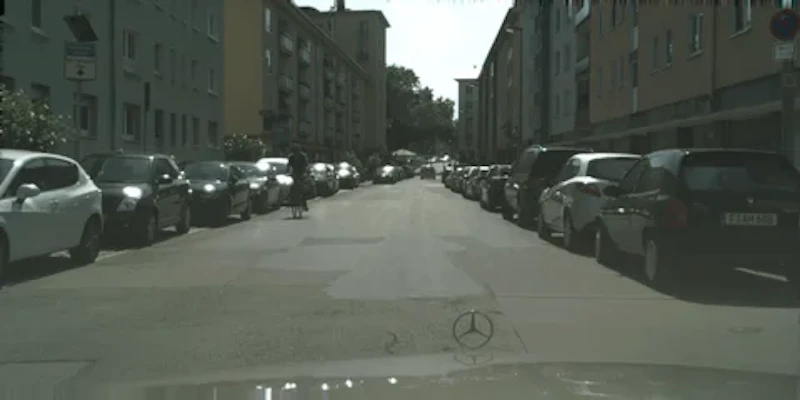
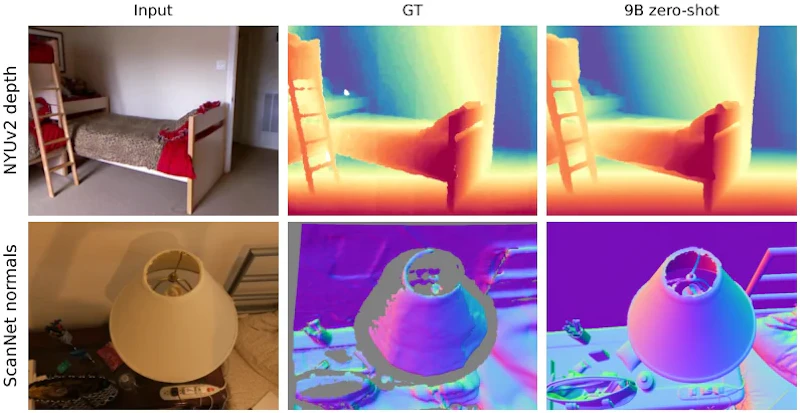
Cityscapesでは、学習データ全体のわずか0.13%しか同データセットを含まない非ゼロショット設定で76.4、完全なゼロショットでも73.9に達し、Vision Bananaを上回りました。深度推定もNYUv2で97.4%と、アフィン不変な深度推定の最先端手法に並ぶ水準です。図2は実際のセグメンテーション結果、図8は深度と法線の予測例を示しており、都市風景のような構造化された場面での安定性がうかがえます。
一方で、言語理解を強く要求するタスクには差が残ります。参照表現セグメンテーションでは、非ゼロショットの最良値で比べるとRefCOCOgが69.2に対しVision Bananaが73.8で差は4.6ポイント、推論を伴うReasonSegは4Bの74.6に対し79.3で差は4.7ポイントです。ゼロショット設定では差がさらに広がり、RefCOCOgで16.4ポイント、ReasonSegで12.2ポイント届きません。インスタンス分割のSA-Co/GoldはSAM 3の54.1やVision Bananaの47.5に対して39.6にとどまり、課題が残る領域だと著者ら自身が述べています。
生成能力の維持についても検証されています。ImgEdit-Benchの基本編集では9Bのベースモデル3.89に対しOVBが3.86〜3.89とほぼ同等でした。ただしテキストから画像を生成する能力はVQAScoreで9Bが0.030、4Bが0.050低下し、認識能力の獲得と引き換えになるトレードオフが残ります。こうした統合の難しさは、理解と生成を1つの表現で扱うdNaViTのような研究とも共通する論点です。
まとめと今後の展望
OVBの価値は性能そのものより、再現できる形で設計判断を明らかにした点にあります。公開されたのはデータ構築・処理のパイプライン、学習と評価のコード、そして最終モデルに加えて学習途中のチェックポイントとアブレーション(ある要素を取り除いて影響を測る実験)用のチェックポイントまで含まれます。個別の設計因子を自分で入れ替えて検証できる状態になったことは、この分野の追試のハードルを大きく下げます。
残る課題も明確です。言語の解釈を必要とするタスクでは非公開モデルとの差が埋まっておらず、インスタンス分割では専用モデルに及びません。legend ensemblingも推論回数に比例して計算コストが増えるため、90回の多数決を常用できる場面は限られるでしょう。計算量を抑えつつ色とクラスの結び付けを安定させる方向に、次の改善余地がありそうです。
論文情報: "Open Vision Banana: A Fully Open Recipe for Generative Visual Perception"(Arpit Jadon et al., 2026) arXiv:2611.15844
本記事の図(図2、図4、図8)は解説のため上記論文より引用しています。


