 AI-Papers
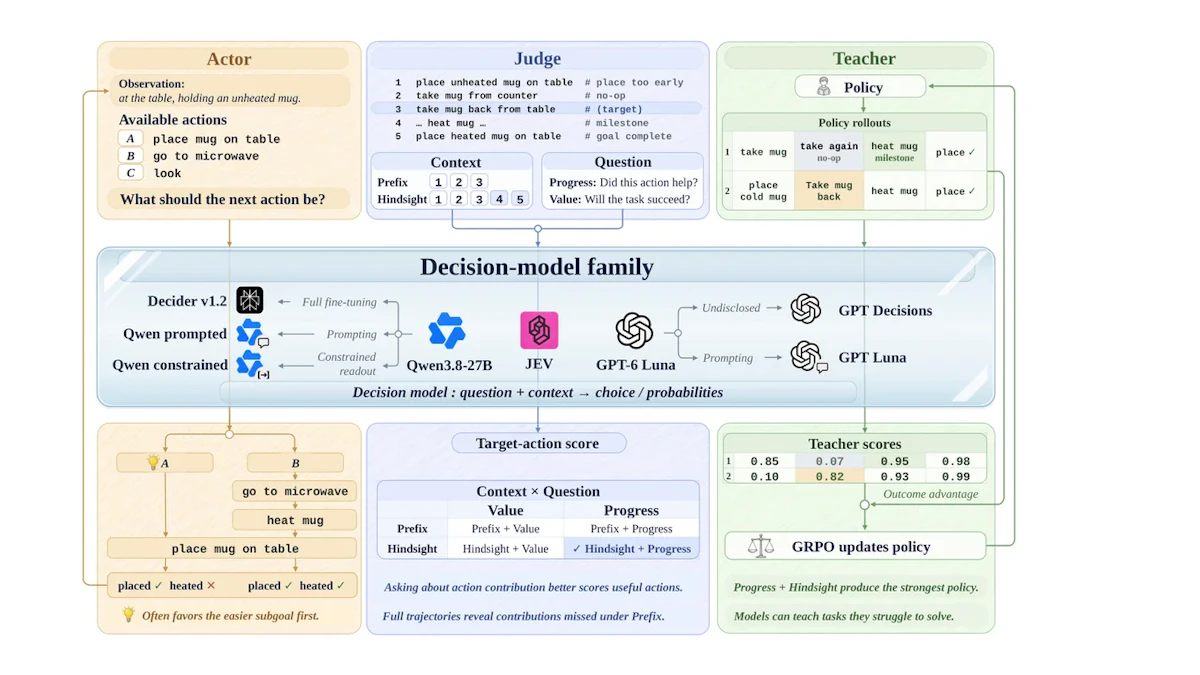
- 決定モデルをactor(行動)、judge(審判)、teacher(教師)の3つの役割で比較し、行動が苦手なモデルでも教師としては有用だと示した実証研究です
- エピソード終了後に全軌跡を見せ「この行動は目標達成に役立ったか」を問うHindsight+Progress報酬が鍵で、質問をValueからProgressに変えると節目の行動とno-op行動のスコア差が0.05から0.36へ広がります
- この報酬をGRPOに加えるとALFWorldは72.8%から82.9%、WebShopは56.8%から71.4%に改善し、1.5Bポリシーが結果報酬のみの7Bを上回りました
研究の背景
近年、選択肢の中から1つを選び、それぞれに確率を付けて返す「決定モデル」と呼ばれるタイプのモデルが登場しています。文章を自由に書くのではなく、型の決まった判断だけを出力する点が特徴です。
この種のモデルは、これまでもっぱら「行動する主体」として評価されてきました。エージェントの次の一手を選ばせ、タスクの成功率で良し悪しを測るという使い方です。
浙江大学などの研究チームが公開した論文「Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents」は、この前提を問い直します。同じ決定モデルは、行動を選ぶ以外にも、すでに取られた行動を採点したり、採点結果を報酬として強化学習のポリシーを鍛えたりできるはずです。行動が下手なモデルでも、教師としては優秀でありうるのかという問いが本研究の出発点です。
3つの役割で問い直す
研究チームは1つの決定モデルに対し、3通りの問い方を用意しました。図1は「温めたマグカップをテーブルに置く」という長期タスクを例に、3つの役割の関係を整理したものです。
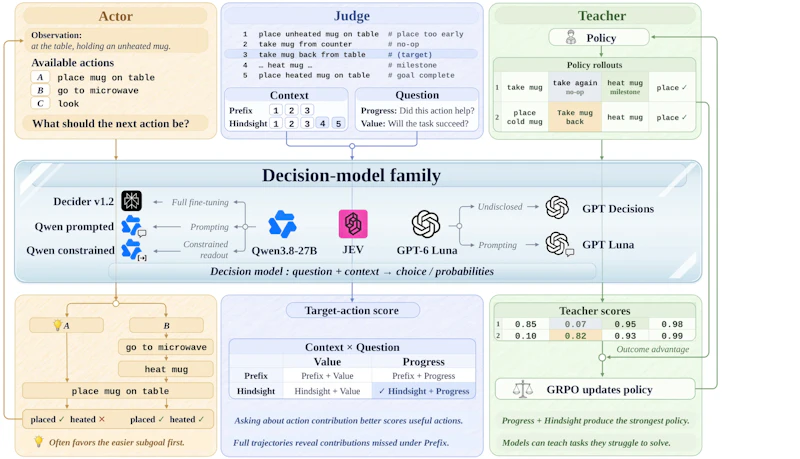
actorは次の行動を選ぶ役割、judgeは記録済みの軌跡から1つの行動を採点する役割、teacherはポリシーのロールアウトを採点して報酬に変える役割です。judgeとteacherには2つの軸が設定されています。
1つはモデルに見せる文脈の違いです。Prefixはその行動までの経過だけを見せ、Hindsightは成功・失敗のラベルを隠したうえで軌跡全体を見せます。もう1つは質問の違いで、Valueは「この行動の後タスクは成功するか」を、Progressは「この行動は目標達成に役立ったか」を尋ねます。
評価対象は専用の決定モデル3種と汎用Large Language Model(LLM)3種です。
- JEV(API のみ公開、ベースモデル非公表)
- Decider v1.2(Qwen3.8-27B をフルファインチューニング、重み公開)
- GPT Decisions(GPT-6 Luna ベース、クローズド)
- Qwen3.8-27B のプロンプト版と制約付き読み出し版
- GPT-6 Luna のプロンプト版
ベンチマークには家事タスクのALFWorldと商品購入タスクのWebShopという、いずれも複数ステップを要する環境が使われています。
行動役としての弱点
ALFWorldでのactorとしての成功率は、Decider v1.2が63.6%で最も高く、GPT Decisionsが52.9%、Qwenのプロンプト版が49.3%、制約付き版が45.0%、JEVが42.9%、GPT-6 Lunaが34.3%でした。専用の決定モデルが一律に強いわけではなく、JEVは汎用LLMのプロンプト運用よりも低い水準にとどまっています。
さらに6モデル全てに共通する弱点が見つかりました。先に済ませなければならないサブゴールがあるタスクで、より簡単な別のサブゴールに引っ張られてしまうのです。たとえばマグカップを温める前に置いてしまう、といった順序の取り違えが起きます。
プロンプトに依存関係のヒントを足しても成功率の変化は-2.8%から+5.2%の範囲で、問題は指示の書き方ではなく、行動選択時に将来の帰結を見通せないことに起因すると考えられます。
審判役は事後評価で変わる
同じモデルをjudgeとして使うと様子が変わります。JEVの平均スコアはPrefix文脈で0.41、Hindsight文脈で0.59と上昇し、軌跡全体が見えることで行動の意味を読み取れるようになりました。
より効いたのは質問の立て方です。図5に示すように、同一軌跡内で節目となる行動と何も進展しないno-op行動のスコア差は、Progressで尋ねると0.36まで開く一方、Valueで尋ねた場合は0.05しかありません。つまり質問をValueからProgressに変えるだけで、両者の差が0.05から0.36へ7倍以上に広がるわけです。
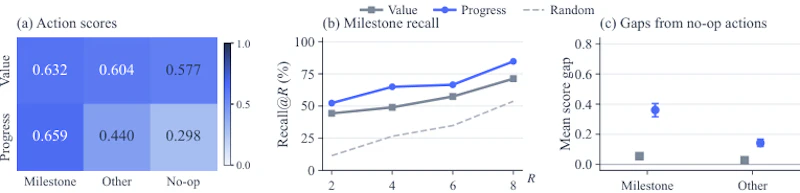
Progressは各軌跡の上位に節目の行動を8%から16%多く拾い上げました。また専用の決定モデルは、ベースとなった汎用LLMより正確に採点しつつ、1スコアあたりのコストが28%から43%低いという結果も得られています。採点の精度と費用の両面で、専用モデルは審判役に向いているといえます。
教師として使った結果
最後に、JEVのスコアを報酬として小さなポリシーを学習させます。手法はGRPO(Group Relative Policy Optimization、同じ問題に対する複数の出力を比較して相対的な優劣から学習する強化学習手法)で、中心化した行動スコアを結果報酬のアドバンテージに重み0.5で足し込む形です。
結果を下表にまとめます。いずれもタスク成功率です。
ポリシー | 手法 | ALFWorld | WebShop |
|---|---|---|---|
Qwen2.5-1.5B | GRPO(結果報酬のみ) | 72.8% | 56.8% |
Qwen2.5-1.5B | Hindsight + Value | 69.3% | 68.3% |
Qwen2.5-1.5B | Hindsight + Progress | 82.9% | 71.4% |
Qwen2.5-7B | GRPO(結果報酬のみ) | 77.6% | 66.1% |
Qwen2.5-7B | Hindsight + Progress | 83.8% | 73.6% |
Hindsight+Progressを加えた1.5Bのポリシーは、結果報酬のみで学習した7B(ALFWorld 77.6%、WebShop 66.1%)を両ベンチマークで上回りました。教師役を担ったJEVはactorとしては42.9%しか出せなかったモデルであり、行動の巧拙と教える力が別物だという本研究の主張を裏づけています。
一方、Hindsight+ValueはALFWorldで69.3%と結果報酬のみを下回りました。事後に見せるだけでは足りず、「役に立ったか」という問い方が揃って初めて報酬として機能することを示しています。なお表の82.9%は全タスクの成功率ですが、actorが苦手としていた順序依存のサブゴールを含むタスクに限ると、1.5BのHindsight+Progressは86.8%に達し、同じタスク集合における他の報酬設定より6.9から16.2ポイント高い水準でした。教師の報酬が、行動選択だけでは埋められなかった弱点を補っていることになります。
限界と今後
検証はALFWorldとWebShopという2つのテキスト環境に限られ、エピソード長も最大30行動です。実世界の長期タスクやマルチモーダルな環境に同じ構図が当てはまるかは未検証といえます。
また採点はエピソード終了後に行うため、生成中に行動を弾くオンラインのフィルタリングには使えません。JEVやGPT Decisionsは学習手順が非公開で、どの訓練上の選択が良い審判役を作るのかまでは特定できていない点も著者自身が認めています。
とはいえ、学習1回あたりのAPI費用が22ドルから30ドル程度で、コードもGitHubで公開されているため、小規模な追試が現実的です。教師モデルでポリシーを鍛える発想そのものは、量子化エージェントの劣化を教師の誘導で補うSteerDistillなどとも通じるものがあり、エージェント向け強化学習の報酬設計を考えるうえで参照しやすい結果だと言えるでしょう。
論文情報: "Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents"(Haochen Liu et al., 2026) arXiv:2611.17167, CC BY 4.0
本記事の図(図1、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


