 AI-Papers
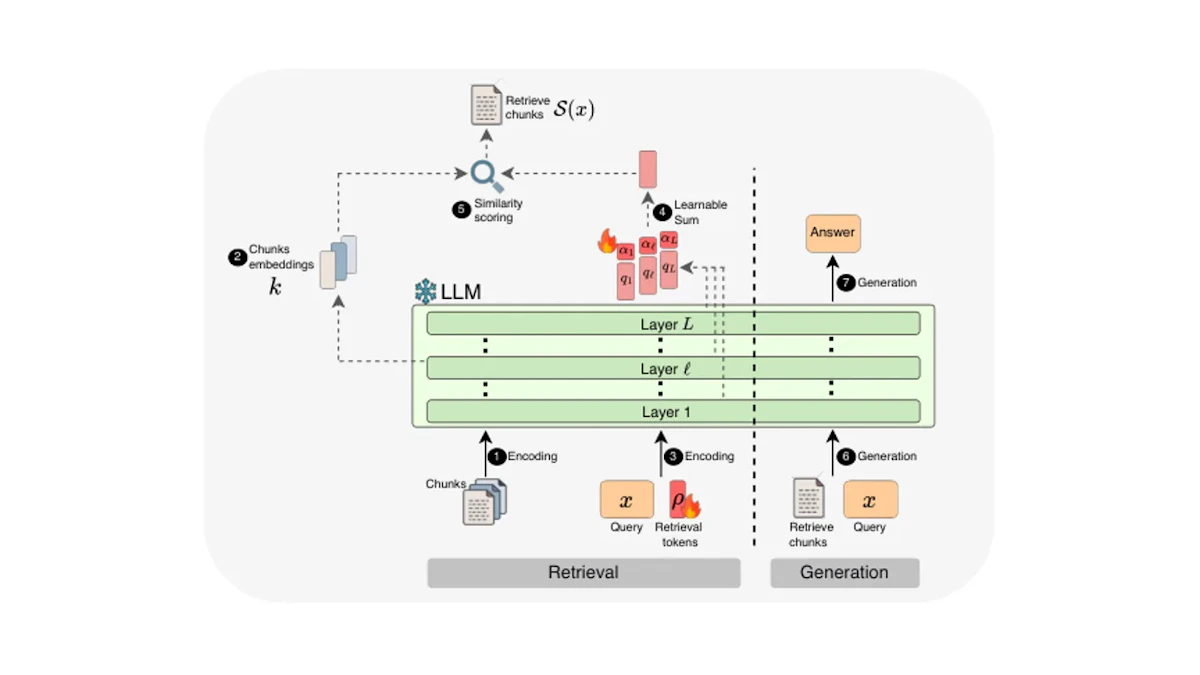
- 凍結した大規模言語モデル(LLM)の内部表現からチャンク埋め込みと検索クエリを導出し、外部の検索モデルを使わずに証拠選択を行うUNREALが提案されました
- 追加学習するのは検索トークンと層の重み付けなど50万パラメータ未満で、バックボーンのLLMは一切変更しません
- 2100万チャンク規模の検索でHotpotQAの再現率が49.1%から73.2%へ、128KトークンのNoLiMaでは精度が1.0%から24.83%へ改善しました
研究の背景
LLMに外部知識を使わせる方法は、大きく2つの系統に分かれてきました。1つは巨大なコーパスから関連文書を引いてくるRetrieval-Augmented Generation(RAG、検索拡張生成)、もう1つは長いプロンプトをまるごとモデルに読ませる長文脈処理です。
この2つは目的が似ているのに、実装はまったく別物でした。RAGでは埋め込みモデルや再ランキングモデルといった専用の検索器を別に用意し、インデックスを構築して運用します。長文脈処理では検索器を使わない代わりに、注意機構の計算量が文脈長の2乗で増え、無関係な記述(distractor)に引っ張られて精度が落ちる問題が知られています。
NVIDIAとTechnion(イスラエル工科大学)の研究チームが発表したUNREAL(UNifying REtrieval And Long-context with a single model)は、この分断に対して「答えを生成するLLM自身が、証拠の選択もこなせるのではないか」という問いを立てました。コーパス全体からの検索と、1つの長いプロンプト内からの証拠選択を、同じ1つのモデルの内部機構で処理するという発想です。
提案手法
UNREALの中心的なアイデアは、LLMの残差ストリーム(各層を流れる中間表現)をそのまま検索用のベクトルとして使うことです。コーパス側の各チャンクは、凍結したLLMに1度だけ通し、開発セットで選んだ中間層のトークン表現を取り出します。論文では中盤から後半の層が最も有効でした。保存コストを抑えるため、トークン表現は7個のグループに平均プーリングして格納します。
クエリ側はもう少し工夫されています。まずBM25(単語の出現頻度に基づく古典的な検索手法)で上位5件のチャンクを初期文脈として与え、その後ろにクエリと64個の検索トークン(ρ)を並べて1回だけLLMを通します。検索トークンの隠れ状態は全層から読み出し、学習された重み(α)で層をまたいで混ぜ合わせることでクエリベクトルを作ります。チャンクとの照合には、トークン単位で最も近い組み合わせを取るMaxSim方式の遅延相互作用(late interaction)を使います。
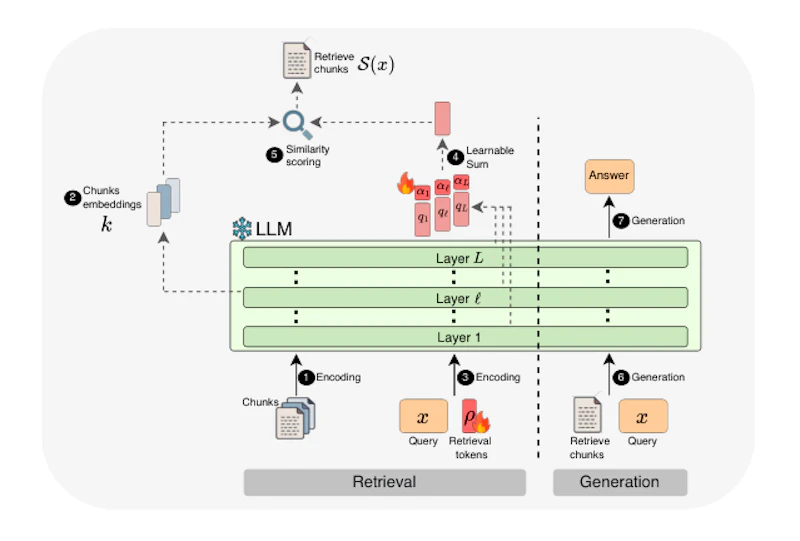
図2に示すように、学習されるのは検索トークンρ、層の重みα、そしてクエリ側に付くソフトプロンプトだけです。合計で50万パラメータ未満、各バックボーンの0.005%未満にとどまり、LLMの重みは凍結されたままです。学習は正解チャンクとBM25で集めた最大500件のハードネガティブを対比させるInfoNCE損失で行い、NQ、SQuAD v2、HotpotQA、2WikiMultiHopQA、MuSiQue、IIRC、FEVER、HoVerの8つのデータセットを使って15Kステップ回しています。
推論時の流れは4段階です。チャンクの符号化はオフラインで1度だけ済ませ、クエリごとにLLMを1回通して検索ベクトルを得て、全チャンクをスコアリングし、上位n件のテキストを同じLLMに渡して回答を生成します。検索と生成で別のモデルを持つ必要がありません。少数パラメータの追加だけで長文脈の弱点を補うという方向性は、小さなLoRA 1枚で参照追跡精度を改善した研究とも通じるものがあります。
実験結果
評価には30億トークン、2100万チャンクのWikipedia 2018インデックスを使い、BM25、BGE-large-en-v1.5、Qwen3-Embedding(0.6Bと4B)、Jina reranker v2、LateOn、ハイブリッドRAG、そして全文脈推論と比較しています。マルチホップQA(複数の文書をたどって答える問題)での再現率と、長文脈ベンチマークでの精度が主な指標です。
評価項目 | 比較対象の最良値 | UNREAL |
|---|---|---|
HotpotQA 再現率 | 49.1% | 73.2% |
2WikiMultiHopQA 再現率 | 31.7% | 60.1% |
MuSiQue 再現率 | 8.8% | 14.4% |
HotpotQA EM / F1 | 43.3 / 55.3 | 52.6 / 65.8 |
NoLiMa 精度(128K) | 1.0% | 24.83% |
LV-Eval F1(256K) | 49.97% | 54.66% |
生成側をNemotron-3.5-LightningとQwen3.5-35B-A3Bに替えても傾向は同じで、どちらのバックボーンでもHELMETのRAGタスクで最高のExact Matchを記録しました。128Kトークンという厳しい条件下でNoLiMaの精度が1.0%から24.83%へ上がった点は、長文脈をそのまま読ませる方式が実質的に機能していなかったことを示しています。
切り分け実験では、複数層からの読み出しを単一層に戻すと影響が最も大きく、HotpotQAのR@10平均で約8ポイント落ちました。層ごとの情報を組み合わせることが性能の鍵だとわかります。一方、チャンクあたりの保存ベクトル数を増やすと再現率は単調に上がりますが、ストレージと計算コストも比例して増えます。
計算コストの評価
効率面では、チャンクを独立に符号化し、生成時には選ばれたチャンクにしか注意を向けないため、計算量が文脈長に対してほぼ線形に増えます。全文脈注意の2乗オーダーと比べると、文脈が長くなるほど差が開く構造です。
FLOPs(浮動小数点演算数)が全文脈推論と釣り合う分岐点は、Qwen3.5-35B-A3Bで約4.1Kトークン、Nemotron-3.5-Lightningで約6.3Kトークン、Muse-Glimmer-30Bで約13.0Kトークンでした。H100 1枚とvLLMで実測した結果では、32Kトークン付近から時間対初回トークン(TTFT)が短縮され、文脈が伸びるほど差が広がります。ただし測定範囲を超える領域の数値はFLOPsベースの推定値であり、実測ではありません。
限界と今後の展望
論文は制約もはっきり書いています。主な点は次のとおりです。
- 学習データがWikipedia由来のQAに限られ、他ドメインや多言語への転移は未検証
- 長文脈評価が、証拠が疎に散らばるタスクに偏っている
- チャンクごとに複数ベクトルを持つため、単一ベクトル索引よりストレージコストが高い
- 初期文脈をBM25に依存しており、その品質が結果に影響する
- 複数回の検索を繰り返すエージェント型RAGとの比較は行っていない
抽出型QAに特化したモデルと比べれば、汎用LLMで答えさせる構成が常に有利とは限らない点も認めています。今後の方向としては、検索と生成を同時に学習させることや、ベンチマーク側が精度と並んで証拠の再現率を報告するようにすることを挙げています。
検索器と生成器を別々に育てる現在の構成は、運用の手間もモデル間の不整合も抱えています。追加パラメータ50万未満でその両方を1つのモデルに畳み込めるなら、RAGシステムの設計は今より素直なものになるでしょう。ドメイン外での挙動が確かめられるかが、実用化の分かれ目になりそうです。
論文情報: "UNREAL: Unifying Retrieval and Long-Context with a Single Model"(Edan Kinderman et al., 2026) arXiv:2610.08463, CC BY 4.0
本記事の図(図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


