 AI-Papers
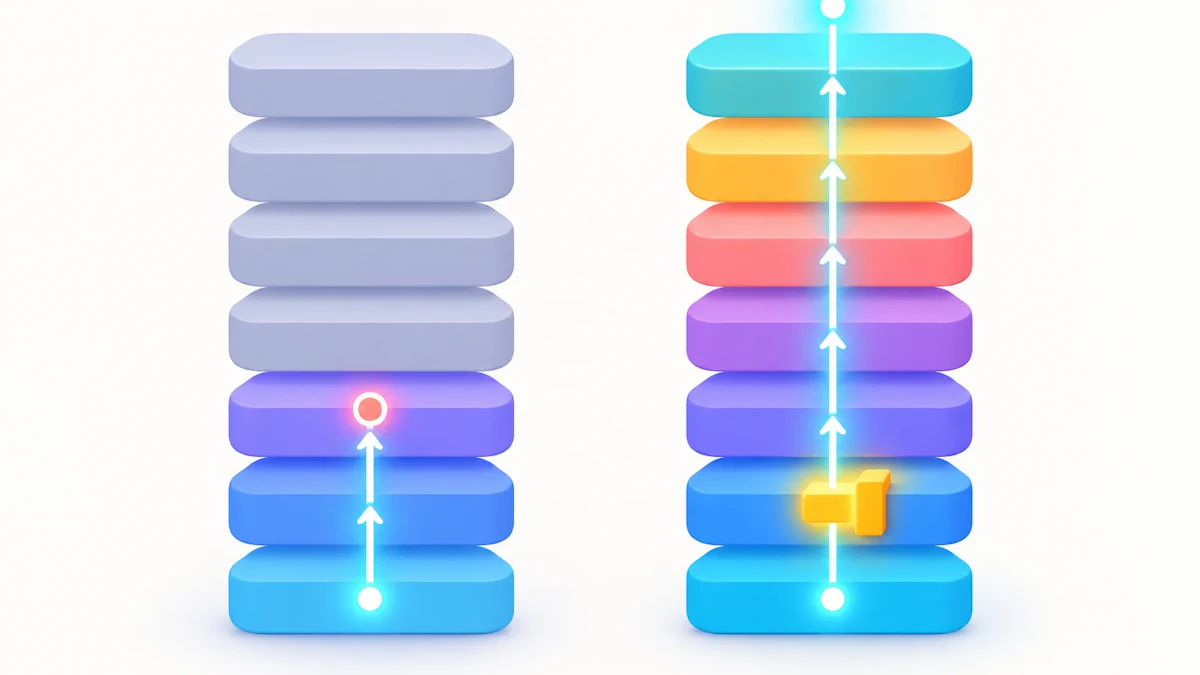
- 13種類の事前学習済みモデルを調べると、文脈内の参照を確実に辿れるのは1.4〜3.6行分だけで、モデルを大きくしてもほとんど改善しないことが判明
- 全重みを凍結したまま浅い層1か所にrank-8のLoRAを挿すだけで、Qwen3-8Bの24行連鎖の正解率が15.5%から99%へ向上
- LoRAは中間層をまたぐ「リレー」を起動し、凍結されたままのAttentionヘッドが連鎖をより上まで読み進めるようになる
研究の背景
大規模言語モデルは数十層ものTransformerブロックを積み重ねていますが、その深さが推論にどこまで使われているのかは意外とわかっていません。Zehao Jin氏らの論文「Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It」は、この疑問に対して明確な測定結果を示しました。
研究チームが用意した課題は単純です。プログラムのような行の並びを与えます。たとえば K = apple、B = K、D = B と続けて、最後の変数が何を指すかを答えさせます。人間なら矢印を遡るだけの作業ですが、モデルにとっては参照を1段ずつ解く処理を層の数だけ繰り返す必要があります。
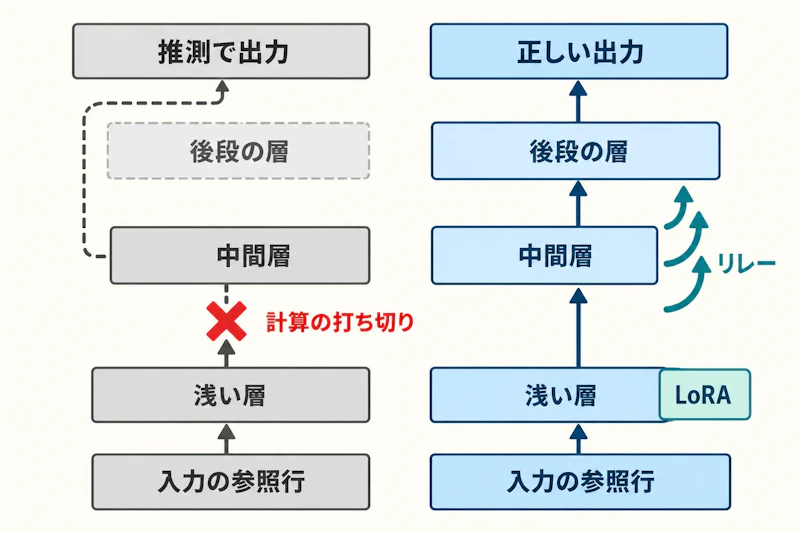
0.6Bから32Bまでの13種類のベースモデルを測ったところ、確実に辿れたのはわずか1.4〜3.6行でした。しかもOLMo-3-32BとOLMo-3-7Bがどちらも約2.6行という結果で、パラメータを増やしても参照を追える深さはほぼ伸びません。それより先の行については、モデルは計算を打ち切って推測に入ってしまいます。
提案手法
著者らの介入は極端に小さいものです。モデルの重みはすべて凍結したまま、比較的浅い層1か所にrank-8のLoRA(低ランクの追加パラメータで振る舞いを調整する手法)を1枚だけ挿します。Qwen3-8Bの場合、追加される重みは65,537個で、全体の0.01%未満にすぎません。
どの層に挿すかは重要で、モデルが計算を打ち切る「カットオフ層」を凍結状態のまま測定して決めます。この測定手順は、学習に使っていない4モデルのうち3モデルで適切な層を当てられており、ある程度の汎用性が確認されています。
また、追加学習の副作用も小さく抑えられています。WikiTextのパープレキシティ(文章予測のしにくさを表す指標)は10.14から10.148へとほぼ変化せず、一般的な言語能力を損なわずに参照追跡だけを伸ばせていました。
リレー機構の正体
興味深いのは、LoRAが答えを直接計算しているわけではない点です。LoRAなしのモデルは、連鎖の識別情報を2〜3行分しか受け渡せずに推測へ移ります。LoRAを挿すと、Qwen3-8Bでは16層から22層あたりの中間層にまたがる「リレー」が立ち上がります。
各行が自分の属する連鎖の情報を1段ずつ上流へ伸ばし、凍結されたままのAttentionヘッドがそれを受けてより遠くの行を読みにいきます。最終的に後段の層が答えをコピーして出力します。Ablation(一部機能を取り除いて寄与を調べる実験)では、親となる行を追いかける特定のヘッドがリレーの維持に効いていることも示されました。つまり必要な部品は事前学習の時点で揃っており、LoRAはそれを連結する起点を与えているだけだと解釈できます。
図1に示すように、介入前と介入後では、同じ凍結済みの層が使われ方だけを変えている点が本研究の核心です。
実験結果
主要な結果を整理すると、小さな介入が大きな差を生んでいることがわかります。
設定 | 介入前 | 介入後 |
|---|---|---|
Qwen3-8B、24行連鎖の完全一致 | 15.5% | 99% |
Qwen3-8B、架空事実の連鎖(完全一致) | 41.2% | 97.4% |
ベースモデル13種が辿れる行数 | 1.4〜3.6行 | Qwen3-8Bで50行まで |
Ouro-1.4B(ループ型) | 数行程度 | 8ループで160行以上 |
学習を長く回したQwen3-8Bは50行の連鎖まで到達しました。さらに、同じブロックを繰り返し通すループ型のOuro-1.4Bでは、4ループで60行、8ループで160行以上を辿れるようになっています。層の反復回数と辿れる深さが素直に対応しており、推論の深さを層の反復で稼ぐ設計と相性がよいことを示す結果です。同じ発想でブロック反復を活用した例として、画像生成ではLooped-DiTが小さなモデルで大規模モデルを上回る結果を報告しています。
人工的な課題だけでなく、複数の文書を跨いで答えを組み立てるマルチホップQAベンチマークMuSiQueでも改善が見られました。浅い層に挿したLoRAは複数モデルで9.4〜17.9ポイントの向上をもたらした一方、深い層に挿した場合の効果はごく小さく、介入位置が結果を左右することが裏づけられています。
まとめと今後の展望
この研究が示したのは、長い文脈の参照追跡が苦手な原因が知識や容量の不足ではなく、深さの使い方にあるという見方です。学習済みの機構を繋ぎ直すだけで性能が一桁変わるのであれば、事前学習の目的関数が深い逐次処理を十分に促していない可能性を疑うべきでしょう。コードとインタラクティブなデモが公開されており、小規模なGPUでも追試できる点も実務的に扱いやすい部分です。
一方で課題も残ります。どの層に挿すべきかはモデルごとに事前測定が必要で、万能な設定は示されていません。評価の中心が参照連鎖という構造の明確な課題であるため、他の種類の推論にどこまで波及するかは未知です。推論時の計算コストや、課題別に学習したLoRAを実運用でどう切り替えるかについても、論文は踏み込んでいません。それでも、巨大化以外の方向で深い推論を引き出す手がかりとして読む価値のある報告です。
論文情報: "Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It"(Zehao Jin, Ruixuan Deng, Junran Wang, 2026) arXiv:2609.36585, CC BY 4.0


