 AI-Papers
- 拡散言語モデルの並列デコードでは各トークンが独立にサンプリングされ、同時に確定するトークン間の統計的な依存関係が壊れるという構造的な制約がある
- HC-DLMは連続的な潜在状態を生成の主状態に据え、各ステップでトークンを読み出して次の潜在更新の足場として戻す単一の降ノイズ過程を提案
- 同じモデルサイズでの比較で、Sudokuの難問分割72.41%、Countdown(CD5)37.52%、LM1Bの生成パープレキシティ75.5を記録
研究の背景
言語生成の主流は、左から右へ1トークンずつ予測する自己回帰モデルです。これに対して拡散言語モデル(Diffusion Language Model、ノイズを徐々に取り除くことで文章を生成するモデル)は、複数のトークンを同時に確定できるため、並列デコードによる高速化や双方向の推論が期待されてきました。
ところが、離散トークンを直接扱う拡散モデルには設計上の弱点があります。複数のトークンを同時に確定するとき、モデルはそれぞれのトークンを自分の周辺分布(他のトークンの値を考えない、個別の確率分布)から独立に引いてしまいます。
その結果、同じステップで決まるトークンどうしの統計的な依存関係が切れてしまいます。論文はこれを離散拡散の「構造的ボトルネック」と呼んでいます。数独のように複数のマスが互いに制約し合う問題では、この独立サンプリングが致命的に効いてきます。
一方、埋め込み空間で連続的に降ノイズする連続拡散モデルは、状態が連続なので依存関係を保ちやすい反面、トークンレベルの手がかりが弱く、言語としての確定性に欠けるという課題を抱えていました。HC-DLM(Hierarchical Continuous Diffusion Language Model)はこの2つの系統を、後付けの併用ではなく1つの生成過程として組み直そうとした研究です。
提案手法
HC-DLMの中心にあるのは、連続潜在を唯一の持続的な生成状態として扱うという設計です。従来の離散と連続のハイブリッド手法(CADDやCCDDなど)は、離散トークンのチェーンを主役に置き、そこに連続的な文脈表現を付随させる形を取っていました。HC-DLMは逆で、時間を通して持続するのは連続潜在のほうであり、トークンはその潜在から各ステップで読み出される中間的な出力という位置づけになります。
逆拡散の1ステップは2段構えです。まず現在の潜在状態からトークンを読み出し、次にそのトークンを条件として潜在状態を1段ぶん更新します。読み出されたトークンは捨てられるのではなく、次の潜在更新を導く「足場」として戻されるため、離散的な確定とその確定を踏まえた連続的な再編成が交互に進みます。
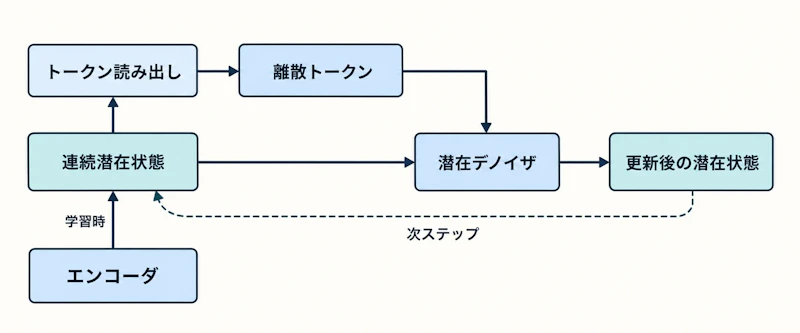
図1のように、モデルは3つの部品を端から端まで同時に学習します。潜在から単語列を取り出すトークン読み出し、トークンを条件に潜在を進める潜在デノイザ、そして学習時にクリーンなトークン列を潜在へ写すエンコーダです。
この3つは別々の損失を寄せ集めたものではなく、トークン尤度に対する1つの変分下界(対数尤度を下から押し上げる形の学習目標)から導かれています。下界を分解すると、再構成の項、潜在軌跡を学ぶflow matchingの項、エンコーダの表現が潰れないよう抑えるエントロピー項に分かれます。トークンの読み出しと潜在の更新が同じ目的関数のもとで整合するため、2つの過程を別々に調整する必要がない点が設計上の利点です。
実験結果
評価は、制約充足の難しさが効くSudoku、数の組み合わせで目標値を作るCountdown、そして一般的な言語モデリングのLM1Bという3種類で行われました。比較対象は離散拡散のMDMやLLaDA、連続拡散のDiffusion-LMやPlaid、ハイブリッドのCADDやCCDD、さらに自己回帰モデルで、いずれもモデルサイズを揃えた条件です。
タスク | 指標 | HC-DLM | 比較手法 |
|---|---|---|---|
Sudoku(難問分割、6M) | 正解率 | 72.41% | CCDD 70.73% / MDM 49.88% |
Countdown(CD5、6M) | 正解率 | 37.52% | CCDD 25.35% / MDM 21.4% |
LM1B(118M) | 生成パープレキシティ | 75.5 | Plaid 77.3 / LangFlow 92.2 |
伸び幅が大きいのはCountdownです。離散拡散のMDMが21.4%、ハイブリッドのCCDDが25.35%にとどまるのに対し、HC-DLMは37.52%に達しています。複数の数とその演算順序が互いに依存する問題で、独立サンプリングによる依存関係の崩れがどれだけ精度を削っていたかが読み取れる結果です。
Sudokuでも最も強い既存手法であるCCDDを上回りましたが、差は2ポイントに届かず、Countdownほど劇的ではありません。LM1Bの生成パープレキシティ(生成文の自然さを測る指標で、低いほど良い)は75.5で、連続拡散のPlaidの77.3をやや下回る水準です。一般的な言語モデリングでは改善幅が小さく、HC-DLMの強みは制約の絡み合った構造的な生成に出やすいと見るのが妥当でしょう。
まとめと今後の展望
HC-DLMは、並列デコードでトークン依存が壊れるという拡散言語モデルの弱点に対して、連続潜在を主状態に据えるという明快な解き方を示しました。トークンの読み出しと潜在更新を1つの変分下界に収めた点は、ハイブリッド手法が抱えがちな「2つの過程をどう噛み合わせるか」という設計の曖昧さを減らしています。関連して、反復的な潜在更新で小さなモデルの表現力を引き出す方向はLooped-DiTのような画像生成の研究とも通じるところがあります。
一方で課題も残ります。検証に使われたのはSudokuとCountdownでは6M、LM1Bでも118Mという小規模なモデルで、現在の大規模言語モデルの水準まで素直にスケールするかは未検証です。各ステップでトークン読み出しと潜在更新の2つを走らせるため計算量の増加も避けられず、並列デコードの速度上の利点をどこまで保てるかは今後の検証課題でしょう。プロジェクトページで手法の詳細が公開されており、追試の足がかりは用意されています。
論文情報: "Hierarchical Continuous Diffusion Language Models"(Hui Ren et al., 2026) arXiv:2610.02193, CC BY 4.0


