 AI-Papers
- 解かれたタンパク質構造1件から、答え合わせが機械的にできる空間・位相の問題を数千件自動生成するデータセット FoldingCorpus を構築
- 言語出力による離散的な構造回答と、共有表現から復号する連続的な3D幾何の二系統で後訓練する Fold2Reason を提案
- 10個の推論ベンチマークのマクロ平均が45.09%から48.33%へ3.23ポイント向上し、タンパク質入力なしでも効果が残った
研究の背景
検証可能報酬による強化学習(Reinforcement Learning with Verifiable Rewards、RLVR)は、数学やコードのように「正解が自動で判定できる」領域で大規模言語モデル(LLM)の推論力を押し上げてきました。問題は、その種類の高品質な問題が有限だという点です。人手で作る競技数学やユニットテスト付きのコードは、すでにかなり掘り尽くされつつあります。
そこで Shuangjia Zheng らの研究チーム(arXiv:2609.38879、"Does Learning Protein Folding Generalize to Broader Reasoning?")が目をつけたのが、タンパク質の立体構造です。構造が1つ解かれていれば、「この2残基は8Å以内に接触しているか」「どちらのペアが近いか」「この断片の向きは右手系か」といった問いの正解が、座標から機械的に決まります。1件の構造から数千の検証可能な命題が自動で湧き出すわけです。
この性質を利用して、著者らは「非言語の科学データで訓練すると、言語ベースの汎用推論にも効果が移るのか」という問いを立てました。似た発想として、検証できる構造から訓練データを量産するGraphForge の証拠グラフによるエージェント訓練データ生成もありますが、本研究は題材を実験で解かれた物理的な構造に求めている点が異なります。
FoldingCorpusの作り方
FoldingCorpus は、訓練用1,000件(開発用100件、固定テスト100件)のタンパク質に12種類の決定論的な演算子を当てて作られます。生成された質問応答ペアは14,400件で、答えはすべて1トークンで表せる形に揃えられています(2値が9種、3択が2種、32択が1種)。
演算子は次のような構造的性質を問うものです。
- 接触判定(近距離・中距離・長距離)。残基ペアが8Å以内かを2値で答える
- 距離の順序比較。2つの残基ペアのどちらが近いかを答える
- 断片の向き。端点ベクトルの角度を分類する
- 中心からの近さ、局所座標系の方向、キラリティ(鏡像の区別)の判定
- 複数の距離条件を同時に満たす残基の選択
- 長さや回転半径、二次構造、接触パターンから32択で該当構造を当てる検索課題
いずれも座標から正解が一意に決まるため、人手のラベル付けや外部の採点モデルを必要としません。データの出所が公開構造データベースである点も、量を伸ばしやすい理由になっています。
Fold2Reasonの構造
モデル側の設計は、言語モデル本体を凍結したまま薄い学習可能部分だけを足す方式です。土台には Qwen3.5-9B を使い、rank-16 の LoRA(4,330万パラメータ)と、残基間でメッセージを交換する256次元の共有ワークスペース(390万パラメータ)のみを更新します。
この共有表現から、2つの出力経路が伸びます。ひとつは FoldingCorpus の答えを言語モデル本来の出力ヘッドから書かせる経路、もうひとつは凍結した座標デコーダ(330万パラメータ)に3D幾何を復号させる経路です。デコーダを凍結しておくのは、学習が座標復元という目的に吸収されてしまうのを避け、表現側に構造情報を持たせるための工夫です。幾何側の損失は座標、ペア間距離、接触、距離分布、局所座標系、ねじれ角、回転半径の7項目から構成されます。
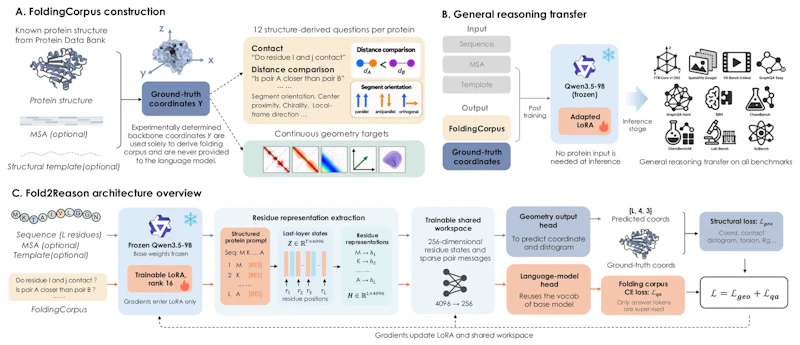
図2の(b)にあるように、推論時にはタンパク質の入力は不要です。訓練で得た表現だけを持ったまま、通常の推論ベンチマークに向かいます。
構造予測の結果
まず本職であるタンパク質側の評価です。334件の単量体構造からなる FoldBench334 で、未調整の Qwen3.5-9B と比べて TM-score、lDDT-Cα、接触F1 のいずれも2.7〜3.5倍のスコアになりました。ただし絶対値は TM-score が約0.17、lDDT-Cα が約0.25 にとどまり、構造予測の専用モデルと張り合える水準ではありません。著者ら自身も、凍結デコーダが測っているのは「表現から構造が読み出せるか」であって正確な全体再構築ではない、と限定しています。
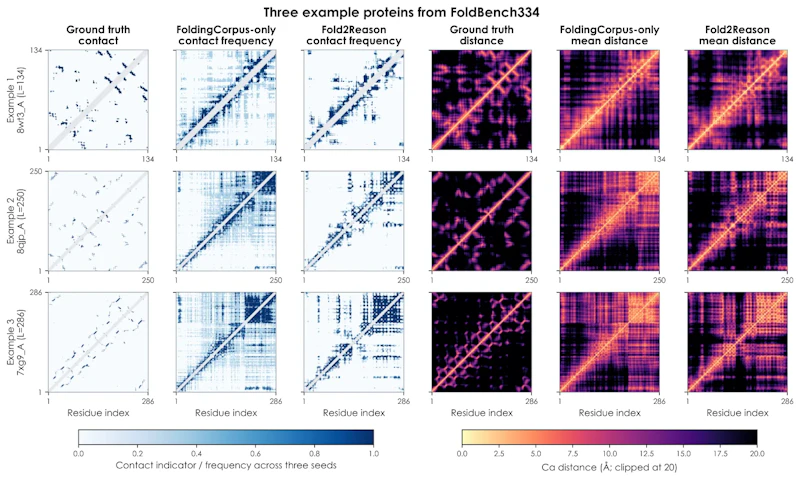
図5の接触マップを見ると、対角線近傍の局所的な接触は捉えられている一方、遠距離の接触は正解ほど鮮明には再現されていません。幾何の教師信号を足した Fold2Reason のほうが、FoldingCorpus のみの条件よりマップの形が正解に近づいています。
汎用推論への転移
本題は転移の方です。空間、グラフ、科学、混合の4カテゴリにまたがる10個のベンチマーク(General-10)で、マクロ平均は45.09%から48.33%へ、3.23ポイント上がりました。10個すべてでプラスという点が、偶然の揺れではないことを支えています。
ベンチマーク | 分類 | ベース | Fold2Reason |
|---|---|---|---|
FTB-Core | 空間 | 36.18% | 40.26% |
SpatialViz | 空間 | 26.61% | 32.71% |
VSI Bench | 空間 | 58.53% | 60.16% |
GraphQA Easy | グラフ | 65.14% | 69.70% |
GraphQA Hard | グラフ | 32.65% | 39.48% |
ChemBench | 科学 | 66.76% | 67.49% |
ChemBench4K | 科学 | 63.56% | 67.93% |
Lab-Bench | 科学 | 37.21% | 37.86% |
SciBench | 科学 | 9.83% | 10.86% |
BBH | 混合 | 54.45% | 56.81% |
マクロ平均 | - | 45.09% | 48.33% |
伸び幅が大きいのは SpatialViz(+6.10ポイント)や GraphQA Hard(+6.83ポイント)で、残基間の位置関係を問う訓練内容と素直に対応します。一方で ChemBench や Lab-Bench は1ポイント未満の改善にとどまり、知識寄りの課題には効きにくい傾向が見えます。
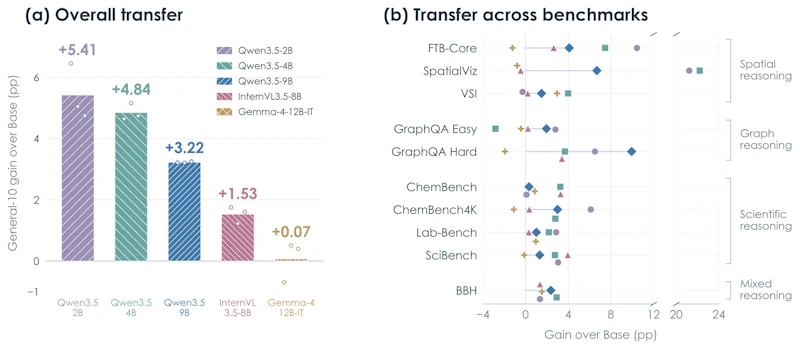
図3はモデルを変えた場合の挙動です。Qwen3.5 系では2Bで+5.41、4Bで+4.84、9Bで+3.22ポイントと、小さいモデルのほうが伸びます。InternVL3.5-8B では+1.53ポイント、Gemma-4-12B-IT ではほぼ横ばい(+0.07ポイント)で、どのアーキテクチャでも同じように効くわけではありません。
効果の出どころの検証
「単に回答形式に慣れただけ」という疑いを潰すため、著者らは条件を揃えた3つの対照実験を行いました。ランダムな点群から内部整合的な答えを作った条件は+0.92ポイント、別のタンパク質のラベルを決定論的にずらして当てた条件は-0.27ポイント、正しい回答コードを写すだけの訓練は-0.09ポイントでした。実データの+3.23ポイントは最良の対照条件の2.3倍以上で、本物の構造に由来する情報が効いていると読めます。
構成要素の切り分けでは、幾何の教師信号を外しても General-10 は48.02%を保ち、全体の伸びのほとんどが離散的な構造回答から来ていました。幾何が足すのは全体で+0.30ポイント程度で、その寄与は FTB-Core など3D寄りの課題に集まります。データ量の検討では、訓練タンパク質2,000件で+3.70ポイントの頂点に達し、4,000件では+3.02ポイントへ下がりました。1タンパク質あたりのラベル数を3から12に増やしても単調には改善せず、効いているのはラベルの密度ではなく構造の多様性だと示唆されます。
まとめと今後の展望
タンパク質構造という非言語のデータから、答えの検証できる問題を大量に自動生成し、それが言語モデルの汎用推論にもある程度移る。この観察は、RLVR の教師データ枯渇に対する供給源の候補を示しています。物理法則や実験で裏づけられた科学データは、原理的にはまだ大量に眠っています。
ただし結論の射程は狭く取るべきです。訓練は1,000件のタンパク質と rank-16 のアダプタ、3シード、General-10 という限られた設定に基づいており、遠縁の相同配列や未知のフォールドに対する一般化は検証されていません。改善が再利用可能な推論能力を獲得したためなのか、事前学習済みの能力を引き出しやすくなっただけなのか、回答形式への適応にすぎないのかは、著者らも未解決としています。より広いベンチマークと大きなコーパス、強いデコーダでの追試が、この主張の強度を決めることになりそうです。
論文情報: "Does Learning Protein Folding Generalize to Broader Reasoning?"(Yong Liu et al., 2026) arXiv:2609.38879, CC BY-SA 4.0
本記事の図(図2、図3、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


