 AI-Papers
- 未確定トークンの難易度に応じて再帰回数を変える拡散言語モデル「ALoDLM」が提案されました
- 計算の配分を潜在変数として扱い、条件付きNELBOで予測と配分を同時に学習します
- 1.7Bと8Bの両規模で11ベンチマーク平均がQwen3を上回り、GSM8Kでは約2.7倍の処理量を記録しました
研究の背景
拡散言語モデル(Diffusion Language Model、DLM)は、文章を左から1語ずつ書き進める自己回帰(Autoregressive、AR)モデルとは違い、穴埋めのように複数のトークンを並列に確定していく生成方式です。1ステップで複数語を決められるため、デコードの速さという点では有利に働きます。
その一方で、同じパラメータ規模のARモデルに品質で届かないという課題が長く残ってきました。拡散言語モデルの設計そのものを見直す研究は増えており、連続的な潜在表現を主役に据えたHC-DLMのような階層型の提案も登場しています。
ALoDLM(Adaptively Looped Diffusion Language Model)の著者らが品質差の原因として挙げたのは、計算量の配り方が一律である点です。従来のDLMは、どのトークンに対してもネットワークを同じ深さだけ1回通して予測を出します。しかし未確定のトークンには、文脈からほぼ自明に決まるものと、周囲が固まるまで判断を保留したい難しいものが混在しています。易しいトークンに過剰な計算を使い、難しいトークンには足りないという状態が起きるわけです。
提案手法
ALoDLMは、各ノイズ除去ステップの内側にトークンごとの潜在再帰(token-adaptive latent recurrence)を持ち込みます。モデルは前段ブロック(Prelude)、繰り返し適用される再帰コア(Recurrent Core)、後段ブロック(Coda)という構成を取り、再帰コアを何回通すかをトークン単位で変えます。
鍵になるのは、確定したトークンと未確定のトークンの扱いを分けることです。もう確定してよいと判断されたトークンは離散的な文脈として書き戻され、以降の推論では通常の入力トークンとして機能します。残った難しいトークンは潜在状態を保持したまま再帰コアを追加で通り、周囲が固まっていく情報を取り込みながら精錬されていきます。
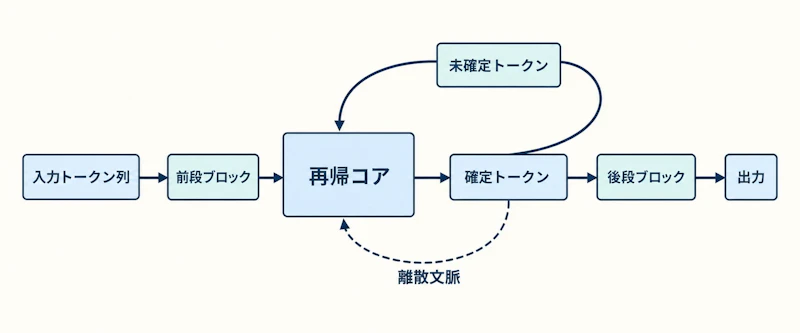
図1のように、確定トークンが文脈側へ抜けていく経路と、未確定トークンが再帰コアへ戻る経路が同じステップ内に共存します。再帰の最大深さは4に設定され、2や8との比較も行われました。
配分も学習する仕組み
難しいトークンを多く回すという発想自体は自然ですが、どのトークンに何回割くかを人手の規則で決めると、学習時の振る舞いと推論時の振る舞いがずれやすくなります。ALoDLMはここを学習の対象に組み込み、トークンごとの計算スケジュールを潜在変数として定式化しました。
そのうえで条件付きのNELBO(negative evidence lower bound、負の変分下限)を導出し、トークンの予測と計算の配分を同じ目的関数のもとで同時に学習します。実装面ではQwen3-1.7BとQwen3-8Bを出発点に、5Bトークン規模のコーパスで教師ありファインチューニングを行っており、継続事前学習の段階を省いた軽量な手順で済んでいる点も実用上の利点です。推論側では再帰の深さを考慮したKVキャッシュを用意し、vLLMでの配信に対応させています。
実験結果
評価はARC-C、ARC-E、MMLU、MMLU-Pro、GSM8K、MATH-500、GPQA-Diamond、MBPP、MBPP+、HumanEval、HumanEval+の11ベンチマークで行われました。平均スコアは次の通りです。
モデル | 11ベンチマーク平均 |
|---|---|
Qwen3 1.7B(AR) | 63.8 |
SDAR 1.7B | 61.0 |
ALoDLM 1.7B | 65.5 |
Qwen3 8B(AR) | 78.5 |
LLaDA 8B | 53.3 |
Dream 7B | 60.5 |
Fast-dLLM-v2 7B | 61.0 |
SDAR 8B | 74.2 |
WeDLM 8B | 75.1 |
ALoDLM 8B | 80.3 |
ALoDLMは両規模で、比較対象のDLMだけでなく土台にしたARモデルの平均スコアも上回りました。8Bでは78.5から80.3へと伸びており、拡散方式が同規模のARに劣るという前提が、計算配分の工夫で覆り得ることを示した結果と言えます。
速度面では、GSM8Kで同等の精度を保ったままvLLMで動かしたQwen3-8Bの約2.7倍の処理量を達成しました。DLM同士の比較でも、精度93.25%を揃えた条件でWeDLMの564.2トークン毎秒に対し612.4トークン毎秒と8.5%上回っています。1トークンあたりの計算量も133.5GFLOPsで、WeDLMの154.6GFLOPsより13.6%少ない水準です。
効率と残る課題
著者ら自身が挙げる限界も明確です。プリフィル時に最大再帰深さの分までKVキャッシュを構築するため、最初のトークンが出るまでの時間(Time to First Token)は同等のARモデルより長くなる場合があります。対話のように初動の応答性が体感を左右する用途では、この点が効いてきます。
もう一つは速度の振れ幅です。計算量が入力の難しさに左右される設計のため、貪欲デコードであってもプロンプトやデータセット、分野によって処理量が大きく変動します。学習データで手薄な分野では再帰の追加が増え並列確定が減るため、最適化されたARモデルに対する速度優位が縮むか、逆転する可能性にも触れられています。品質と効率を同時に改善した手法ではあるものの、得られる恩恵は入力の性質に依存すると理解しておくのが適切です。
まとめと今後の展望
ALoDLMは、拡散言語モデルの品質差を「計算量の一律な配り方」という切り口でとらえ、トークンごとの再帰回数を学習可能な潜在変数として扱った研究です。既存のQwen3から比較的軽い追加学習で構築できる点、vLLMでの配信を前提に設計されている点は、実運用に向けた現実的な配慮と言えるでしょう。
残る焦点は、分野による速度変動をどこまで抑えられるかと、より大きな規模や長文生成でも同じ傾向が続くかという検証です。難易度に応じて計算を配るという考え方自体はARモデルの推論にも通じるため、方式の違いを越えて応用が広がる余地があります。
論文情報: "ALoDLM: Adaptively Looped Diffusion Language Models"(Liancheng Fang et al., 2026) arXiv:2610.04198


