 AI-Papers
- MoE層の出力がルータ重み付き和であることとSAEエンコーダのアフィン性を利用し、各潜在特徴への貢献をエキスパート単位へ厳密に分解する手法
- Qwen3-30B-A3Bの第4/30/46層を分析し、大半の潜在が1〜2個のエキスパートに支配されること、貢献はルータの選択頻度よりはるかに集中していることを確認
- JavaとフロントエンドWeb、幾何と算術・多項式のように、粗いドメインより細かい粒度で分業が生じており、学習済みSAEとコードがByteDance Seedから公開
研究の背景
Mixture-of-Experts(MoE、混合エキスパート)は、多数のサブネットワーク(エキスパート)のうち数個だけをトークンごとに選んで計算する構造です。総パラメータを増やしながら推論コストを抑えられるため、近年の大規模言語モデル(Large Language Model、LLM)で広く使われています。
しかし、個々のエキスパートが実際に何を担っているのかは、はっきりしていませんでした。これまでの分析はドメインラベル付きのコーパスを流し、「どのエキスパートがどのドメインで何回選ばれたか」を集計する方法が主流でした。
著者らはこのやり方に3つの問題があると指摘します。第一に、数学やコードといった分類の枠を分析者が先に決めてしまうため、それより細かい分業は見えません。第二に、粒度が粗く、エキスパート1個の役割を言い当てるには足りません。そして第三に、選ばれた回数は測れても、出力にどれだけ寄与したかは測れていない点です。
提案手法
本研究は、分析の舞台をドメインラベルから特徴空間へ移します。使うのはスパースオートエンコーダ(Sparse AutoEncoder、SAE。内部表現を解釈しやすい少数の特徴へ分解する手法)で、これをMoE層の出力に対して学習させます。
手法の鍵は単純な代数的性質です。MoE層の出力は選ばれたエキスパートの出力をルータの重みで足し合わせたものであり、SAEのエンコーダは線形変換とバイアスからなるアフィン写像です。したがって、ある潜在特徴の活性化前の値(事前活性)は、各エキスパートからの貢献の和として近似なしに分解できます。
この貢献割合をコーパス全体で平均し、しきい値をかけると、エキスパートと潜在特徴を結ぶ二部グラフが得られます。あるエキスパートが主に駆動している潜在特徴の集合(支配集合)が特定できるので、その潜在特徴群が何に反応しているかをLLMで自動解釈させれば、エキスパートの役割を言葉で記述できるという流れです。
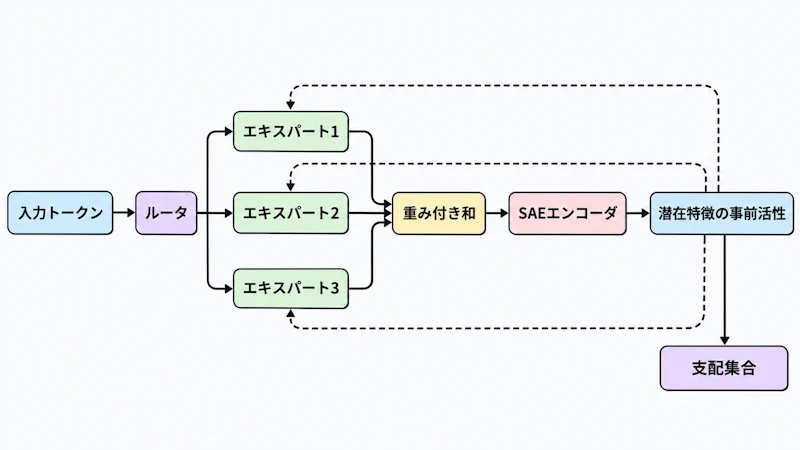
図1のように、順方向では複数のエキスパートの出力が1つにまとまりますが、アフィン性のおかげで逆向きに貢献をたどり直せます。実験に使われた設定は次のとおりです。
項目 | 設定 |
|---|---|
対象モデル | Qwen3-30B-A3B |
分析対象の層 | 第4層、第30層、第46層 |
SAEの種類 | TopK SAE(k = 100) |
潜在特徴数 | 2の20乗(約105万) |
入力次元 | 2048 |
検証コーパス | 約15億トークン(Olmo 3の学習コーパス由来、学習データと分離) |
実験結果
分析の結果、エキスパートの貢献はルータの選択頻度よりもはるかに集中していることが分かりました。つまり、ルータは幅広いトークンに対してあるエキスパートを選んでいても、そのエキスパートが出力に実際に効いている特徴はもっと限られているということです。
大半の潜在特徴は1〜2個のエキスパートによって支配されていました。また、エキスパート同士の支配集合の重なりは全体に散らばるのではなく、少数のエキスパートのペアに集中していました。協調して働く組み合わせが限定的であることを示す結果です。
支配集合の自動解釈では、粗いドメインの内側にさらに細かい分業が見つかりました。たとえばJavaを扱うエキスパートとフロントエンドのWebコードを扱うエキスパートは別であり、数学の中でも幾何を担うものと算術・多項式を担うものが分かれていました。加えて、粗いドメインごとに割り当てられるエキスパートの数は大きく偏っていたと報告されています。従来の選択頻度の集計では、こうした分割は「コード」「数学」という単位に埋もれて観測できませんでした。
まとめと今後の展望
この研究の価値は、MoEの解釈を分析者のラベル設計から切り離した点にあります。特徴空間で貢献を厳密に分解するため、どんな分類軸で専門化しているかをデータ側から読み取れます。エキスパートの冗長性を見てプルーニングを設計したり、ルータの学習が意図どおりの分業を生んでいるか検証したりする用途が考えられます。潜在表現そのものを計算に使うLARCのような研究と合わせて、モデル内部の表現を扱う手法の裾野が広がりつつあります。
一方で、現時点の結果には次のような制約があります。
- 検証は単一モデル(Qwen3-30B-A3B)の3層のみで、他の構成への一般性は未検証
- 結論が学習済みSAEの品質と、潜在特徴群に対するLLMの自動解釈の妥当性に依存する
- 貢献割合をコーパス全体で平均するため、稀な文脈での振る舞いは見えにくい
学習済みSAEと実験コードはByteDance SeedのGitHubリポジトリとHugging Faceで公開されており、第30層については解釈結果のデータも同梱されています。3層の貢献統計を取り直すには80GBのGPUが2枚必要とされているため、追試のハードルは低くありませんが、公開データを使う範囲なら手元で結果を確認できる形になっています。
論文情報: "SAE Interprets MoE: Sparse AutoEncoders Reveal That MoE Experts Exhibit Human-Interpretable Fine-Grained Specialization"(Anyuan Zhuo et al., 2026) arXiv:2611.08089, CC BY-SA 4.0


