 AI-Papers
- トークンごとに大小のモデルを切り替える「トークン単位ルーティング」は、単一モデル前提の既存サービング基盤では速度が出ないという課題があった
- TokenRouterはモデルごとに自律したサブサーバを立て、非同期ディスパッチと遅延バッチングでデコードスループットを既存比2.01〜64.15倍に改善
- 遅延バッチングの閾値はマルコフ連鎖に基づく数理モデルから導出でき、実測の最適値と一致したと報告されている
研究の背景
大規模言語モデル(Large Language Model、LLM)の推論コストを抑える方法として、簡単な部分は小さいモデル、難しい部分だけ大きいモデルに任せる「ルーティング」が研究されています。振り分けの粒度にはセッション単位、リクエスト単位、そしてトークン単位があり、生成する1トークンごとに担当モデルを選ぶトークン単位ルーティングが、品質とコストのバランスを最も細かく制御できます。
ところが、実際にこれを動かそうとすると壁にぶつかります。SGLang や vLLM といった既存の推論サービングシステムは、1つのモデルがバッチ内の全リクエストを同じテンポで進める前提で作られているためです。
論文はここで2つの問題を指摘しています。1つはステップ非同期で、モデルごとに1ステップあたりの処理時間が大きく違うため、歩調を合わせようとすると全体が最も遅いモデルに引きずられます。もう1つはバッチ投入遅延で、頻繁にモデルを切り替えると、振り分け先のモデルがちょうど処理中であることが多く、リクエストが待たされてバッチが細切れになります。加えて、既存システムはステップごとの振り分けを書き込むインターフェースを備えておらず、研究者が自前で実装する負担も重くなっていました。
提案手法
TokenRouter の設計方針は「リクエスト中心のプログラミング、モデル中心の実行」と表現されています。開発者はルーティングのロジックを1本のリクエストの視点で記述し、実際の並列実行はランタイムが引き受ける、という役割分担です。
開発者が書くのは3つの関数だけです。route は各デコードステップの後に次の宛先モデルを決め、send は相手モデルへ渡すメッセージを組み立て、receive は受け取ったメッセージをローカルのリクエストへ戻します。この抽象化によって、CITER や R2R など既存のルーティングアルゴリズムを短い記述で載せ替えられます。
実行側では、協調する各 LLM が自律的なサブサーバとしてホストされます。サブサーバはそれぞれ独自のスケジューラ、実行ランナー、KV キャッシュプールを持ち、クライアント対応ループ、デコードループ、モデル間通信ループという3つの切り離されたループを回します。外部にはサーバインターフェースが単一のエンドポイントを公開するため、通常の単一モデルサーバの差し替えとして使えます。
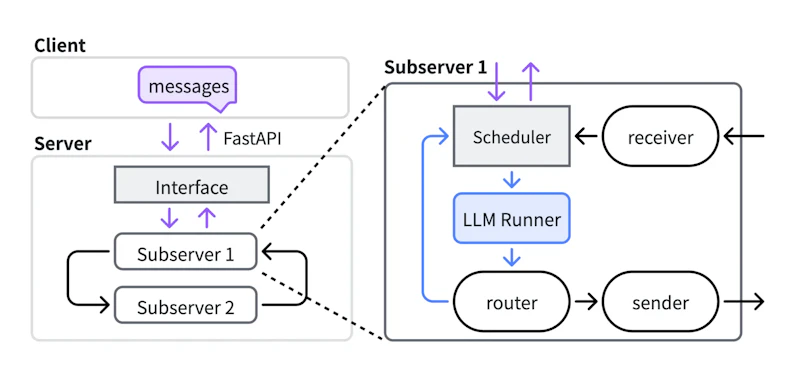
図1の右側に示されているように、サブサーバ間はリクエストを非同期に受け渡します。モデルを切り替えたリクエストは一度「保留」状態に入り、プレフィックス照合や KV キャッシュの再割り当てを飛ばす仕組み(handoff-resume)が用意されているため、切り替えのコストはトークンを1つ追加する程度に抑えられます。GPU メモリの使い方は複数モデルを同居させる構成になるため、LLMのVRAM必要量とは?計算式と推論・学習別のGPU選び方を解説で扱ったような容量見積もりが設計時に効いてきます。
遅延バッチングと数理モデル
バッチ投入遅延への対策が遅延バッチングです。サブサーバは到着したリクエストを即座に処理せず、バッファが閾値 B に達してから実行します。短い待ち時間を払う代わりに、同じモデルでまとめて処理できるバッチを大きくする狙いがあります。
問題は閾値の決め方です。論文はルーティング過程を離散時間マルコフ連鎖として定式化し、スループットを B の関数として導出したうえで、デッドロックを避ける実行可能条件のもとで最適値を探索します。送信までのトークン数が幾何分布に従うという仮定を置いた近似ですが、R2R では検証したすべての同時実行数において予測した最適閾値が実測の最適値と一致したと報告されています。
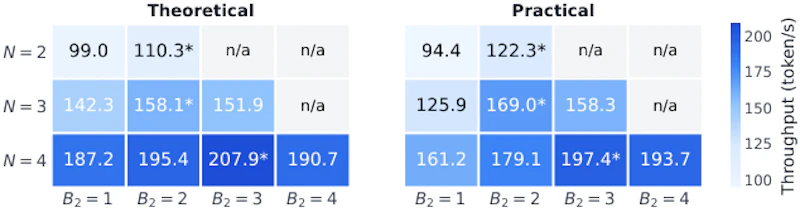
図2は、小さいモデル側の閾値を1に固定し、大きいモデル側の閾値を変化させたときの予測と実測を並べたものです。アスタリスクが各条件での最高スループットを示しており、予測曲線が実測の山をとらえています。
実験結果
評価は 8枚の A100 80GB を搭載したサーバで行われ、小さいモデルを1枚、大きいモデルをテンソル並列で2枚に載せ、CUDA MPS で GPU を共有する構成が使われています。対象アルゴリズムは CITER、R2R、R-Stitch、Co-LLM、ME の5種類で、モデルペアは主に Qwen3-0.6B と Qwen3-32B の組み合わせです。ワークロードは出力2,048トークンまでの軽い推論(AIME)、8,192トークンまでの重い推論、そして SWE-Smith によるエージェントタスクの3系統です。
比較対象は、各アルゴリズムの公式実装と、SGLang 上に構築した標準サービング(Std. Serving)です。主な結果は次のとおりです。
比較条件 | 改善幅 |
|---|---|
デコードスループット(15のアルゴリズム・ワークロード組合せ、強いベースライン比) | 2.01〜64.15倍 |
レイテンシ(Std. Serving 比) | 2.03〜63.64倍の短縮 |
公式実装比のレイテンシ・スループット(同時実行数4、原論文設定) | 2.78〜21.61倍短縮/2.73〜21.97倍向上 |
モデルペアを変えたときの R2R 比スループット | 1.99〜3.21倍 |
同時実行数8でのR2R公式実装比 | 2.76倍 |
ユーザーごとの生成速度に関する SLO(サービス品質目標)を厳しく設定した条件でも、同時実行数16で、同時実行数1の R2R 公式実装の18.58倍のスループットに達したとされています。改善幅の上限値が64倍台まで伸びているのは、既存システムがトークン単位ルーティングで極端に性能を落とす条件が含まれるためで、どの構成でも一律に数十倍速くなるわけではない点は読み取っておく必要があります。
まとめと今後の展望
TokenRouter は、新しいルーティングアルゴリズムを提案する研究ではなく、既存のアルゴリズムを実用的な速度で動かすための実行基盤を整えた研究です。研究コードでは同時実行数を上げると性能が崩れていたトークン単位ルーティングが、サービングシステム側の設計変更だけで実運用に近い領域まで引き上げられることを示しています。
課題として著者自身が挙げているのは、スループットモデルが置く幾何分布の仮定です。送信間隔の分布がこの形から外れるケースでは予測がずれる可能性があり、今後の検討課題とされています。また評価は A100 8枚の1ノード構成と Qwen3 系を中心としたモデルペアに限られており、異種ハードウェアや3モデル以上の協調、マルチノード環境での挙動は今回の報告範囲には含まれていません。コードは GitHub で公開されており、NeurIPS 2026 に採択されています。
論文情報: "TokenRouter: Efficient Serving System for Token-Level LLM Routing"(Tianyu Fu et al., 2026) arXiv:2610.12242, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


