 AI-Papers
- Delta-Rule線形アテンションの再帰状態を低ビット化する学習後量子化手法STEPQuantを提案
- 誤差の影響が「記憶の寿命」と「状態内の位置」で決まることを分析し、ビット割り当てとスケール推定に反映
- Qwen3.8-27Bで4bit化しても長文生成の平均精度80.51%を維持し、一律INT4の12.73%から大幅改善
研究の背景
Transformerの標準的なアテンションは、生成したトークンの数に比例してKVキャッシュ(過去の鍵と値を保持するメモリ)が膨らみます。これに対して線形アテンションは、過去の情報を固定サイズの再帰状態(行列の形で持つ圧縮された記憶)に畳み込むため、文脈長が伸びてもメモリが増えません。Qwen3.8-27BのGated DeltaNetやKimi-Linear-48B-A3B-InstructのKimi Delta Attention(KDA)は、この方式を採用した代表例です。
ところが実際のサービングでは、固定サイズでも問題が残ります。バッチサイズを大きくして同時に多数のリクエストを処理すると、リクエストごとに1つずつ再帰状態を抱えることになり、全体では数百GiB規模のメモリを占めるようになります。論文の計測では、Qwenを重み4bitでバッチサイズ512で動かした場合、総メモリ419.73GiBのうち大部分が状態に由来していました。
そこで状態そのものを低ビットに丸めたくなりますが、ここが難所です。KVキャッシュは一度書き込んだら読み出すだけですが、再帰状態は毎ステップ更新され続けるため、一度入った量子化誤差が後続の更新を通じて伝播し増幅します。実際、一律INT4では長文生成タスクの平均精度が12.73%まで崩壊し、INT6でも45.04%にとどまりました。
誤差が効く時と場所
著者らの出発点は、すべての誤差が等価ではないという観察です。時間軸(temporal)では、忘却ゲートの減衰が緩やかな長寿命のユニットに入った誤差が、多数のデコードステップにわたって残り続けます。Qwenの全2,304ヘッドのうち、半減期が最も長い4分の1がINT6誤差全体の52.5%を占め、KDAでは78.8%に達しました。
空間軸(spatial)では、状態行列内の位置によって出力への効き方が変わります。図2に示すように、鍵の行を出力への影響度で8群に分けると、影響度の高い群だけをINT4にしたときのパープレキシティ悪化が大きくなります。さらに状態行列には、鍵の行方向と値の列方向の両方に、中央値の数十倍という外れ値が現れ、それが2048ステップのデコードを通じて消えずに残ります。
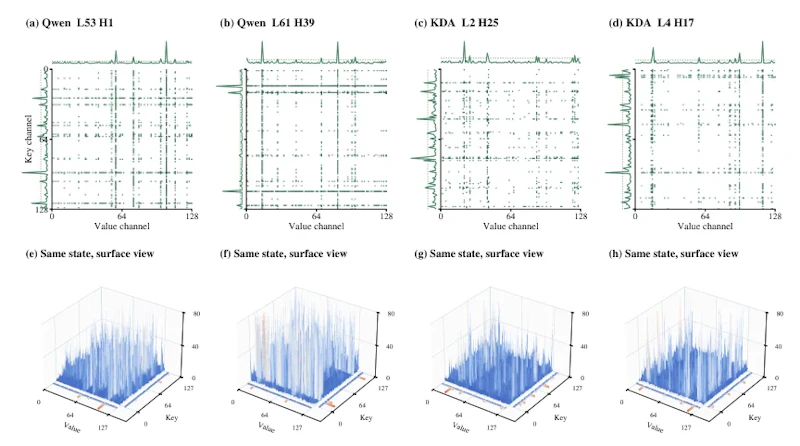
つまり、ビット数を一律に削るのではなく、誤差が長く残る場所と出力に強く効く場所を見極めて精度を配分すればよい、という設計方針が導かれます。
STEPQuantの仕組み
STEPQuantは、この2軸の知見をそのまま2つの機構に落とし込んだ学習後量子化(追加学習なしの量子化)フレームワークです。Lifetime-aware Bit Allocationは、割り当て単位をQwenではヘッド全体、KDAでは鍵の行に取り、各単位の再構成誤差を、平均対数ゲート保持率から導いた寿命の重みで補正します。その重み付き誤差が平均ビット予算のもとで最小になるようビット数を決め、最も危険な少数の単位はFP16のまま据え置く構成です。
もう一方のKey-Row-Aware Dual-axis Fittingは、状態の各要素を「行のスケール×列のスケール×整数コード」として表現します。行スケールは平均的な大きさと出力誤差への影響度から定め、列スケールは影響度で重み付けした再構成誤差を最小化して推定します。行だけ、あるいは列だけを見る従来のスケール設計では、双方向に外れ値を持つ状態行列をうまく表現できません。
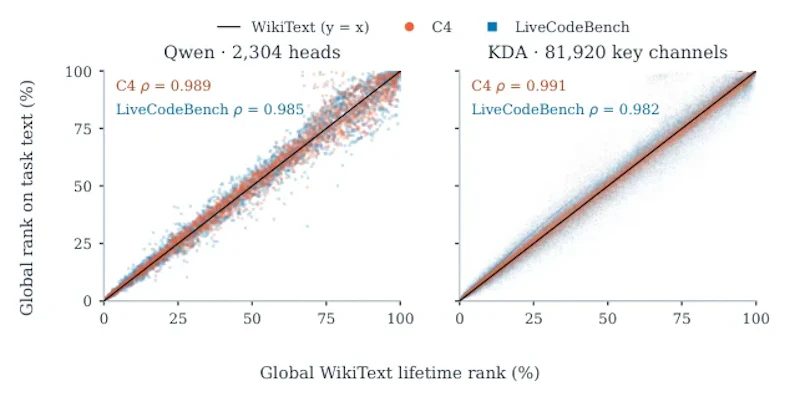
ビット割り当てはオフラインのキャリブレーションで一度決め、リクエストごとに変えません。この前提が成立するかは、寿命の順位が入力テキストに依存しないかにかかります。図4は、WikiTextで求めた寿命の順位がC4やLiveCodeBenchでもほぼ保たれることを示しており、オフライン固定の妥当性を支える根拠になっています。
実験結果
評価はQwen3.8-27BとKimi-Linear-48B-A3B-Instructの2モデルで行われました。長文生成タスクはLiveCodeBench v6、EvalPlus、AIME 26、MATH-500、HMMT、GPQA-D、IFBenchの7つ、短文生成タスクは6つで、いずれも重みはBF16のままで状態の精度だけを変えています。
状態の精度 | Qwen 長文 | Kimi 長文 | Qwen 短文 | Kimi 短文 |
|---|---|---|---|---|
FP32 | 80.60 | 61.52 | 87.78 | 68.36 |
一律INT8 | 71.86 | 56.02 | 86.25 | 67.80 |
一律INT4 | 12.73 | 21.63 | 65.74 | 42.24 |
STEPQuant 6bit | 80.59 | 61.47 | 87.54 | 68.82 |
STEPQuant 4bit | 80.51 | 58.52 | 87.63 | 68.11 |
6bit設定はほぼFP32と同等で、4bit設定でも一律INT8を上回ります。ただしKimiの長文生成では4bitで61.52%から58.52%へ3ポイント下がっており、モデルによって4bitの余裕が異なることも読み取れます。構成要素の切り分け実験では、空間側の適合だけで73.95、時間側の割り当てだけでは12.87にとどまり、両者を組み合わせて84.72に達しました。時間軸の配分は単独では機能せず、空間側のスケール設計と噛み合って初めて効く関係です。
システム面の効果はSGLang 0.5.12への統合とA800 GPUでの計測で示されています。Qwenでは再帰状態のメモリが80.1%減(5.03倍の圧縮)、状態更新の時間も65.6%減(2.91倍高速)となり、重み4bit・バッチ512の構成では総サービングメモリが419.73GiBから131.18GiBへ、68.7%削減されました。Kimiでは状態圧縮5.08倍、総メモリ削減53.7%です。量子化を推論側ではなく学習側のコスト削減に使う試みとしてはTRACEとは?FP4量子化でMoEのRL学習を最大5.4倍速くする新手法もあり、低精度化の適用先が広がってきています。
まとめと今後の展望
再帰状態の量子化は、KVキャッシュ量子化とは誤差の振る舞いが異なる別の問題であり、STEPQuantは「いつ」「どこで」誤差が効くかを定量化して精度配分に使うという筋の通った解き方を示しました。固定サイズの状態がボトルネックになる大バッチ運用で、実装レベルの利得まで確認できている点は実務的な価値があります。
一方で著者らは限界も明示しています。寿命の重みはゲート減衰による近似であり、鍵に依存して時間変化する状態遷移を完全に表せていないため、量子化誤差の長期的な影響を取り切れていません。評価も2つのGated DeltaNet系・KDA系モデルと固定のハードウェア・ワークロードに限られ、他のアーキテクチャや負荷が変動する実運用環境での効果は未検証とされています。線形アテンション系モデルが増えるほど、こうした状態側の圧縮技術の重要性は増していくでしょう。
論文情報: "STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization"(Bingchen Yao et al., 2026) arXiv:2609.38169
本記事の図(図2、図4)は解説のため上記論文より引用しています。


