 AI-Papers
- 推論のVRAMは「パラメータ数×1パラメータあたりのバイト数+KVキャッシュ」で見積もれる
- 混合精度の学習では重み6バイト、オプティマイザ8バイト、勾配4バイトで合計18バイト/パラメータが必要になる
- 24GBから141GBまでの容量クラスごとに動かせるモデルの上限と、クラウド借用との損益分岐の考え方を整理する
VRAMは何に消えるのか
ローカルでLLM(Large Language Model: 大規模言語モデル)を動かそうとしたとき、最初にぶつかる壁がGPUメモリ(VRAM)の不足です。「7Bモデルなら24GBで足りる」といった断片的な情報は大量に流れていますが、文脈長を伸ばした途端にメモリ不足で落ちたり、同じモデルサイズなのに学習だと動かなかったりします。
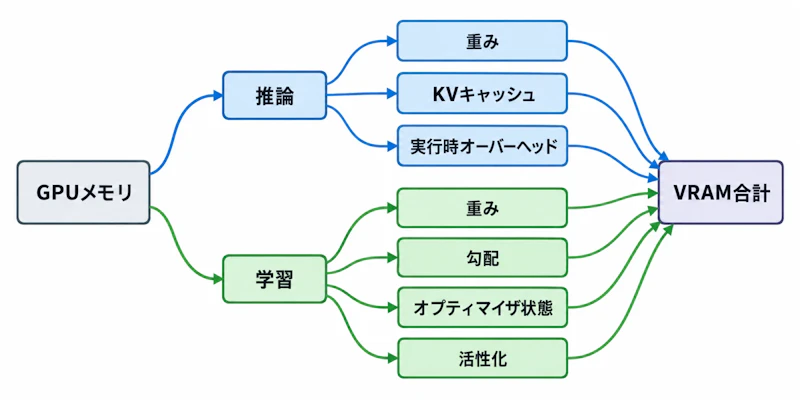
原因は、VRAMを消費する要素が1つではないことです。Hugging Faceの公式ドキュメント「Model memory anatomy」は、GPUメモリの中身を保存されるテンソルと演算の2つに分けて整理しています。保存されるテンソルの内訳は次の5つです。
- モデルの重み(パラメータそのもの)
- オプティマイザ状態(Adamのモーメンタムと分散)
- 勾配(逆伝播で各パラメータ分だけ生成される)
- 活性化(順伝播の中間結果を逆伝播のためにキャッシュする)
- 一時テンソル(softmaxや行列積が瞬間的に確保する領域)
推論ではこのうち重みと一時テンソル、そしてKVキャッシュだけが問題になります。学習ではすべてが乗ってきます。この違いが、同じモデルでも推論と学習で必要VRAMが1桁変わる理由です。
推論のVRAM計算式
重みのサイズ
重みの消費量は単純な掛け算で出ます。パラメータ数に、1パラメータあたりのバイト数を掛けるだけです。BF16やFP16なら2バイト、FP8やINT8なら1バイト、INT4なら0.5バイトです。
つまり8Bモデルは、BF16で約16GB、FP8で約8GB、INT4で約4GBになります。Hugging FaceのLlama 3.1解説記事が示している数値とも一致します。70Bなら140GB、405Bなら810GBです。70BのBF16推論が家庭用GPU1枚で成立しないのは、この掛け算の結果です。
KVキャッシュのサイズ
見落とされやすいのがKVキャッシュです。自己回帰生成では1トークンずつ予測するため、過去のキーとバリューを保存して再計算を避けます。このキャッシュは文脈長とバッチサイズに比例して線形に増えます。計算式は次の形です。
KVキャッシュ(バイト) = 2 × 層数 × KVヘッド数 × ヘッド次元 × 精度のバイト数 × 文脈長 × バッチサイズ先頭の2はキーとバリューの2つ分です。Llama 3.1 8B(32層、KVヘッド8、ヘッド次元128)をFP16で計算すると、1トークンあたり約128KiBになります。1,000トークンで約0.125GB、128,000トークンでは約15.6GBです。重みが4GBのINT4モデルでも、長文脈にすればKVキャッシュのほうが大きくなります。
ここで効いてくるのがGQA(Grouped Query Attention)です。クエリヘッド32に対しKVヘッドを8に減らす設計なら、KVキャッシュはそのまま4分の1になります。古いMHA(Multi-Head Attention)構成のモデル、たとえばKVヘッドが32のままの7Bモデルでは1トークン0.5MiBを消費し、4,000トークンでも2GBに達します。モデル選びの段階でKVヘッド数を確認する価値は十分あります。
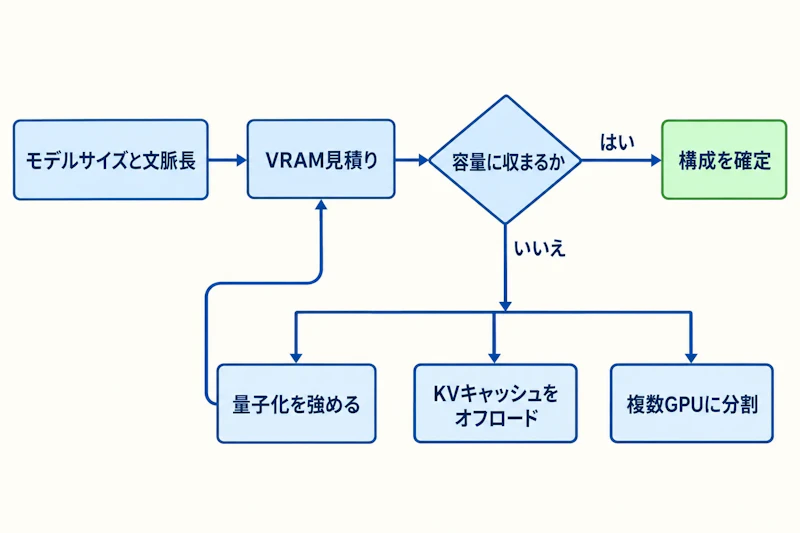
キャッシュが収まらない場合の逃げ道も用意されています。Transformersは`cache_implementation="offloaded"`で現在処理中の層以外のキャッシュをCPUへ退避でき、`"quantized"`でキャッシュ自体をint4やint2に量子化できます。どちらも速度を多少犠牲にする代わりにメモリを稼ぐ手段です。再帰状態の量子化を扱ったSTEPQuantとは?線形アテンションの再帰状態を4bit量子化しメモリ68.7%削減のように、状態側を圧縮する研究も進んでいます。
実行時オーバーヘッド
重みとKVキャッシュを足しただけでは足りません。CUDAカーネルやCUDAグラフの予約領域、一時テンソルのピーク、推論エンジンのバッファが乗ります。実務では合計に1.1倍から1.2倍を掛けておくと安全です。vLLMのように`gpu_memory_utilization`で事前確保する仕組みの場合は、その割合も考慮に入れます。
学習のVRAM計算式
学習側はもっと厳しくなります。混合精度学習では重みのコピーが2つ必要で、順伝播と逆伝播用のFP16が2バイト、安定した更新のためのFP32マスターコピーが4バイト、合計6バイト/パラメータです。
そこにAdamのオプティマイザ状態がFP32のモーメンタムと分散で8バイト、勾配がFP32で4バイト加わります。足すと18バイト/パラメータです。1Bモデルで18GB、7Bモデルなら126GBが活性化を数える前の下限になります。
活性化はバッチサイズ、文脈長、層数、隠れ層サイズの積で増えるため、固定値では表せません。Hugging Faceのドキュメントは、4Bパラメータのモデルをバッチサイズ16で混合精度学習すると約85GBのVRAMを要すると記しています。18バイト換算の72GBに、活性化分が十数GB上積みされた計算です。
削減の手段と効果
18バイトという数字は固定ではなく、削る方法がいくつもあります。
- 8bit Adam(bitsandbytes)でオプティマイザ状態を8バイトから2バイトへ圧縮する
- 勾配チェックポインティングで活性化の保存を一部に絞り、残りは再計算する
- 勾配累積でバッチサイズを小さく保ち、実効バッチだけ大きくする
- LoRAで学習対象をアダプタに限定し、オプティマイザ状態と勾配をその分だけにする
最も効果が大きいのはQLoRAです。ベースモデルを4bit(nf4)で読み込み、LoRAアダプタのみを学習する構成により、Hugging Face PEFTのドキュメントは65Bモデルを48GBのGPU1枚でファインチューニングできると説明しています。フル学習なら1TB超が必要な規模です。
量子化でどこまで減る?
重みの精度別に必要VRAMを整理すると、選べる構成が見えてきます。以下はKVキャッシュとオーバーヘッドを含まない、重みだけの概算です。
パラメータ数 | BF16(2バイト) | FP8/INT8(1バイト) | INT4(0.5バイト) |
|---|---|---|---|
8B | 16GB | 8GB | 4GB |
14B | 28GB | 14GB | 7GB |
32B | 64GB | 32GB | 16GB |
70B | 140GB | 70GB | 35GB |
405B | 810GB | 405GB | 203GB |
MoE(Mixture of Experts)モデルでは話が変わります。VRAMを決めるのは総パラメータ数で、速度を決めるのは活性パラメータ数です。総1兆パラメータでも活性が数十Bというモデルは、推論速度は軽いのにメモリ要求は巨大になります。「活性パラメータが少ないから軽い」という説明をVRAMの話と混同しないよう注意が必要です。
容量クラス別のGPU適性
計算式が分かれば、容量クラスごとの現実的な上限が決まります。
容量 | 代表的な製品クラス | 推論の目安 | 学習の目安 |
|---|---|---|---|
24GB | RTX 3090 / RTX 4090 | BF16で8B、INT4で32B(短め文脈) | 7BクラスのQLoRA |
32GB | RTX 5090 | BF16で14B、INT4で32Bに文脈の余裕 | 13BクラスのQLoRA |
48GB | RTX 6000 Ada / L40S | INT4で70B、INT8で32B | 65BクラスのQLoRAが成立 |
80GB | A100 80GB / H100 | INT8で70B、BF16で32B | 7Bクラスのフル学習 |
96GB | RTX PRO 6000 Blackwell | INT8で70Bに長文脈の余裕 | 13Bクラスのフル学習に近い |
141GB | H200 | BF16で70Bがほぼ上限、INT8なら長文脈も可 | 多GPU構成の1ノード単位 |
141GBのH200でBF16の70B(140GB)がぎりぎりという点に注目してください。重みが収まっても、KVキャッシュとオーバーヘッドの置き場がありません。実際の運用ではINT8に落とすか、2枚でテンソル並列にします。「重みが入る」は「動く」とイコールではないというのが、容量選びで最も重要な感覚です。
クラウドとの損益分岐点
GPUを買うべきか借りるべきかは、稼働時間で決まります。価格は変動するので、ここでは仮定を明示した試算の手順だけ示します。
仮に48GBクラスのGPUを100万円で購入し、同等容量のクラウドGPUが1時間450円で借りられるとします。単純な割り算で約2,200時間が分岐点です。1日6時間使うなら約1年、1日2時間なら3年かかります。
これに電力費が加わります。消費電力300Wのカードを1日8時間動かすと月約72kWh、1kWh30円なら月2,000円強です。年間2.5万円程度を購入側のコストに足して再計算します。
判断の目安は使い方の形です。短時間の実験を断続的に繰り返すならクラウド、常時稼働の社内推論サーバや機密データを外に出せない用途なら購入が有利になります。学習のように数日連続でGPUを100%使う作業は、容量単価の安いクラウドの大容量インスタンスに寄せたほうが合計は下がりやすいでしょう。
見積りをコードで自動化
毎回手計算するのは面倒なので、関数にしておくと検討が速くなります。モデルの`config.json`から層数とKVヘッド数、ヘッド次元を読めばそのまま使えます。
def vram_gib(params_b, bytes_per_param, layers, kv_heads, head_dim,
             seq_len, batch=1, kv_bytes=2, overhead=1.15):
    weights = params_b * 1e9 * bytes_per_param
    kv = 2 * layers * kv_heads * head_dim * kv_bytes * seq_len * batch
    return (weights + kv) * overhead / 1024 ** 3

# Llama 3.1 8B を INT4、32k 文脈、バッチ1で推論する場合
print(vram_gib(8, 0.5, layers=32, kv_heads=8, head_dim=128, seq_len=32768))
# -> 約 8.9

# 同じモデルを BF16、8k 文脈で推論する場合
print(vram_gib(8, 2, layers=32, kv_heads=8, head_dim=128, seq_len=8192))
# -> 約 18.3
INT4の8Bを32k文脈で動かすと約8.9GiBで、12GBのGPUでも入ります。一方BF16の8Bを8k文脈で動かすと約18.3GiBになり、16GBのカードでは足りません。精度と文脈長のどちらを優先するかで必要な容量クラスが変わることが、数値で確認できます。
よくある見落とし5つ
- GBとGiBの混同。24GBと書かれたGPUの実容量は24GiB(約25.8GB)で、計算式の結果と1割弱ずれる
- OSとディスプレイ出力の消費。Windowsでモニタを繋いでいると1GBから2GB減る
- バッチサイズの影響。KVキャッシュと活性化はバッチに比例するので、同時リクエスト数を決めてから容量を選ぶ
- 埋め込みテーブル。語彙数が大きいモデルでは埋め込みだけで数GBを占める
- ビームサーチ。複数候補を保持するため、ビーム数の分だけKVキャッシュが増える
結局どう選ぶか
手順としては、使いたいモデルのパラメータ数と許容できる精度から重みのサイズを出し、必要な文脈長とバッチサイズからKVキャッシュを足し、1.15倍して余裕を見る、という順番になります。この3ステップで出た数字より上の容量クラスを選べば、メモリ不足で手戻りすることはほぼありません。
迷ったときは精度より容量を優先するのが実務的です。量子化で精度を落とすのは後からいつでもできますが、GPUの容量は買い替えないと増えません。文脈長を伸ばす予定があるなら、重みのサイズの2倍程度をKVキャッシュの余地として確保しておくと、長文要約やコード生成のような用途でも組み直さずに済みます。


