 AI-Papers
- 失敗軌跡を含む未ラベルデータで逆ダイナミクス学習を行い、少量の専門家デモのみで言語接地する2段階フレームワーク「TAP」をICML 2026で発表
- SIMPLERベンチマークで標準的な行動模倣学習比+10%の成功率向上を達成し、100万件超の専門家軌跡と同等の性能を少量データで実現
- 実機カメラ角度変化でベースラインが成功率0%に崩壊する状況でも、TAPは25%の成功率を維持して環境変化への高い頑健性を実証
研究の背景
VLA(Vision-Language-Action)モデルは、カメラ映像と自然言語の指示を受け取り、ロボットアームなどの具体的な動作として出力するモデルです。近年のロボット研究で急速に注目を集めていますが、実用化に向けて大きな壁があります。学習に必要な「専門家デモンストレーション」、つまり人間が正しい操作手順を実演したデータの収集コストが非常に高い点です。
失敗した動作軌跡や、ロボットが自由に動き回る「自由遊び」のデータは、タスクのラベルが付けられないため従来の学習には使えませんでした。この課題に対し、Junhao Shi、Xipeng Qiu ら復旦大学のチームは、ICML 2026 に採択された論文で「TAP(Task-Agnostic Pretraining)」というフレームワークを提案しました。
TAPの核心アイデア
TAPの着想は「運動スキルの習得」と「言語理解の習得」は本来別々に学べるはずだという仮説にあります。人間の赤ちゃんが言葉を覚える前に体の動かし方を習得するように、ロボットも「何をすべきか」を理解する前に「どう動くか」を先に身につけられます。
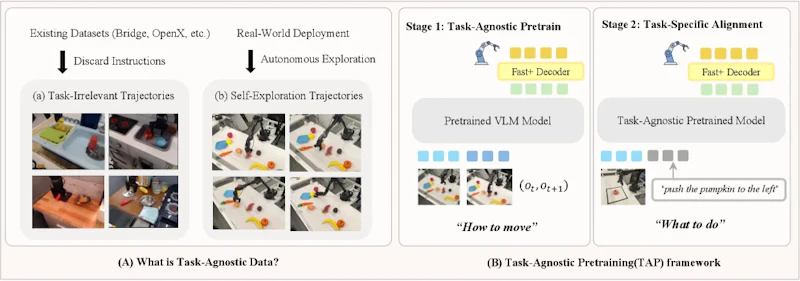
この考え方に基づき、TAPは学習を 2 段階に分けます。第 1 段階ではタスクのラベルが一切ない動作データを使って逆ダイナミクス(Inverse Dynamics)という自己教師あり学習を実施します。逆ダイナミクスとは、2 つの連続するカメラフレームを見て「この間にロボットがどんな動作をしたか」を予測する学習手法です。この予測課題を通じて、モデルは物体の把持や接触といった「動き方の物理的知識」を自然に習得します。
2段階フレームワーク
第 1 段階で扱うデータには、Bridgeデータセットなどのロボットデータやロボットが自律的に探索した際の記録が含まれます。成功した操作だけでなく失敗軌跡も使える点が重要です。タスクラベルを必要としないため、「何をしようとして失敗したか」が不明でも学習に活用できます。
第 2 段階では、第 1 段階で習得した「動き方の知識」を基盤に、少量の言語付き専門家デモで言語接地(Language Grounding)を行います。言語接地とは、「にんじんをお皿に置いて」といった自然言語の指示と具体的な動作を結び付ける学習です。ここで必要な専門家データの量を大幅に削減できる点が、TAPの核心的な価値です。
シミュレーション評価
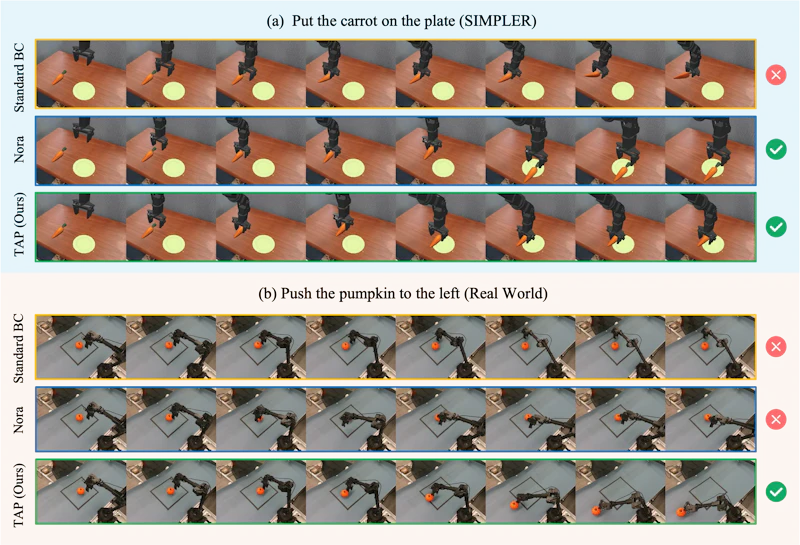
シミュレーション評価では、Googleが開発したSIMPLERベンチマークを使用しました。SIMPLERは実世界のロボット操作タスクをリアルな視覚環境でシミュレーションし、把持・配置などの操作能力を定量評価するベンチマークで、VLA研究の標準的な評価指標として広く採用されています。
TAPは標準的な行動模倣学習(Behavioral Cloning)と比較して絶対的な成功率が 10% 向上しました。さらに 100 万件以上の専門家軌跡で学習した手法と同等の性能を、はるかに少ない専門家データで達成しています。
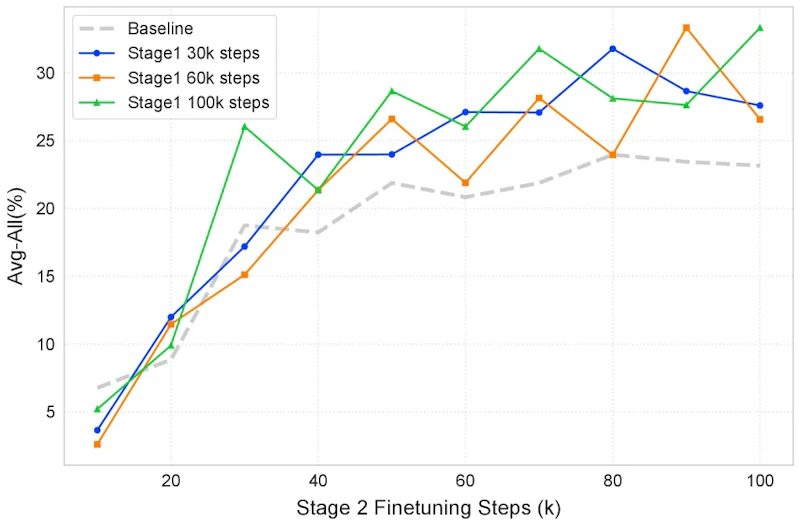
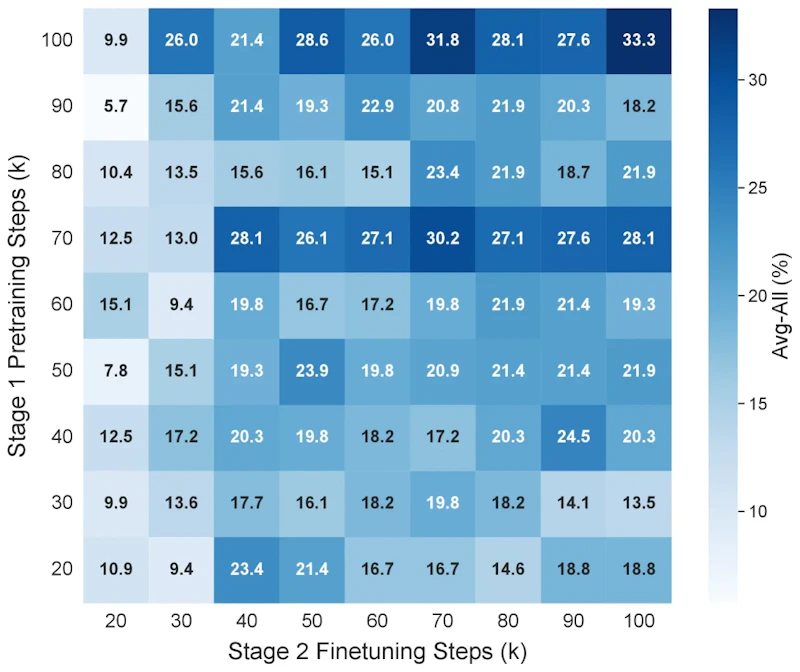
データスケーリング分析では、第 2 段階(言語接地)のデータ量を増やすより第 1 段階(タスク非依存事前学習)のデータ量を増やす方が性能向上に大きく寄与することが明らかになりました。事前学習のスケールが性能の上限を決定するという、TAPの設計思想を裏付ける重要な知見です。
実機ロボットの検証
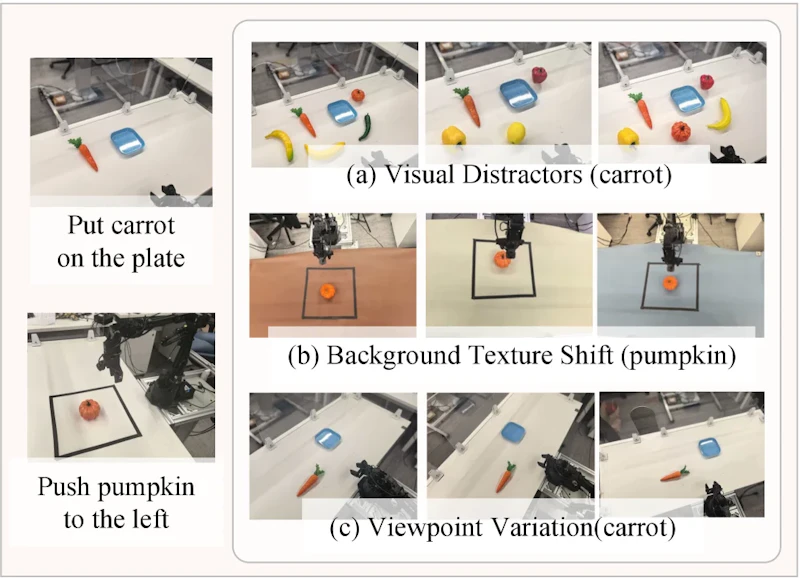
実機実験ではWidowX 250ロボットアームを使い、「にんじんをお皿に置く」「かぼちゃを押す」の 2 タスクを評価しました。実環境でのロボット研究では分布変化(Distribution Shift)、つまり学習時と評価時の環境条件のずれが大きな課題です。
カメラ角度の変化、背景テクスチャの変更、見たことのない物体の追加などの条件で評価したところ、標準的なベースラインはカメラ角度変化だけで成功率が 0% に崩壊しました。一方 TAP は 25% の成功率を維持し、事前学習で身につけた物理的な知識が実環境の変化にも頑健であることを示しています。
アテンションマップの分析
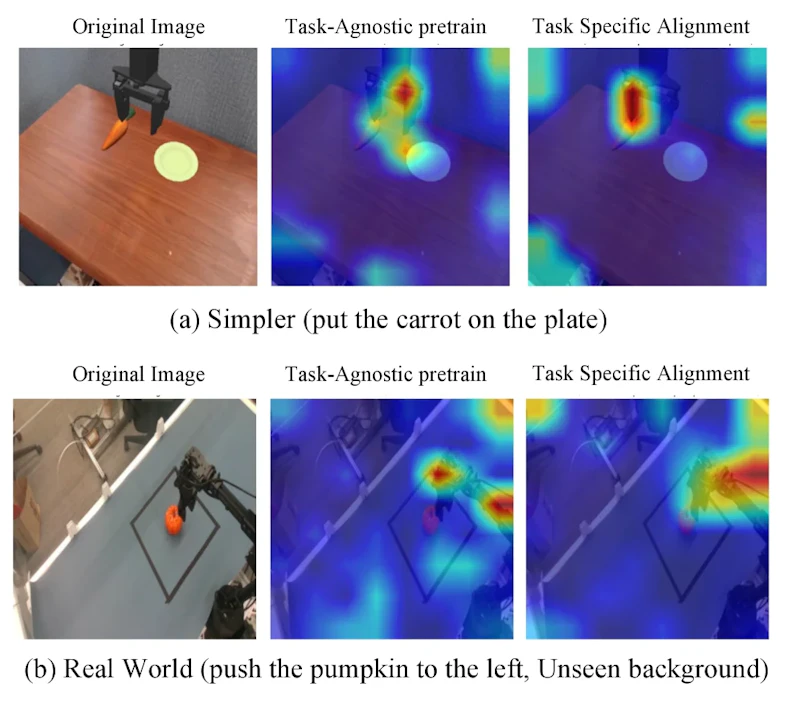
アテンションマップの分析からも、TAPの学習が意味ある表現を獲得していることが確認されています。タスク非依存事前学習だけを施したモデルは、言語指示がない状態でもグリッパーや操作対象の物体に自然と注意が集まりました。言語接地後はグリッパー周辺への注意がさらに強化され、シミュレーションと実機の両環境で一貫したパターンが観察されました。
これは事前学習で獲得した物理的な知識が新しい環境にも転移していることを示しています。ロボットの自律スキル学習を別のアプローチで実現する取り組みとして、ASPIREとは?ロボットが自律的にスキルを発見・蓄積するコード駆動型学習フレームワークも参考になります。
まとめと今後の展望
TAPが示した「動き方と何をするかは分離して学べる」という考え方は、VLAの学習効率を根本から改善する可能性があります。専門家デモの収集コストはロボット研究の大きな制約でしたが、TAPのようなアプローチが普及すれば、失敗データや自律探索データを積極的に再利用できます。
現状の課題として、評価したタスクの種類がまだ限られている点や、実機環境のさらなる多様化への対応が残ります。今後は対象タスクの拡大や、より大規模な未ラベルデータの活用によって、さらなる性能向上が期待されます。
論文情報: "Learning to Move Before Learning to Do: Task-Agnostic pretraining for VLAs"(Junhao Shi et al., 2026) arXiv:2607.02466, CC BY 4.0
本記事の図(図1〜図6)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


