 AI-Papers
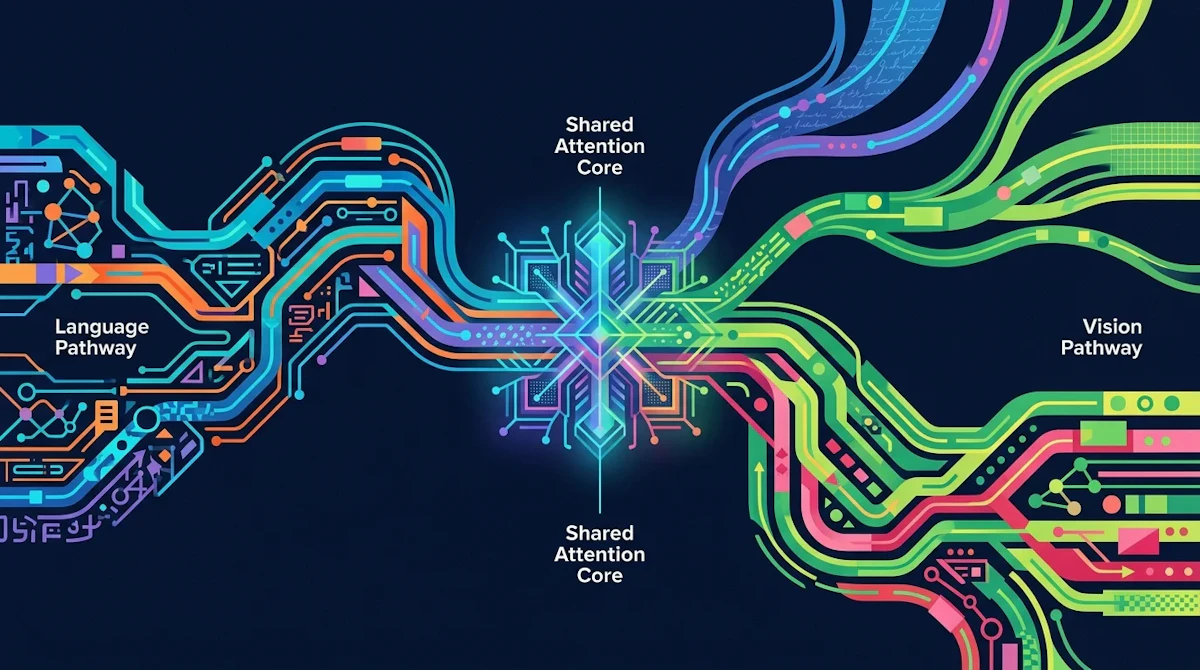
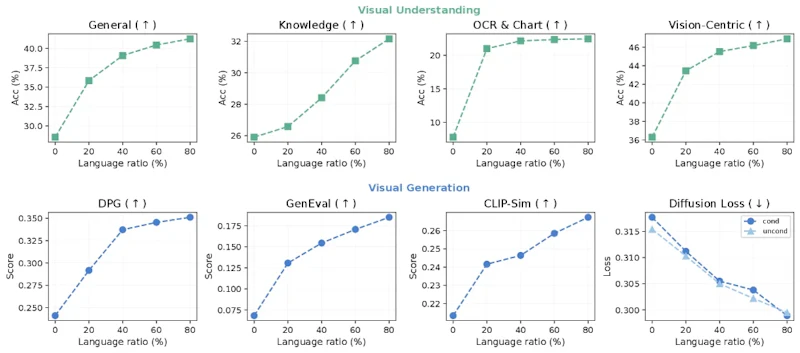
- 言語データの追加は視覚理解と生成の両方を普遍的に高める一方、視覚理解は生成を助けるが逆方向はほとんど機能しないという知識伝達の非対称性を実証しました
- 共有Attentionとモダリティ別FFNという構成が、モダリティ間の競合を抑えつつ協調を最大化する最適な設計だと示しました
- 13.5BのMoEモデルを2兆トークンで訓練し、早期統合レシピによって標準の5%の計算量で高い生成性能を達成しました
研究の背景
近年のAIは、テキストを理解して生成するだけでなく、画像を見て理解し、さらに画像を生成する能力を1つのモデルに統合する方向へ進んでいます。こうした統合マルチモーダルモデルは、言語と視覚の両方を扱える柔軟さから注目を集めています。
ところが、複数のモダリティ(言語や画像といった情報の種類)を同時に学習させると、それぞれの能力が互いに助け合うのか、それとも足を引っ張り合うのかは、これまで経験則に頼って設計されてきました。学習データの混ぜ方や統合のタイミングを間違えると、性能が思うように伸びないという問題があります。
Meta AI の Junlin Han らによる論文「Towards Physics of Multimodal Pretraining」は、この「モダリティ同士がどう影響し合うか」を体系的な実験で解剖しました。単なる分析にとどまらず、実際に大規模モデルを訓練して検証している点が特徴です。
知識伝達の非対称性
研究チームはまず、言語、視覚理解、視覚生成の3つの能力の間で知識がどう流れるかを調べました。すると、能力同士の助け合いは対称ではなく、明確な方向性があることが分かります。伝達の向きごとに整理すると次のとおりです。
- 言語データを増やすと、視覚理解と視覚生成の両方が例外なく向上する
- 視覚理解のデータを増やすと視覚生成は大きく改善するが、純粋な言語性能はやや低下する
- 視覚生成のデータを増やしても、視覚理解はほとんど改善しない
つまり言語は、視覚能力全体を底上げする普遍的な後押し役として働きます。一方で視覚側から言語への影響は一様ではなく、代償を伴う場合もありました。
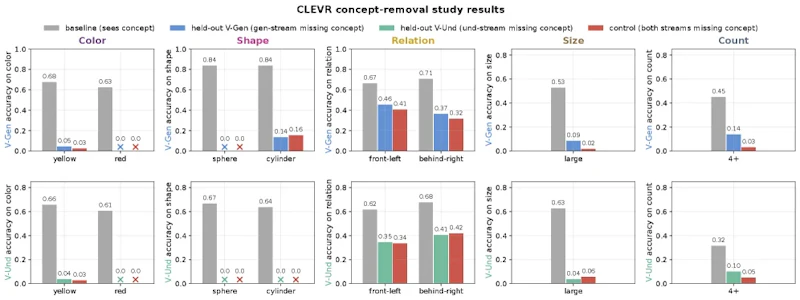
この非対称性は、どの種類の概念が伝わるかを見るとさらにはっきりします。視覚を理解する能力は生成を助けますが、生成する能力は理解をほとんど助けません。研究チームは CLEVR という合成データセットを使い、色や形といった低レベルの属性と、位置関係やサイズ、個数といった構造的な概念を切り分けて検証しました。
その結果、色や形のような低レベルの属性はどちらの方向にも伝わりませんでした。これに対し、位置関係やサイズ、個数といった構造的な概念では、理解から生成への伝達だけが機能するという非対称性がはっきり現れます。学習していない概念でも、理解を通じて得た知識が生成側で活用されるのです。
協調を生むアーキテクチャ
次にチームは、モデルのどの部分を共有し、どの部分を分けるべきかを調べました。ここでの主役は Attention(入力の重要な部分に注目する仕組み)と FFN(Feed-Forward Network、各トークンを個別に変換する層)です。
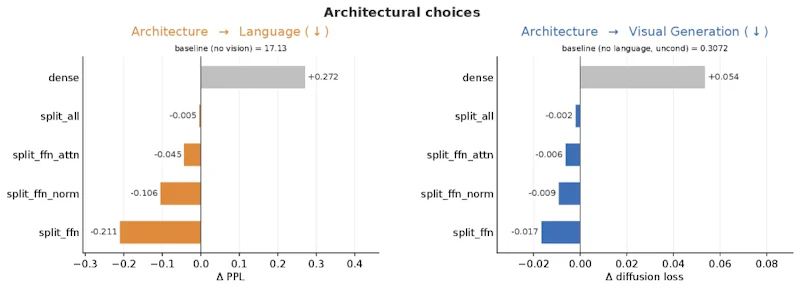
すべてのパラメータを完全に共有すると、モダリティ同士が同じ資源を奪い合い、言語も視覚も性能が落ちてしまいます。逆に、すべてを完全に分離すると、モダリティを混ぜない場合と変わらず、協調の恩恵が得られませんでした。
最適だったのは、FFN だけをモダリティごとに分け、Attention と正規化層は共有するという構成です。共有された Attention が言語と視覚をつなぐ橋渡しとなって協調を生み出し、モダリティ別の FFN がそれぞれの処理を専門化することで競合を防ぎます。この設計が、競合の抑制と協調の促進を両立させていました。
早期統合と視覚の怠惰
統合をいつ始めるべきかも重要な論点です。よくある考え方は、まず言語だけで十分に学習させてから、後で視覚を加えるというものでしょう。しかし本研究は、この遅延統合が思わぬ副作用を生むことを突き止めました。
純粋な言語だけで長く学習させてから視覚を導入すると、言語の指標はわずかに良くなるものの、視覚理解と視覚生成のすべてのベンチマークで性能が急激に低下します。チームはこの現象を視覚の怠惰(vision laziness)と名付けました。
遅れて視覚を加えると、モデルは言語の信号に頼りきってしまい、画像そのものへの注目が弱まります。視覚専用の FFN の活性化が層を経るごとに小さくなり、推論時に画像トークンへ向けられる Attention の割合も減っていきました。つまり、せっかく用意した視覚用のパラメータをモデルが使わなくなってしまうのです。
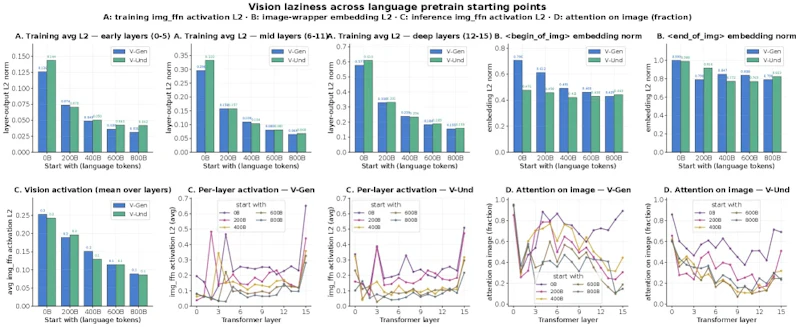
この結果は、モダリティを最初の段階から統合して一緒に訓練する早期統合の優位性を裏付けています。実際、順番に学習させる逐次訓練よりも、最初から同時に学習させる統合訓練の方がほぼすべての指標で上回りました。
学習データの構成が性能を決めるという意味で、この考え方は画像生成のプロンプトにスケーリング則を発見した研究とも通じる視点です。
データの複雑さと計算量5%レシピ
モダリティが協調するか競合するかは、アーキテクチャだけでなくデータの性質に大きく左右されることも分かりました。単純な視覚タスク(背景やノイズなど)は言語モデリングを助けますが、動画のような複雑な視覚分布はテキストの予測精度を下げます。言語側も同様で、最も単純な言語分布が視覚生成に最大の相乗効果をもたらしました。
これらの知見を統合し、研究チームは効率的な事前学習レシピを提示しています。採用したのは MoE(Mixture of Experts、入力に応じて専門家モジュールを切り替える仕組み)モデルで、構成は次の表のとおりです。
項目 | 本レシピ |
|---|---|
モデル規模 | 13.5B パラメータ(MoE) |
訓練トークン数 | 2兆トークン |
計算量 | 標準的な手法のわずか5% |
この構成で高い生成性能を達成した点が本研究の実証部分にあたります。大規模なモデルで検証されている点は実用上の意義が大きく、設計指針が実運用の規模でも成り立つことを示しました。
まとめと今後の展望
本研究は、統合マルチモーダルモデルの事前学習を「物理法則」のように体系的な原理として整理しました。知識伝達の非対称性、共有Attentionとモダリティ別FFNによる協調、早期統合の優位性という3つの柱は、多くの統合モデル開発にそのまま応用できます。
一方で、検証の中心は CLEVR のような合成データや特定のベンチマークであり、より多様で大規模な実世界データでの一般性は今後の課題として残ります。データの複雑さが協調と競合の分かれ目になるという知見自体、扱うタスクによって最適な設計が変わる可能性を示唆しています。
それでも、経験則に頼ってきたマルチモーダル事前学習に定量的な設計指針を与えた意義は大きく、統合モデルの効率的な開発を進める土台になりそうです。
論文情報: "Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes"(Junlin Han et al., 2026) arXiv:2608.05000
本記事の図(図1、図5、図9、図13)は解説のため上記論文より引用しています。


