 AI-Papers
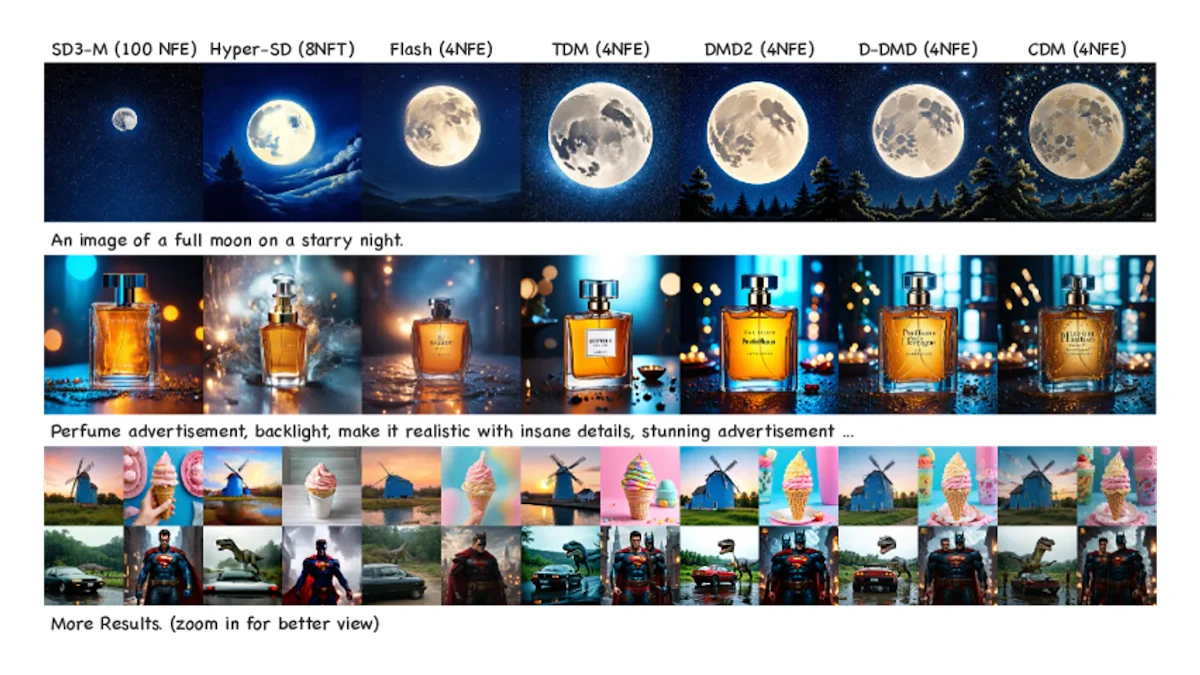
- 固定離散タイムステップを動的な連続スケジュールへ拡張し、過平滑化・視覚的アーティファクトを解消した新しい蒸留フレームワーク
- GANや報酬モデルなどの補助モジュールを必要とせず、SD3-MediumとLongcat-Imageで4ステップの高品質生成を実現
- 速度場を用いたオフトラジェクトリ潜在変数の外挿により、アンカー間の不整合問題を根本から解決
研究の背景
拡散モデル(Diffusion Model)は高品質な画像生成において目覚ましい成果を上げてきましたが、推論時に多数のステップを必要とするという根本的な課題を抱えています。1枚の画像を生成するために数十から数百回のネットワーク推論を繰り返す必要があり、リアルタイム応用には大きな障壁となっています。
この課題を解決するアプローチとして「蒸留(Distillation)」が注目されています。教師モデルの知識を少ステップで動く学生モデルへ転移する技術で、特に分布マッチング蒸留(Distribution Matching Distillation、DMD)は有力な手法として注目されてきました。しかし従来のDMDは固定された離散タイムステップに縛られており、この制約が生成品質の頭打ちを招いていました。
離散ステップへの厳密な整合がなぜ問題なのか。推論時に使用するステップ数が変われば蒸留のやり直しが必要になる上、固定スケジュール上でのみ最適化された学生モデルは、その外側の時間領域における分布整合が不十分になります。結果として過平滑化した出力や視覚的アーティファクトが生じやすく、生成品質の改善に限界がありました。
連続時間アプローチの核心
本研究が提案するCDM(Continuous-Time Distribution Matching)は、この離散制約を根本から取り払います。最大の革新は、固定された推論タイムステップではなく、連続時間区間 (0,1] から一様サンプリングした動的スケジュールを用いて蒸留を行う点です。
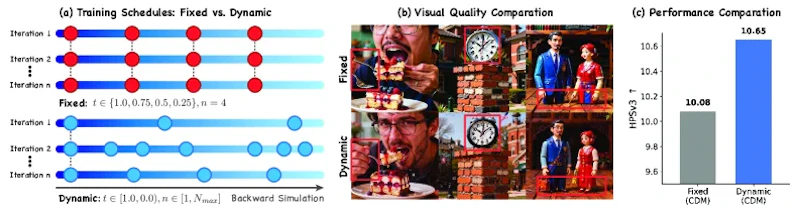
従来手法では蒸留のたびに「このステップで推論する」という制約を課していましたが、CDMは各学習イテレーションで連続区間からランダムにアンカー点を選び最適化します。実験的にも示されているように、この「スケジュール解放」は視覚的品質の向上につながり、厳密な離散整合がむしろ性能を制限していたことが裏付けられました。
3つの目的関数の設計
CDMの蒸留フレームワークは3つの損失関数の組み合わせで構成されています。
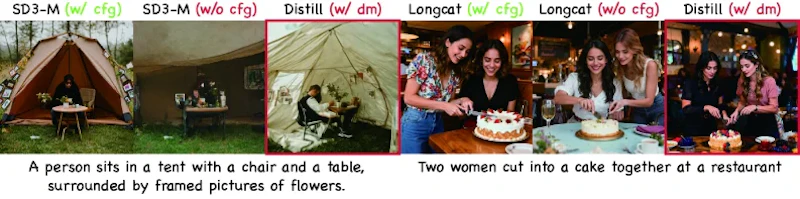
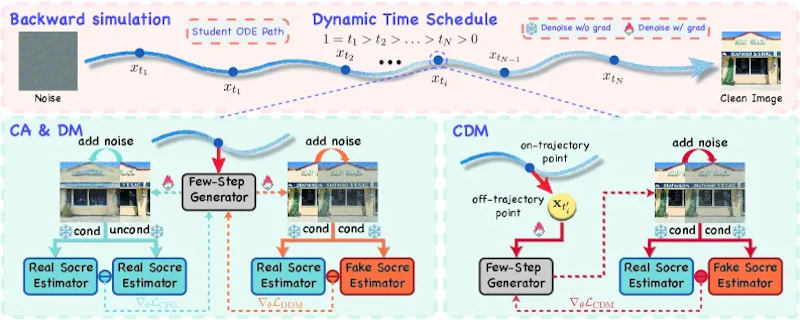
1つ目はCFG拡張損失(CA損失)です。Classifier-Free Guidance(CFG)はテキストと画像の整合性を高める重要な技術ですが、蒸留モデルへの転移が難しい要素でもあります。CA損失はオントラジェクトリのアンカー点でCFGが効いた教師の条件付き分布に学生を整合させます。
2つ目は分布マッチング損失(DM損失)です。教師モデルのCFGなし分布へ学生を引き寄せるための損失で、補助的なGANや報酬モデルなどを不要とする設計になっています。
3つ目が本研究の最も独創的な貢献であるCDM損失です。動的スケジューリングでは異なるアンカー点間に「不整合」が生じる場合があります。たとえばアンカー の潜在変数から次のアンカー への遷移が、学習中に使われなかったパスを経由する場合です。CDM損失はこの問題を、学生モデルが予測する速度場(velocity field)を用いてオフトラジェクトリの潜在変数を外挿することで解決します。いわば「実際に通らなかった経路上の潜在状態を数学的に推定して整合させる」という発想です。
実験結果と比較
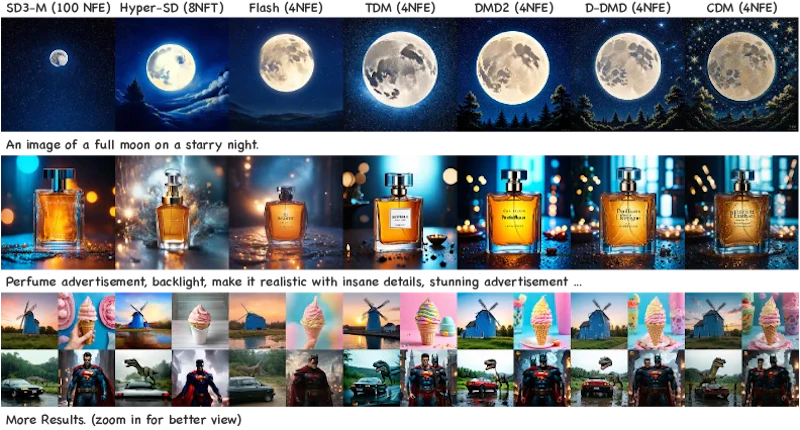
CDMはSD3-Medium(1024×1024解像度)とLongcat-Imageという異なるアーキテクチャのモデルで検証されました。4ステップという少ない推論回数(NFE=4)で既存の競合手法を上回る視覚的忠実度を達成しています。
特筆すべきは、GAN識別器や学習済み報酬モデルといった複雑な補助モジュールを一切使わずにこの結果を達成した点です。MARBLEのような複数報酬を扱う手法と比べても、CDMはシンプルな構成で高い競争力を示しています。
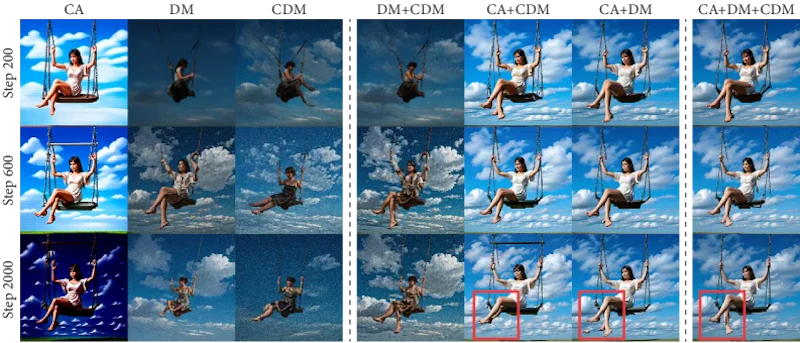
アブレーション実験では、3つの損失関数がそれぞれ独立した役割を持つことが確認されました。CA損失のみでは明るさの崩壊が起きやすく、DM損失のみでは局所的な忠実度が低下し、CDM損失のみでは意味的整合が不十分になります。3つすべての組み合わせ(CA+DM+CDM)が最も安定した高品質な出力を維持しました。
また、1つのチェックポイントからNFE(推論ステップ数)を3〜8の範囲で柔軟に変更できることも示されています。ステップ数を増やすほど細部が向上する一方、3ステップでも意味的整合性が保たれており、実用的な柔軟性の高さが確認されました。
まとめと今後の展望
CDMは分布マッチング蒸留を初めて連続時間へ拡張した研究として、拡散モデル高速化の新しい方向性を切り開きました。GANや報酬モデルなどの複雑な補助モジュールへの依存を排除しながら、過平滑化・視覚的アーティファクトという従来手法の弱点を連続時間最適化によって解決した点は技術的な前進です。
一方で現在の検証はSD3-MediumとLongcat-Imageという特定モデルに限られており、より広いアーキテクチャへの汎化性はまだ示されていません。速度場による外挿の精度が学生モデルの質に依存するため、学習初期の不安定性への対処も今後の課題として残ります。コードはGitHubで公開されており、研究コミュニティによる再現・発展が期待されます。
論文情報: "Continuous-Time Distribution Matching for Few-Step Diffusion Distillation"(Tao Liu et al., 2026) arXiv:2605.06376, CC BY 4.0
本記事の図(図1〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


