 AI-Papers
- ByteDanceが自然言語による声質デザインと参照音声からのゼロショット声質クローンを単一モデルで両立するSwanTaleを発表
- 48kHz対応のSwanVAE、報酬条件付きのflow-based Transformer、動的ルーティングのMoEを組み合わせ、会話・歌唱・環境音まで一貫生成
- InstructTTSEvalの中国語APSで86.1%と首位、シーン品質のMOS4.22を記録し既存手法を上回る
研究の背景
近年の音声合成(テキストから音声を作る技術、Text to Speech、TTS)は、人間と聞き分けがつかないほど自然な発話を生成できるようになりました。しかし実用の現場では、まだ複数の異なる目的を別々のモデルで扱わなければならないという課題が残っています。
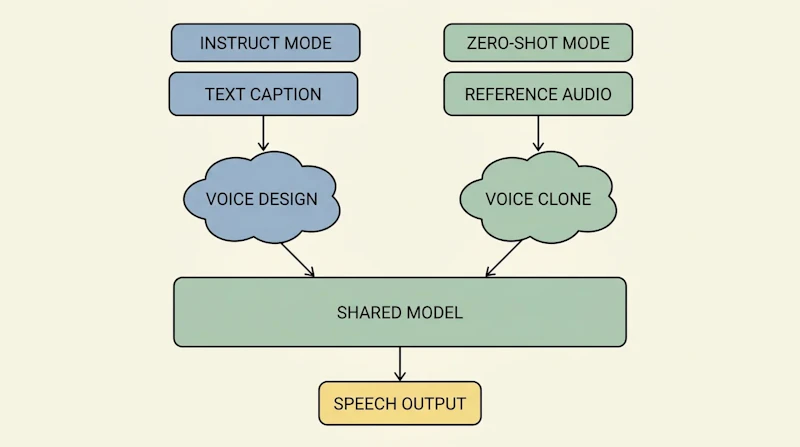
音声生成には大きく2つの流儀があります。1つは「落ち着いた低い男性の声で」といった自然言語の指示から声を設計する方式(instruct方式)です。もう1つは、数秒の参照音声を渡してその声質をそのまま再現する方式(ゼロショット声質クローン)です。従来はこれらを別モデルで実現することが多く、さらに歌唱や環境音まで含めた総合的な音響生成となると、扱えるモデルは限られていました。
音声インターフェースの重要性は業界全体で高まっており、応答の低遅延化を追求するOpenAIのGPT-Liveのような動きも見られます。こうした流れの中で、ByteDanceが提案したSwanTaleは、声質デザインとクローン、さらに複数話者の会話や歌唱、環境音までを1つのモデルに統合した点が特徴です。研究チームは、データ不足、タスク間の相性の悪さ、複数の音響モダリティが混在する複雑さという3つの壁に正面から取り組みました。
提案手法
SwanTaleは複数の技術要素を組み合わせた統合モデルです。中核となるのは、音声を圧縮・復元するSwanVAE、生成を担うflow-based Transformer、そして計算資源を動的に振り分けるMoE(Mixture of Experts、複数の専門家モジュールを切り替える仕組み)の3つです。
SwanVAEは、48kHzのモノラル音声を25Hz(40msごと)の96次元の連続的な潜在表現に変換する自己符号化器です。総パラメータ数は407Mで、音声、歌唱、一般音響、音楽にわたる約10万時間のデータで学習されています。1つのVAEで4つの音響モダリティを高品質に扱える点が、統合生成の土台になっています。
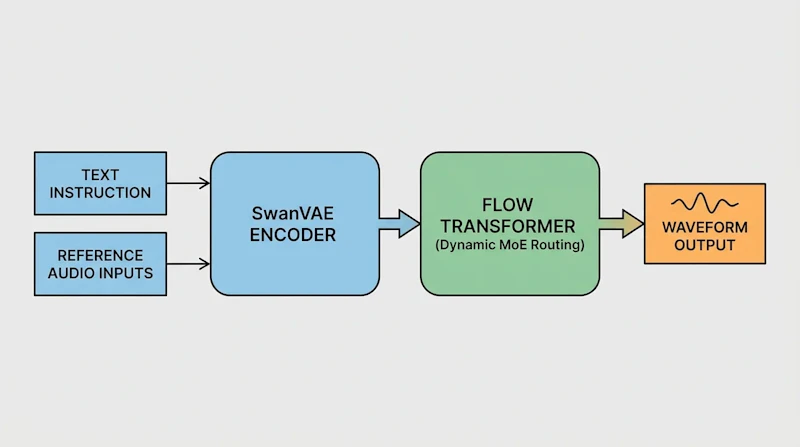
生成本体は、flow matching(雑音から目標へ滑らかに変換する生成手法)を用いる非因果的な拡散Transformerです。キャプション全体による制御と、話者・内容の整合性を分離して扱うことで、instruct方式とゼロショット方式の両方を1つの枠組みで実現します。さらにSTOIやPESQ、MOSといった音質指標を条件として与える報酬条件付き学習を取り入れ、生成品質を安定させています。
もう1つの要となるのが動的ルーティングのMoEです。ここには3種類の専門家が用意されています。タスク共有の専門家がinstructとゼロショットの生成傾向をとらえ、ルーティングされる音響専門家がフレーム単位で音響の変化に対応し、ヌル専門家が安定した区間で処理を省略します。潜在表現と拡散のタイムステップに応じてTop-Pルーティングを行い、Gumbel温度のアニーリングによって専門家の役割分担を滑らかに獲得させます。
学習には、独自に構築したSwanData-Captionという約7000万件のキャプション付きデータセットを使います。カバレッジ設計、音声の前処理、環境や話者や内容のアノテーション、そして人手検証を含む4段階の処理で作られています。学習はカリキュラム学習で段階的に進め、まずゼロショットの基礎モデルを学習し、密なキャプションへの適応、MoEを含む全キャプション混合学習、高表現力の教師ありファインチューニングへと積み上げます。最後にFlow-GRPOという強化学習で、音素の正確さやポーズ、音質など6種類の報酬を使って仕上げます。
実験結果
SwanTaleは複数のベンチマークで既存手法を上回る結果を示しました。自然言語指示から音響パラメータを再現するInstructTTSEvalの音響パラメータ指定(APS)では、中国語で86.1%と首位、英語で84.2%と首位タイを記録しています。
参照音声からの声質クローンを評価するゼロショット設定でも高い性能を示しました。モノローグでは声質の一貫性が0.95で首位、表現の豊かさが5点満点中3.90で首位となっています。複数話者の会話設定でも声質一貫性0.94で首位を維持し、統合モデルでありながら各タスクで単機能モデルに引けを取らない結果を出しています。
評価項目 | スコア | 順位 |
|---|---|---|
APS(中国語) | 86.1% | 1位 |
声質一貫性(モノローグ) | 0.95 | 1位 |
シーン品質の平均MOS | 4.22 / 5.0 | 1位 |
音の充実感 | 4.47 / 5.0 | 1位 |
環境音を含むシーン生成の評価では、平均MOS(主観品質評価、5点満点)が4.22で首位となりました。韻律の自然さ4.20、音の充実感4.47など、細かい観点でもトップを占めています。土台となるSwanVAEの再構成品質も、音声でPESQ3.91、歌唱でSTOI0.96と、いずれも高い水準に達しています。
まとめと今後の展望
SwanTaleは、これまで別々のモデルで扱われてきた声質デザイン、ゼロショット声質クローン、複数話者の会話、歌唱、環境音を単一モデルに統合しました。48kHzのSwanVAE、報酬条件付きのflow-based Transformer、フレームとタスクの両面で切り替える動的MoEという構成により、統合しても各タスクの性能を落とさない点が示されています。
一方で研究チームは限界も率直に挙げています。複雑な背景音楽の生成、2分を超える長尺の複数話者シーン、感情の変化や強調やタイミングといった局所的なスタイル制御には、まだ改善の余地があるとしています。今後は音声生成と編集を統合した枠組みへの発展が示唆されており、統合音声モデルの研究がどこまで裾野を広げるか、実用面での応用も含めて注目されます。


