 AI-Papers
- GPT-Liveは発話の切れ目を待つターン検出器を廃止し、聞くと話すを同時に行う全二重の音声モデルを採用しています
- 音声処理を独立した高速経路に分け、複雑な推論はGPT-5.5などへ非同期で委譲することで低遅延と会話の連続性を両立します
- WebRTCの接続手順を切り詰めてほぼ1パケットでセッションを開始する設計を、約6カ月で構築しました
GPT-Liveを発表
OpenAIは2026年8月、連続的な音声対話を実現する音声システム「GPT-Live」を公式ブログで発表しました。従来の音声AIが前提としてきた「話す、待つ、返答する」というターン制をやめ、人と人の会話に近い切れ目のないやり取りを目指した点が特徴です。
同社はこのシステムを約6カ月という短い期間で構築したと説明しています。設計全体を貫く原則として「音声は流れ続けなければならない」という考え方を掲げ、クライアントからモデルまであらゆる層で遅延と中断を減らす方針を取りました。
従来の音声AIの課題
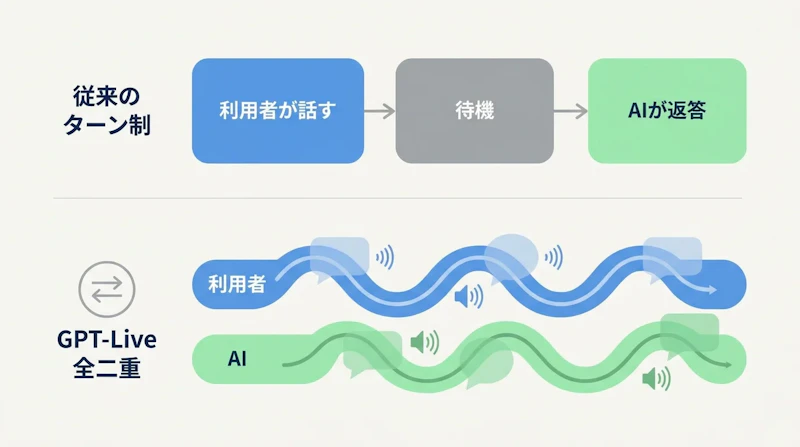
これまでの音声AIの多くは、音声をテキストに変換する音声認識、応答を考える大規模言語モデル(Large Language Model、LLM)、テキストを読み上げる音声合成という3つの処理を順番に通す構成でした。この方式では、利用者の発話が終わったかどうかを判断する「ターン検出器」が必要になります。
ターン検出器は発話の切れ目を予測してから処理を始めるため、どうしても判断待ちの時間が生まれます。相づちを打ちながら話したり、途中で言葉を挟んだりといった自然な会話が苦手で、やり取りがぎこちなくなる原因になっていました。
聞くと話すを同時に行う
GPT-Liveの中核は、聞くことと話すことを同時にこなせる全二重(フルデュプレックス)の音声モデルです。相手の発話終了を待つターン検出器を取り除き、音声を途切れさせずに双方向でやり取りできるようにしました。
この仕組みによって、利用者が話している最中でもモデルが反応でき、割り込みや相づちを含む会話が成立します。人が電話で自然に話すときのような、声が重なるやり取りに近づいたといえます。
低遅延を支える通信設計
会話の自然さは、実際に音声が届くまでの速さにも左右されます。GPT-Liveはブラウザなどとリアルタイム通信を行うWebRTCを基盤にしつつ、接続開始にかかる手順を切り詰めた「WARP」「Instant Connect」と呼ばれる仕組みを開発しました。
これにより、通信の確立をほぼ1パケットで済ませ、会話が始まるまでの待ち時間を短くしています。音声が流れる経路とアプリの処理を分け、音声だけを独立した高速な経路で扱う設計にした点も、遅延を抑える鍵になっています。
会話を止めないモデル引き継ぎ
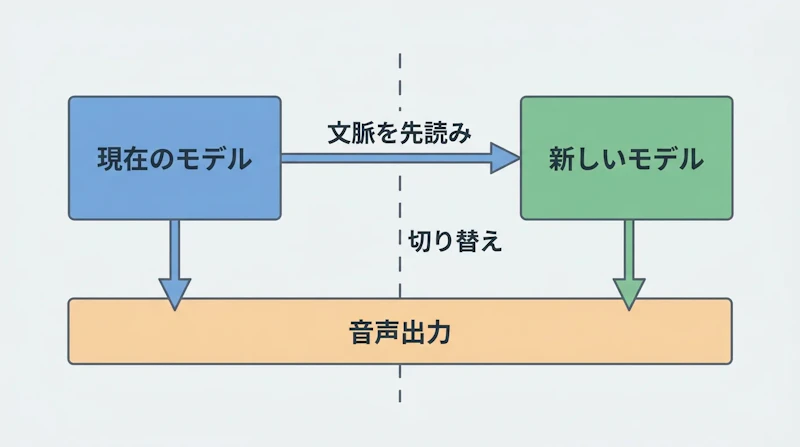
長い会話を途切れさせないため、OpenAIは状態を保持したままモデルを切り替える手法を用意しました。稼働中のモデルの隣に新しいモデルを温めておき、それまでの会話の文脈を先読みで読み込ませてから静かに引き継ぐ方式です。
深い推論やツールの利用が必要な場面では、会話の流れを止めずにGPT-5.5などのより高性能なモデルへ非同期で処理を委ねます。すぐ返すべき応答と時間のかかる処理を分けることで、応答の速さと内容の深さを両立させています。
開発者にとっての意味
OpenAIは運用の知見として、処理能力の管理がGPUの処理量だけでなく「同時に接続しているセッション数」で決まる点を挙げています。利用者に近い場所で推論を行う地理的なルーティングも、応答性を保つうえで重要になるといいます。
音声インターフェースの実用化はすでに始まっており、先行するGPT-Realtimeはヤマダ電機の店頭接客などで使われています。ターン制を廃したGPT-Liveは、こうした対話アプリの自然さをさらに引き上げる基盤になりそうです。


