 AI-Papers
- Mixture-of-Experts(MoE)のルーティング自体を揺らし、トークン空間ではなくエキスパート空間で探索する強化学習手法ESRLが提案されました
- 高信頼なエキスパートは固定し、候補プール内だけを摂動、強度はルータエントロピーで自動調整することで多様性と品質を両立します
- Qwen3-30B-A3BでGRPO比Pass@1 +3.2ポイント、Pass@8 +4.5ポイントを、追加サンプリングなしで達成しました
研究の背景
大規模言語モデル(Large Language Model、LLM)の推論能力を強化学習で伸ばす手法では、同じ問題に対して複数の解答を生成し、正解したものを強化するという流れが一般的です。このとき学習の質を左右するのが、生成される解答の多様性です。すべてのロールアウト(試行生成)が同じ答えに収束してしまうと、報酬に差が生まれず勾配がほぼ消えてしまいます。
これまで多様性を作る手段は、デコード温度を上げる、top-p を広げるといったトークン空間の操作にほぼ限られていました。しかし温度を上げれば上げるほど個々の出力品質は落ちるため、多様性と正確さのトレードオフからは逃れられません。
本論文が着目したのは、MoEアーキテクチャが持つもう1つの自由度です。MoEは入力トークンごとにルータが少数のエキスパート(部分ネットワーク)を選び、その組み合わせで計算を行います。つまり、どのエキスパートを選ぶかという選択自体が出力を変える余地を持っているわけですが、従来の強化学習はこの選択を固定された前提として扱ってきました。
ルーティングを揺らすと何が起きるか
著者らはまず、ルータのスコアにノイズを加えるとモデルの挙動がどう変わるかを分析しています。ノイズを入れると選ばれるエキスパートが入れ替わり、次トークンの確率分布そのものが移動します。層ごとのエキスパート利用の偏り(変動係数)は小さくなり、普段使われないエキスパートまで活性化することが確認されました。
つまりルーティング摂動は、温度を上げるのと似た効果で出力の多様性を増やせます。ただし副作用も明確で、その入力にふさわしくないエキスパートが選ばれると生成品質が落ちます。
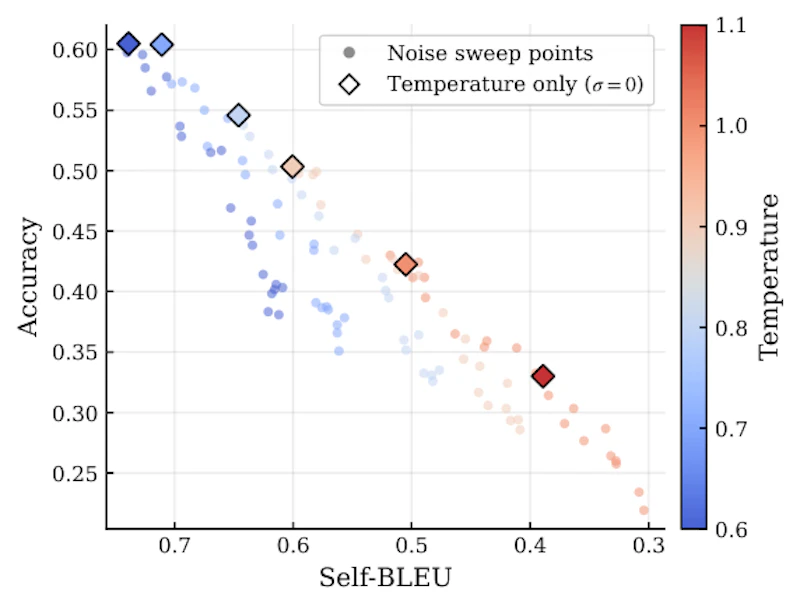
図1は、温度を上げた場合とルーティングノイズを直接加えた場合の、正確さと多様性の関係を比べたものです。単純なノイズ注入では強度を上げるほど精度が崩れてしまうため、「どこを揺らし、どこを固定するか」の設計が必要になります。
提案手法ESRLの仕組み
ESRL(Expert-Space Exploration Reinforcement Learning)は、ルーティング摂動を制御された形で行う枠組みです。中心となるのは、エキスパートを2つのグループに分けるという発想です。ルータのスコアが高く自信を持って選ばれているアンカー(固定)エキスパートはそのまま維持し、スコアが拮抗していて入れ替わりうるエキスパートだけを探索用の候補プールとして扱います。摂動はこのプール内に限定されるため、明らかに不適切なエキスパートが呼び出される事態を避けられます。
摂動の強さも一定ではありません。ルータの正規化エントロピー(選択の迷いの大きさ)を見て、ルータが確信を持っている場面ではノイズを弱く、判断が割れている場面では強くという形で適応的に調整します。確信度の高い箇所を無理に揺らさないことで、品質の低下を抑えながら多様性だけを引き出す狙いです。
もう1つの要素がルーティングリプレイです。ロールアウト時にノイズ込みで選ばれたエキスパート経路をそのまま記録しておき、学習時にはtop-K選択をやり直さずに記録した経路を再生します。これを行わないと、生成時と学習時で通る計算経路がずれ、方策勾配の計算対象が実際に確率を生んだ経路と食い違ってしまいます。
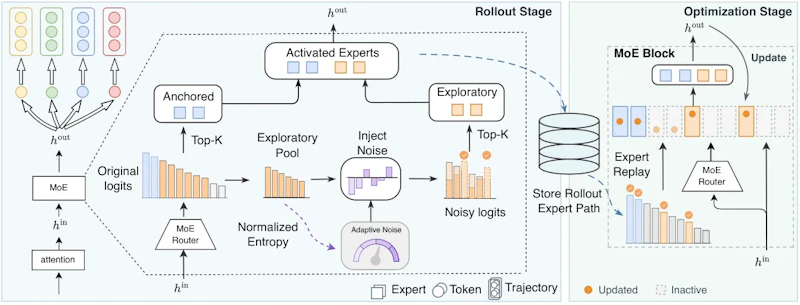
図2がESRL全体の流れです。左側のロールアウトでエントロピーに応じたノイズを加えて多様な軌跡を生み出し、右側の最適化で経路を再生して整合性を保つという二段構成になっています。既存の強化学習パイプラインの外側に追加のサンプリングを足すわけではないため、計算コストはほとんど増えません。LLM向け強化学習基盤の全体像についてはMiles v0.1の解説記事も参考になります。
実験結果
評価はQwen3-30B-A3B(128エキスパートからtop-8を選択)を主軸に、単一エキスパート選択のSigma-20B-A0.5B、共有エキスパートを持つMoonlight-16B-A3Bという異なるルーティング方式でも行われました。ベースラインはGRPOです。
ベンチマーク | GRPO | ESRL | 差分 |
|---|---|---|---|
OlympiadBench(Pass@1) | 51.2% | 53.5% | +2.3pt |
AIME 2024(Pass@1) | 21.9% | 24.4% | +2.5pt |
AMC(Pass@1) | 41.9% | 49.6% | +7.7pt |
GPQA(Pass@1) | 35.7% | 39.0% | +3.3pt |
MMLU-Pro(Pass@1) | 57.6% | 62.5% | +4.9pt |
数学系平均(Pass@8) | 59.7 | 64.2 | +4.5pt |
数学・科学・コードを合わせた平均でPass@1が3.2ポイント、Pass@8が4.5ポイント改善しています。Pass@8の伸びが大きいことは、探索の幅そのものが広がったことを示しています。GPQAではPass@8が23.3ポイント伸びており、正解に到達しうる経路の多様性が確保されたことがうかがえます。
アブレーションでは各要素の必要性も確認されました。アンカーを設けずに全エキスパートへ一様にノイズを加えると、ノイズ強度を上げた際に精度が42.1%から32%へ崩れます。エントロピー適応をやめた固定ノイズ版も、AIMEやAMCで明確に劣りました。サンプル効率の面では、ESRLの64サンプルがGRPO系手法の128サンプルを上回っています。
まとめと今後の展望
ESRLは、探索の舞台をトークン空間からエキスパート空間へ移すという着眼点を、実装可能な形にまとめた研究です。top-K、top-1、共有エキスパートのいずれの構成にも適用でき、MoEが主流化する現在の状況では応用範囲が広いといえます。
一方で課題も残ります。評価の中心は30B級までのモデルで、さらに大規模なMoEで同じ効果が得られるかは確認されていません。ノイズ強度や候補プールの閾値といったハイパーパラメータの調整も必要で、タスクやモデルをまたいだ設定の一般性は今後の検証課題でしょう。ルーティングリプレイによってロールアウト時の経路を保持する必要がある点も、推論基盤側の実装制約になり得ます。
それでも、追加の計算コストなしに強化学習の探索効率を上げられる手段として、MoEモデルの事後学習に取り込む価値のあるアプローチだといえます。
論文情報: "Expert-Space Exploration in MoE Reinforcement Learning"(Hongyi He et al., 2026) arXiv:2609.13058
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


