 AI-Papers
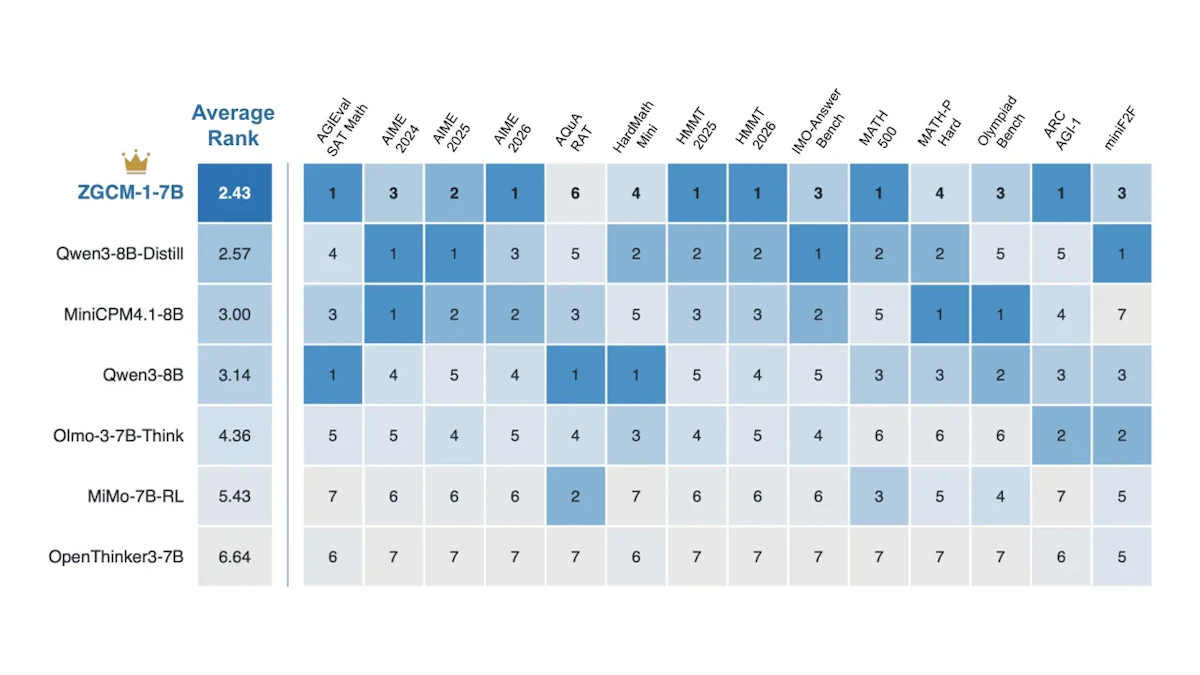
- 7Bの密モデルZGCM-1がエージェント検索のWebWalkerQAで63.09%、BrowseCompで19.43%を記録し、桁違いに大きいQwen3-235B-A22Bを上回りました
- ゲート付きスライディングウィンドウ注意、FP8対応のMuon、活性値を抑えるTWEO、Pre-LNの組み合わせで16K事前学習のtime-to-lossを約4.2倍改善しています
- 事前学習・中間学習・事後学習の全重みと中間チェックポイント、学習コード、段階別データレシピ、W&Bログまで公開されています
研究の背景
高性能な大規模言語モデル(Large Language Model、LLM)の多くは、数千億パラメータ規模のMixture-of-Experts(専門家を切り替えて使う構成)で作られています。一方で、研究や検証の現場では、単一GPUに載る規模で扱えて、しかも学習過程まで追える公開モデルの需要が根強く残っています。
ZGCM-1は、この要求に正面から答えようとした70億パラメータ級の密モデル(全パラメータを毎回使う通常の構成)です。論文タイトルにあるとおり「完全公開」と「極端な効率」を掲げ、数学推論とエージェント検索という2つの領域に狙いを絞っています。
興味深いのは、性能表だけでなく学習の設計判断そのものを成果物として提示している点です。論文は8つの経験的知見を明示し、うまくいかなかった設計にも触れています。
モデル構成と高速化
アーキテクチャは32層で、そのうち27層がゲート付きスライディングウィンドウ注意、残る5層が全系列を見る全注意という交互配置です。局所注意の窓幅は128トークンと小さく、局所と全体の比率は5対1になっています。隠れ次元は4096、クエリヘッド32に対してキーバリューヘッドは8で、最大コンテキストは256Kトークンに達します。
図2の右側にまとめられているように、効率化は単発の工夫ではなく4つの要素の積として説明されています。混成スライディングウィンドウで1.4倍、FP8混合精度の学習システムで1.5倍、Muonオプティマイザで1.8倍、Pre-LN(正規化を残差接続の前に置く配置)で1.1倍となり、掛け合わせると約4.2倍のtime-to-loss改善になるという内訳です。
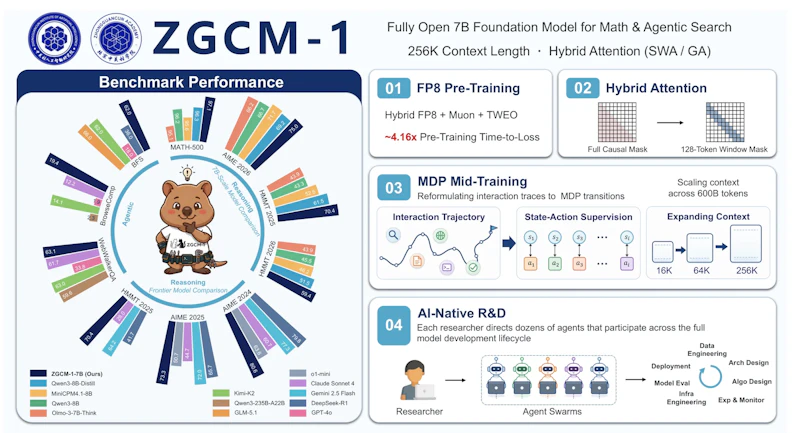
FP8での学習は数値が壊れやすく実運用が難しい領域ですが、ここではTWEOと呼ぶ活性値の外れ値を抑える正則化が鍵になっています。遅延スケーリングと併用することで発散を防ぎつつ、BF16相当の60%というMFU(計算資源の実効利用率)を大規模でも維持できたと報告されています。
公開されている資材
再現性の観点で目を引くのは公開範囲の広さです。重みだけを配布する一般的なオープンモデルと比べ、学習過程の観測手段までそろえています。
- 事前学習・中間学習・事後学習それぞれの段階の重み
- 学習途中の中間チェックポイント
- 学習コードと設定ファイル
- 段階ごとのデータレシピと配合
- Weights & Biases の学習ログ
- 評価用ハーネス
同じくレシピを公開した取り組みとしてはNemotron 3 Ultraもありますが、ZGCM-1は7B規模という手の届く大きさで中間チェックポイントまで出している点が教材としての価値を高めています。
段階的な学習カリキュラム
事前学習は約4.19兆トークンで、0.99兆トークンの第1段階と3.20兆トークンの第2段階に分かれます。その後の中間学習が約6005億トークンで、コンテキスト長を16K、64K、256Kと3段階に広げていきます。64K段階では長短の系列を混ぜ、256K段階では超長文、文書横断の情報、長い手順を踏むエージェントの軌跡を加えます。
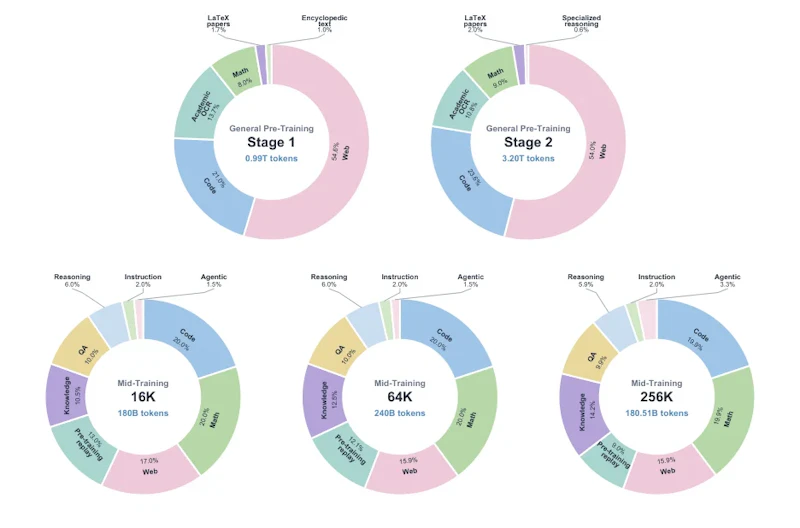
図6が示すとおり、配合は汎用能力を広く覆う構成から、後段で推論とエージェント寄りへ重心を移す形になっています。中間学習ではエージェントの対話記録をマルコフ決定過程(状態と行動の連なりとして意思決定を表す枠組み)の状態と行動に組み替え、1手ごとの密な教師信号に変換します。
事後学習は490万件の教師ありデータでの学習と、GRPOによる強化学習で構成されます。思考モードと非思考モードを混ぜて学習し、数学は正誤の二値、コードはテスト通過率で報酬を与えています。教師ありデータの候補を半分に刈り込んだ方が性能が上がったという知見は、量より質という主張の具体例です。
ベンチマーク結果
結果は領域によって性格が異なります。数学や推論では同じ7Bから8B規模の強力な蒸留モデルとの比較が中心で、ウェブ調査タスクでは桁違いに大きいモデルが比較対象に並びます。
ベンチマーク | ZGCM-1-7B | 比較モデル |
|---|---|---|
MATH-500 | 97.13% | 96.32%(DeepSeek-R1-0528-Qwen3-8B) |
AIME 2026 | 75.00% | 69.17%(同) |
AIME 2025 | 73.33% | 75.21%(同) |
HMMT 2025 | 70.42% | 61.50%(同) |
GPQA-Diamond | 47.87% | 60.10%(同) |
MMLU | 73.88% | 82.09%(同) |
WebWalkerQA | 63.09% | 59.60%(Qwen3-235B-A22B) |
BrowseComp | 19.43% | 2.30%(Qwen3-235B-A22B) |
GAIA(テキストのみ) | 42.52% | 45.60%(Qwen3-235B-A22B) |
数学系では同規模帯の蒸留モデルを多くの項目で上回り、AIME 2026で5.8ポイント、HMMT 2025で8.9ポイントの差をつけています。ただしAIME 2025では下回っており、全勝ではありません。
ウェブ調査では、WebWalkerQAでKimi-K2の63.00%やClaude 4 Sonnetの61.70%と肩を並べ、BrowseCompではQwen3-235B-A22Bの2.30%を大きく引き離しました。一方でGAIAはQwen3-235B-A22Bにわずかに届かず、Claude 4 Sonnetの68.30%とは開きがあります。
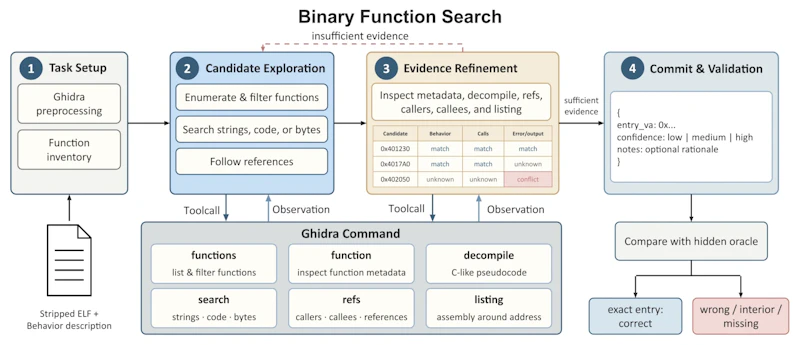
独自タスクのBinary Function Searchは、シンボルを削ったELFバイナリから、挙動の記述だけを頼りに目的の関数を突き止める課題です。図12のようにGhidraの操作を繰り返して候補を絞り、隠された正解と照合します。ZGCM-1-7Bは50問で62%、Qwen3-8Bは12%で、GLM-5.1の66%やDeepSeek-V4の76%には及びませんが規模差を踏まえれば健闘した数字といえます。
残る弱点
論文は限界を4点あげています。第1に、7.39Bという密モデルの規模が静的な知識量の上限を決めてしまい、閉じた状態での知識想起は苦手です。表のMMLUやGPQA-Diamondで8B級の蒸留モデルに劣る結果は、この制約を素直に反映しています。
第2に、重い推論の教師信号が冗長さを招き、思考を使わない厳密な指示追従をわずかに損なうこと。第3に、リポジトリ規模の開発作業や自由度の高い端末操作では成績が伸びないこと。第4に、観測のノイズ、ツール呼び出しの書式のずれ、検索APIの遅延といった環境の揺らぎに弱いことです。
開発体制についても、エージェントに任せられる度合いはタスク依存だと整理されています。実験の運用や配備では高い自律度に達する一方、アーキテクチャや学習アルゴリズムの設計判断は人間が握る段階にとどまるという報告です。
まとめと今後の展望
ZGCM-1の貢献は、7B規模で何がどこまで届くのかを数値と手順の両面で示したことにあります。エージェント検索のように外部情報を取りに行く課題では、モデルの大きさよりも学習データの組み立て方と手順の設計が効くという見立てを、公開物によって検証可能な形で提示しました。
反面、知識量の壁と環境の揺らぎへの弱さは規模とデータの設計に由来するもので、簡単には解消しません。中間チェックポイントと段階別レシピが手に入る以上、どの段階でどの能力が立ち上がるのかを外部の研究者が追試できる点が、この公開の実質的な価値になるでしょう。
論文情報: "ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search"(Jiyan He et al., 2026) arXiv:2609.13356, CC BY 4.0
本記事の図(図2、図6、図12)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


