 AI-Papers
- 過去の探索履歴(discovery tree)をそのままリプレイ用のシミュレータとして再利用し、探索方針を低コストで改善する枠組み
- 枝の選択、探索順序、並列数、打ち切り判断という4つの決定を、実行を一切やり直さずにオフライン評価できる
- アルゴリズム設計、数理最適化、GPUカーネル最適化の3領域で、既存手法と同等以上の発見品質を大幅に少ない生成回数で達成
発見エージェントの課題
コーディングエージェントに探索を任せ、アルゴリズムや数学的な構成を自動で発見させる研究が増えています。AlphaEvolve の系統に代表されるように、候補プログラムを大量に生成し、実際に動かして評価し、良いものを残す流れを何万回も繰り返すのが基本的な作り方です。
この方式の弱点は、1回の評価が高くつくことにあります。プログラムの生成にはモデル呼び出しが必要ですし、評価には実行時間の計測やベンチマークの実行が伴います。それにもかかわらず、どの枝を伸ばすか、何並列で回すか、どこで打ち切るかといった探索方針そのものは人手で決めた固定ルールのまま据え置かれてきました。
Google の研究チームが発表した Dream-RSI は、この探索方針を自己改善の対象に据えた枠組みです。改善のたびに高コストなオンライン試行を回すのではなく、すでに手元にある探索履歴を使い回すという発想で、探索の効率化と計算コストの削減を同時に狙っています。
探索履歴を環境にする
Dream-RSI は3つの段階からなるループで動きます。まず現在の探索方針がコーディングエージェントを導き、discovery tree と呼ばれる木構造を広げながら実行履歴を記録します。次にその木を凍結し、再利用可能なシミュレータの集合に変換します。最後にエージェントが頭の中で大量の代替方針を「夢想」し、シミュレータ上で高速に試して方針を更新し、改善後の方針を次のオンライン探索へ投入します。
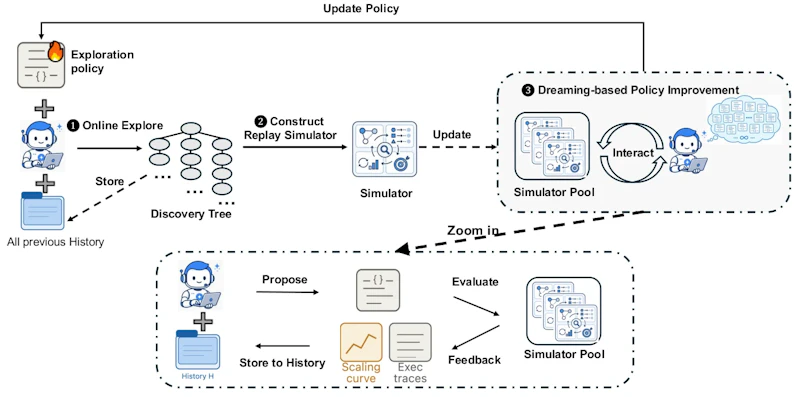
図1に示すように、更新された方針がふたたびオンライン探索に戻る循環構造になっています。木の各ノードには、親から引き継いだ作業履歴、生成された成果物と評価スコア、ファイルシステムの状態、診断フィードバックといった実行結果が丸ごと保存されます。
こうして凍結された木の上では、次の4種類の決定を再現実行なしで差し替えて試せます。
- 枝の選択、すでに展開済みのどのノードをたどるか
- 探索順序、複数の枝をどの優先度で進めるか
- 並列度、1回の決定ラウンドで何ノードをまとめて投入するか
- 打ち切り規則、どの時点で探索を止めるか
いずれも過去に観測済みの結果を参照するだけで済むため、評価コストは木をたどる処理だけになります。
夢の中で方針を試す
図2は、1回の高コストなオンライン探索が、実行コストゼロのオフポリシー評価を数千回分生み出す様子を表しています。方針候補はシミュレータ内で仮想的に探索を進め、到達した部分木のスコアが結果として返ってきます。
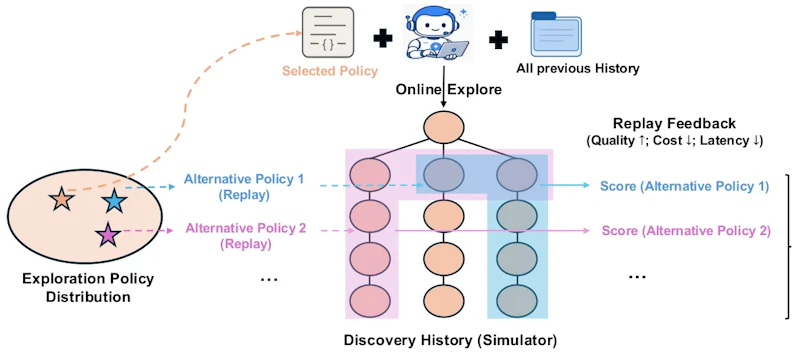
オフラインの報酬は、到達できた部分木の最高スコアから探索したノード数に応じたコストの罰則を引き、決定ラウンドあたりの並列度に応じたボーナスを加える形で定義されています。発見の質と計算コスト、並列効率の3つを同時に考慮する設計です。各方針は過去に蓄積した複数の木すべてで評価され、平均スコアが最も高いものが次のオンライン探索に採用されます。
興味深いのは、履歴の使い方に関する比較です。履歴を意味的なヒント(どの方向を探せばよいかを示すプロンプト)として与える方式は、リプレイ環境として使う方式に一貫して劣りました。著者らは、強い意味的な誘導が多並列探索の空間を絞り込みすぎ、逐次的な計算量は減るものの多様性が失われるためだと説明しています。探索方針の改善を強化学習として扱う考え方は、ESRLのようなエキスパート選択の揺らしによる探索強化とも通じる部分があります。
3領域での実験結果
評価はアルゴリズム設計、数理最適化、GPUカーネル最適化の3領域で行われました。アルゴリズム設計では Lasso の正則化パス求解器を発見する課題を扱い、17件の合成インスタンスで学習して6件の未知データセットで検証しています。
領域 | 課題 | 主な結果 |
|---|---|---|
アルゴリズム設計 | Lasso 求解器(Gemini-3.1-Pro) | 平均実行時間 3,587ms → 2,931ms、エージェント呼び出し 317回(固定方針は550回) |
アルゴリズム設計 | Lasso 求解器(Gemini-3.7-Flash) | 2,517ms → 2,351ms、呼び出し 1,879回(固定方針は3,200回) |
数理最適化 | Sum-Difference 問題 | 1.145427(SimpleTES の 1.143975 を上回る) |
数理最適化 | Circle Packing(n=26, 32) | 2.635983 で最強ベースラインと同水準 |
GPUカーネル | VGG16 / LayerNorm | 同等性能を 2.43倍 / 1.79倍 少ない生成回数で達成 |
GPUカーネル | ConvDiv / ConvMax | 同一予算で 2.09倍 / 1.44倍 のスコア |
数理最適化の比較対象である SimpleTES は51,200世代を消費しますが、Dream-RSI は1,000世代未満で同等水準に到達しました。およそ50分の1の予算です。発見された Lasso 求解器は、strong rule によるスクリーニングとコーシー・シュワルツ不等式に基づく KKT 条件の枝刈り、勾配の選択的再計算を組み合わせたもので、人間の実装にも通用する内容になっています。
限界と今後の展望
探索の軌跡を追うと、Dream-RSI は2周目から固定方針と明確に分岐し、進捗が出ているうちは計算を温存し、頭打ちになると投入量を増やすという適応的な振る舞いを見せました。探索のトレードオフを方針として学習できている兆候だと言えます。
一方で課題も残ります。リプレイシミュレータはあくまで過去に観測済みのノードしか再生できないため、木が小さい段階では評価できる方針の幅が限られます。木が巨大化したときに再生の忠実度や計算量がどうなるかについて、論文は踏み込んだ分析を示していません。方針とエージェントが密に結合し、その場のフィードバックで行動を変える必要がある領域への一般化も未検証です。
とはいえ、高コストな実行結果を捨てずに探索方針の学習資源として使い切るという着想は素直で、既存の発見エージェントの上に乗せやすい構造をしています。探索予算が支配的なコストになりつつある自動発見の分野では、実用面での影響が大きい方向性でしょう。
論文情報: "Dream-RSI: Recursive Self-Improvement through Evolving Worlds"(Tong Zheng et al., 2026) arXiv:2609.14858
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


