 AI-Papers
- 強化学習の最大のボトルネックであるロールアウト生成をFP4化し、128Kトークン出力時に最大5.4倍のデコード速度を達成
- ロールアウト側の量子化結果で学習側の丸め方向を決める「ロールアウト誘導型QAT」により、学習と生成の実行経路のずれを直接縮小
- 重み・活性化・KVキャッシュをすべてFP4にしてもBF16同等のRL性能を保ち、4種の大規模MoEで検証
研究の背景
大規模言語モデルの後学習では、強化学習(RL)が推論能力やコーディング能力を引き上げる主要な手段になっています。ところがRLの1ステップは、モデル自身に長い応答を生成させる「ロールアウト」から始まります。この生成処理が計算時間とメモリの大半を占めており、学習全体の進み方を決めてしまう状況です。
そこで自然に出てくる発想が、ロールアウトだけを低精度で回すというものです。FP4(4ビット浮動小数点)まで落とせばメモリ帯域が大幅に減り、生成は速くなります。特にMixture-of-Experts(MoE、入力ごとに一部の専門家ネットワークだけを使う構成)は総パラメータが巨大なため、低精度化の恩恵が大きい構造です。MoEの推論コストの低さはReflection AIがオープンウェイト「Beam」公開、推論コスト3〜4分の1でも触れられており、低精度化と組み合わせる余地があります。
Qwenチームによる本論文は、このFP4ロールアウトを実用水準に引き上げる枠組み TRACE(Train-Rollout Quantization Alignment via Compact GuidancE) を提案しました。既存のFP4 RL手法が抱えていた、ある見落としに狙いを定めた研究です。
学習とロールアウトの不一致
RLでは、生成を担うロールアウト経路と、勾配を計算する学習経路という2つの実行パスが存在します。従来のFP4 RL手法は、それぞれの経路で量子化誤差を個別に小さくしようとしてきました。論文が指摘するのは、本当に問題なのは各経路の精度ではなく2つの経路の出力がずれることだという点です。
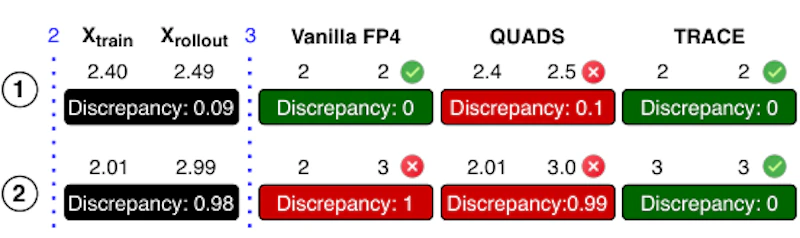
ずれが生じる仕組みは単純です。FP4では表現できる値(コードワード)が極端に少ないため、ほぼ同じ活性化値でも丸め境界の両側に落ちると別の値に化けます。論文の例では、2.40と2.49というわずかな差が、丸めによって2と3という異なるコードワードに分かれます。この離散的な飛びがネットワークの層を通るうちに増幅され、生成した行動と学習時に評価する確率の食い違いになっていきます。
図3は、通常の最近傍丸めで不一致が生じる場面と、ロールアウト誘導型の丸めがそれを解消する場面を並べたものです。同じ値でも丸めの決め方次第で結果が変わることが読み取れます。
TRACEの仕組み
TRACEの中心は、学習側の丸めをロールアウト側に合わせにいく点です。ロールアウト中に各量子化地点で実際に選ばれたコードワードの情報を記録しておき、学習側では最近傍に丸めるのではなく、記録された値に最も近い隣接コードワードを選びます。候補は上下2つの隣接値に限られるため、選択は軽い比較演算で済みます。
逆伝播にはstraight-through estimator(量子化の段差を無視して勾配を通す近似手法)を使い、選ばれた量子化値を経由して勾配を流します。これにより、量子化を意識した学習(QAT)の枠組みを保ったまま、丸めの決定だけがロールアウトに追従する形になります。最適化アルゴリズム側で重要度比の補正を加える既存手法とは異なり、不一致が生まれる現場そのものに手を入れる設計です。
量子化情報キャッシュ
素直に実装すると、ロールアウトの全量子化情報を保存して学習側へ送る必要があります。論文の見積もりでは、これは1 RLステップあたり51TBに達する通信量で、現実的ではありません。TRACEはここを2つの観察で削ります。
1つは、不一致の99%以上が隣接するコードワード間でしか起きないという点です。したがって完全な値ではなく仮数(mantissa)とスケールだけを送れば、望ましいコードワードを特定できます。もう1つは、より小さいコードワードへの丸め修正が深い層に集中しているという観察で、これを根拠にモデルの後半の層だけを対象にしています。結果として、保持する情報量は約6分の1に圧縮されました。
この削減がどこまで許されるかは追加実験で確かめられています。40層すべてに1ビットの仮数情報を持たせた場合の平均スコアは75.8で、深い20層に絞っても低下はわずかでした。一方で10層では74.1、5層では73.4まで下がり、層の選び方が効いていることが示されています。RL学習全体に対する追加コストは1ステップあたり7.4%の増加に収まりました。
実験結果
評価にはQwen3.5-35B-A3B、Qwen3.5-122B-A10B、Qwen3.8-Flash-Next(125B総パラメータ、6B活性)、Qwen3.8-2.4T-A95Bという4つのMoEモデルが使われ、推論、コーディング、長期ホライズンのRLタスクが対象になりました。量子化形式はNVFP4を主軸に、MXFP4でも検証しています。
Qwen3.5-35B-A3Bの結果が分かりやすい比較になっています。重みと活性化をNVFP4にした条件で、従来のQATは平均71.1、QUADSは72.9とBF16ロールアウトの74.9に届きませんが、TRACEは75.4でBF16と並びました。BF16で学習した方策を後から量子化する手法群(vanilla NVFP4、4over6、H-Scale)はいずれも70から71台にとどまり、学習時点でFP4を織り込む利点が出ています。
手法 | LiveCodeBench | AIME24 | AIME25 | HMMT25 | 平均 |
|---|---|---|---|---|---|
BF16ロールアウト | 67.1 | 83.8 | 81.3 | 67.5 | 74.9 |
QAT(NVFP4) | 63.5 | 81.7 | 78.8 | 60.4 | 71.1 |
QUADS(NVFP4) | 64.8 | 83.3 | 80.4 | 62.9 | 72.9 |
TRACE(NVFP4) | 67.1 | 83.1 | 82.1 | 69.4 | 75.4 |
事後量子化(vanilla NVFP4) | 63.9 | 75.7 | 78.4 | 63.4 | 70.4 |
事後量子化(H-Scale) | 65.5 | 82.0 | 77.8 | 60.1 | 71.4 |
MXFP4でも同じ傾向が確認され、W4A8設定で69.0から75.1、W4A4設定で67.2から73.5へと改善しました。KVキャッシュだけをFP4にした条件でもTRACEは74.8で、重み・活性化・KVキャッシュを同時にFP4化する組み合わせが最も難しいことが切り分けられています。
速度面では、128Kトークン出力時にBF16ロールアウト比で最大5.4倍のデコードスループットを記録しました。量子化情報の収集を加えても、素のFP4ロールアウトに近い速度を各出力長で維持しています。長期ホライズンのタスクでは、2.4TパラメータのQwen3.8-2.4T-A95Bを256Kトークンの文脈長で50ステップ学習させ、GDPvalで90.2を獲得しました。BF16ロールアウトの90.3とほぼ同じ水準です。
課題とまとめ
TRACEは、低精度RLの議論を「各経路をどれだけ正確に量子化するか」から「2つの経路をどう揃えるか」へ移した点に特徴があります。丸め方向の選択という局所的な操作と、深い層に限った軽量なキャッシュという実装上の工夫が組み合わさり、速度と性能の両取りが成立しています。
一方で、検証されているのはQwen系のMoEに限られており、密なTransformerや小規模モデルへの一般性は示されていません。ロールアウトの量子化情報を学習側へ届ける通信経路が必要なため、学習フレームワークの作りに手を入れる負担も残ります。方策の鮮度に関するハイパーパラメータへの感度についても、論文は明示的に整理していません。
とはいえ、重み・活性化・KVキャッシュをすべて4ビットにしてもRLの到達点が落ちないという結果は、後学習のコスト構造に直接響きます。学習と生成の精度を揃えるという視点は、FP4に限らず今後の低精度学習の設計で参照されていく可能性があります。
論文情報: "TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models"(Xin Wang et al., 2026) arXiv:2610.07767
本記事の図(図3)は解説のため上記論文より引用しています。


